
MM-Hallu/CAST
收藏官方服务:
资源简介:
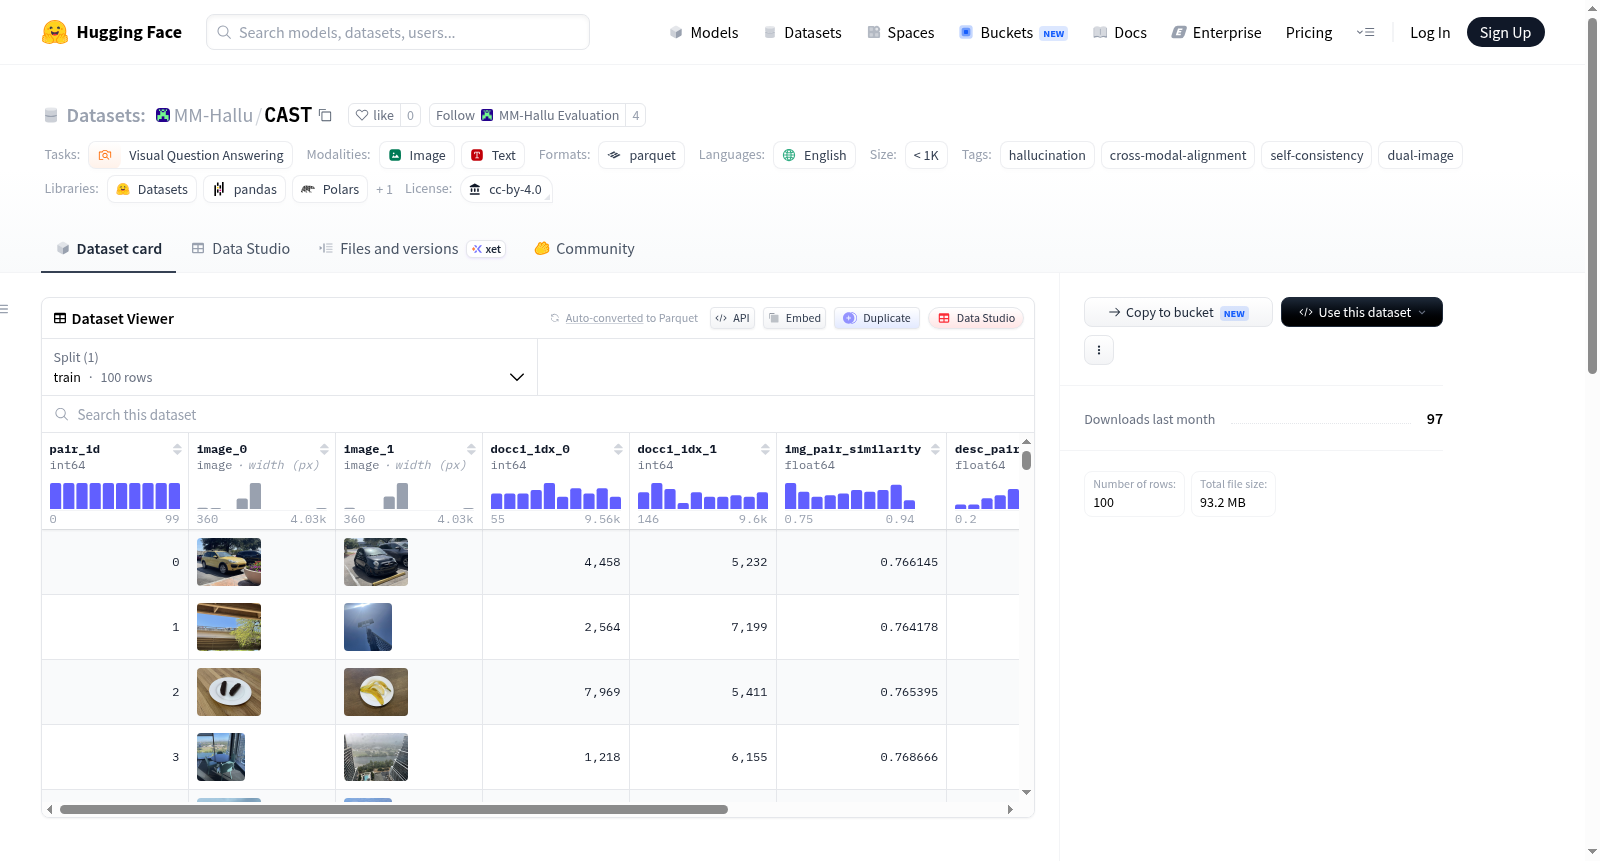
CAST(跨模态对齐相似性测试)是一个用于视觉语言模型的数据集,包含100对从DOCCI子采样的图像。每对图像在视觉上相似但文本描述不同,旨在测试模型在文本、图像和跨模态输入上的自一致性。数据集包含图像对ID、图像、DOCCI索引、图像和描述对的相似度以及详细描述等特征。评估任务是通过不同模态识别场景相似性,使用自一致性率作为指标。
CAST (Cross-modal Alignment Similarity Test for VLMs) is a dataset containing 100 image pairs sub-sampled from DOCCI. Each pair consists of visually similar but textually distinct images, designed to test self-consistency across text-only, image-only, and cross-modal inputs in vision-language models. The dataset includes features such as pair IDs, images, DOCCI indices, image and description pair similarities, and detailed descriptions. The evaluation task involves identifying scene similarities via different modalities, using self-consistency rate as the metric.
提供机构:
MM-Hallu搜集汇总
数据集介绍
构建方式
CAST数据集源于DOCCI,从中精心筛选了100对视觉相似但文本描述截然不同的图像对,旨在构建一个用于评估视觉语言模型跨模态对齐自洽性的基准。每对图像均配备详尽的文字描述,并利用CLIP模型分别计算图像嵌入与文本描述之间的余弦相似度,为后续分析提供了量化依据。该数据集的构建过程严谨,通过人工与自动方法相结合的方式,确保了图像对在视觉上的近似性和语义上的差异性,从而能够有效测试模型在不同模态输入下的一致性表现。
特点
CAST数据集的核心特色在于其聚焦于视觉语言模型的自洽性评估,通过设计text-only、image-only及cross-modal三种输入模式,系统性检测模型在理解相似场景时是否存在模态间的语义偏移或幻觉现象。每对图像共享近似的视觉内容,但其描述蕴含独特的细节,这种微妙的对比设计使得数据集能够精准揭示模型在跨模态推理中的脆弱点。此外,数据规模虽小(100对),但针对性强,为深入研究多模态对齐问题提供了高质量且易于复现的测试平台。
使用方法
在使用CAST数据集时,研究者应针对每一图像对,分别以纯文本(仅提供描述)、纯图像(仅提供视觉输入)以及双模态(同时呈现图像与描述)等方式向模型提问,要求其识别两场景间的相似性。模型的输出结果将通过自洽率(self-consistency rate)进行量化评估,该指标衡量模型在不同模态下回答的一致性程度。该数据集特别适用于验证与改进视觉语言模型在减少跨模态幻觉和提升语义对齐方面的性能,其评估流程简洁明了,便于集成到现有模型评测管线中。
背景与挑战
背景概述
在多模态大模型(VLMs)蓬勃发展的背景下,视觉语言对齐与自洽性问题成为制约其可靠性的核心瓶颈。CAST数据集于2024年由研究团队提出,其设计初衷源自对现有视觉问答(VQA)基准的深刻反思——传统评估多侧重于单模态或简单跨模态任务,难以揭示模型在细粒度场景理解中存在的感知偏差与语义混淆。该数据集从DOCCI中精心筛选100对视觉相似但语义迥异的图像,每对包含高分辨率的成对图像及其精确文本描述。通过构建仅文本、仅视觉及跨模态三种评估通路,CAST旨在系统性检测模型对外观相似性、文本区分性及跨模态一致性的表征能力。这一原创性设计不仅为VLMs的幻觉现象提供了量化工具,更推动了多模态对齐研究进入更精密的诊断阶段,对后续模型架构优化与训练策略调整具有重要指导价值。
当前挑战
CAST数据集直面当前VLMs在细粒度场景理解中的三重挑战。其一,模型需在文本仅模式下,仅凭描述性文本区分视觉上几乎一致的图像对,这考验其对语言细微差异的捕捉能力。其二,在图像仅模式下,模型需无视高视觉相似度而识别出语义层面截然不同的场景,直击视觉表征的区分性瓶颈。其三,跨模态一致性挑战要求模型在同时获得图文信息时,整合结果应与各自独立推理保持一致,从而揭示模态间是否存在信息冲突或特征稀释。构建过程中,研究团队需克服从DOCCI庞大数据源中精准筛选视觉相似对的主观性难题,并设计严谨的文本描述相似性计算流程以量化语义距离,确保每对样本对模型构成有效且无偏的诊断压力。
常用场景
经典使用场景
在视觉语言模型(VLM)的评估领域中,CAST数据集以其独特的跨模态对齐一致性测试设计脱颖而出。该数据集精心构建了100对视觉相似但文本描述迥异的图像对,源自DOCCI数据集,专门用于探究模型在纯文本、纯图像及跨模态输入下的自我一致性。研究者通常利用CAST来系统性地检测VLM在面对细微视觉差异时的敏感性,评估其是否会在不同模态间产生不一致的响应。这一经典使用场景不仅揭示了模型对多模态信息的鲁棒理解能力,也为后续开发更为可靠的对齐算法奠定了实验基础。
实际应用
在工业界的实际部署中,CAST数据集为多模态系统的可信度验证提供了重要的测试工具。例如,在自动驾驶场景理解、医学影像报告生成以及视觉辅助设备等领域,模型若在跨模态解释中出现歧义或矛盾,可能引发严重后果。通过应用CAST,开发者可以精准识别模型在面对视觉相似样本时的输出波动,从而优化模型在关键信息捕捉、描述一致性保持等方面的表现。该数据集还助力于构建更为稳定的多模态对话系统,确保在用户交互中视觉与语言信息的高度统一,提升人工智能产品的安全性与用户体验。
衍生相关工作
自CAST数据集问世以来,已催生了一系列与之相关的研究工作。其中,基于自一致性度量的鲁棒性评估框架被广泛应用于多模态预训练模型的纠偏中,衍生出诸如“多视角文本-图像对齐正则化”等方法。一些后续工作还借鉴了CAST的对比图像对设计思路,构建了更大规模的跨模态一致性测试集,用于系统分析大语言模型在多图理解中的推理缺陷。此外,CAST所引入的跨模态对齐相似度指标,亦被重新应用于面向视觉故事生成与细粒度图像检索的自洽性评价中,形成了新的评估范式,加速了视觉语言模型从粗粒度识别向精细节语义理解的演进。
以上内容由遇见数据集搜集并总结生成


