
遇见数据集

nb-asr-qwen3whisperxagreement-v1

收藏
Hugging Face2026-06-05 更新2026-06-06 收录
官方服务:

资源简介:

nb-asr-qwen3whisperxagreement-v1 是一个专门为挪威语语音设计的词级强制对齐训练数据集。该数据集通过高一致性过滤机制构建:从NB-ASR挪威音频语料库中提取语音片段,仅保留那些由两个独立的强制对齐系统——WhisperX与基于Qwen3的Lunde对齐器——在严格的时间容差内达成对齐一致的样本。具体过滤标准包括:每个词的起始时间差不超过2帧(≤160毫秒),结束时间差不超过5帧(≤400毫秒),且两个系统的词数必须完全一致。经过过滤,从1,637,091个候选样本中最终保留了702,067个高置信度样本(通过率约42.9%)。每个数据样本是一个JSON对象,包含唯一标识符(id)、16 kHz单声道WAV音频文件的绝对路径(audio)、与<timestamp>占位符令牌交织的单词文本(text),以及对应的帧索引标签列表(labels)。时间戳以80毫秒为分辨率的整数帧索引表示,与对齐过程中使用的特征帧率相匹配。数据集格式专为训练预测时间戳的序列模型(例如对Qwen3进行微调)而设计,其中labels字段使用-100标记单词位置,用具体的开始和结束帧索引标记<timestamp>位置,实现了文本与标签的逐令牌对齐。该数据集适用于需要从音频中预测精确词级时间戳的自动语音识别(ASR)相关任务,特别是采用<timestamp>令牌方案的模型监督微调,其双重对齐验证机制提供了比单一对齐源更可靠的地面真值边界。音频源自在挪威广播和议会语音上收集的NB-ASR语料库。数据集采用知识共享署名4.0国际许可协议(CC BY 4.0)。

创建时间:
2026-06-05
原始信息汇总

数据集概述:nb-asr-qwen3whisperxagreement-v1

nb-asr-qwen3whisperxagreement-v1 是一个用于挪威语音的词级强制对齐训练数据集,由两个独立对齐系统(WhisperX 和 Qwen3)达成一致的语言片段构成。

数据集规模与来源

  • 总样本数:702,067 个语音片段
  • 语种:挪威语(nb / no)
  • 许可协议:Creative Commons Attribution 4.0 International (CC BY 4.0)
  • 原始音频来源:NB-ASR 挪威语广播与议会语音语料库,16 kHz 单声道 WAV 格式

数据构建方法

两个强制对齐系统独立对相同音频进行对齐:

系统 数据源
WhisperX whisperx_pseudo_labels/output/all_whisper_raw.jsonl
Qwen3 (Lunde aligner) lunde_alignment_results/verbatim/all.jsonl

筛选条件:将两个系统的对齐结果转换为 80 ms 帧索引后,仅保留满足以下条件的样本:

  • 每个单词的起始帧差异 ≤ 2 帧(≤ 160 ms)
  • 每个单词的结束帧差异 ≤ 5 帧(≤ 400 ms)
  • 单词数量一致

筛选结果

结果 数量
候选总数 1,637,091
保留(达成一致) 702,067
拒绝 – 结束帧超差 427,575
拒绝 – 起始帧超差 87,503
拒绝 – 单词数量不一致 12,487

42.9% 的候选样本通过了一致性筛选。

数据格式

每条记录为 JSON 对象,包含四个字段:

字段 类型 描述
id string 唯一片段标识符(由音频文件名和时间戳派生)
audio string 16 kHz 单声道 WAV 文件的绝对路径
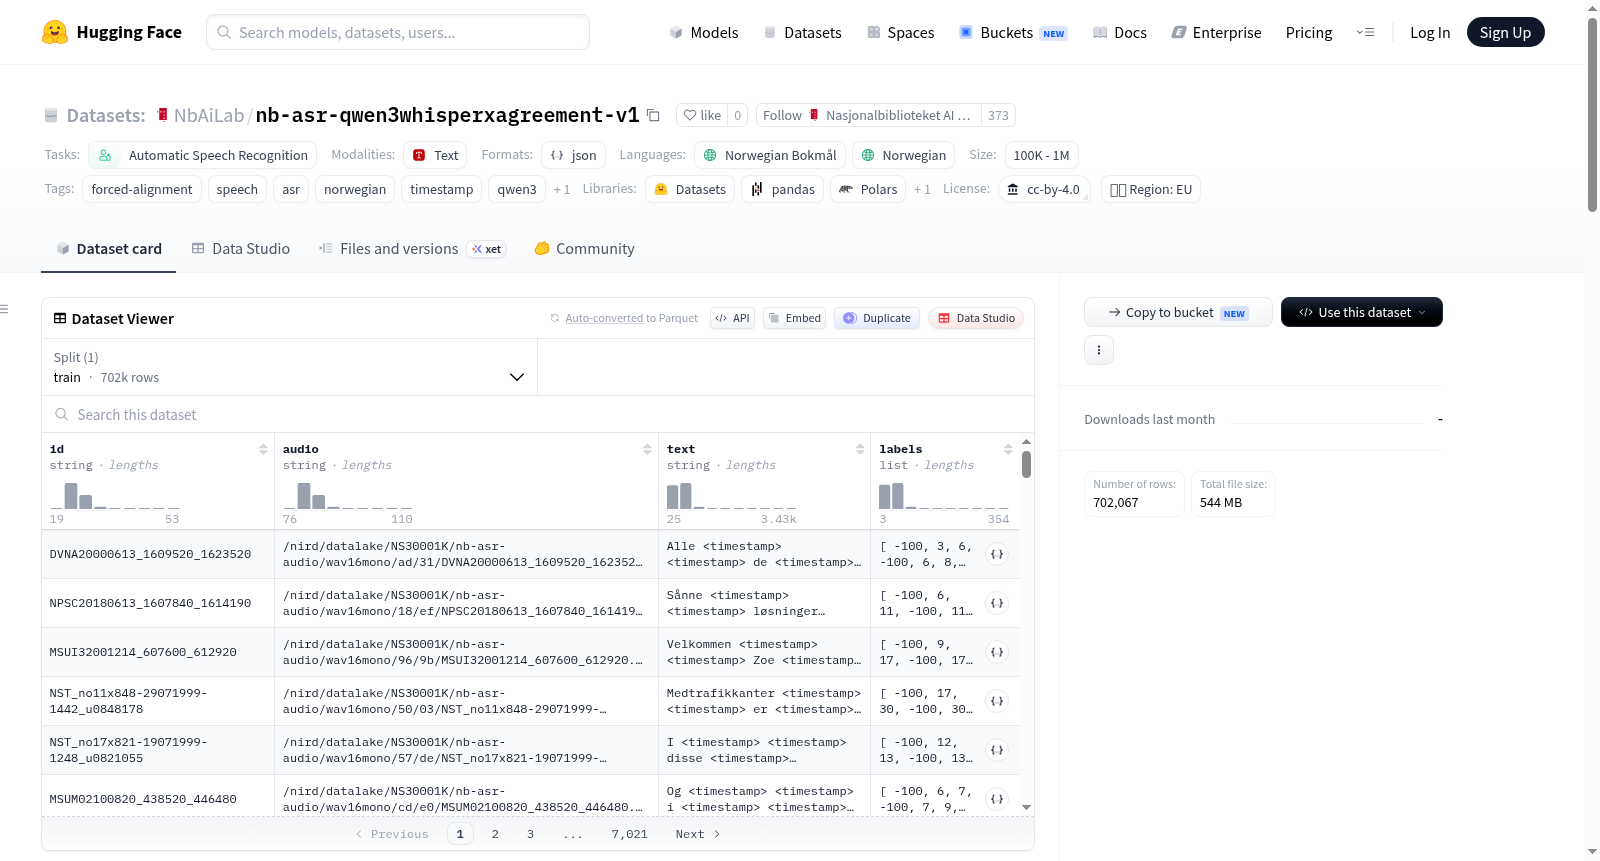
text string 文本,单词与 <timestamp> 占位符交错
labels list[int] 帧索引标签,-100 表示忽略(单词位置),<timestamp> 位置为起始与结束帧

示例记录: json { "id": "DVNA20000613_1609520_1623520", "audio": "/nird/datalake/NS30001K/nb-asr-audio/wav16mono/ad/31/DVNA20000613_1609520_1623520.wav", "text": "Alle <timestamp> <timestamp> de <timestamp> <timestamp> fem <timestamp> <timestamp> ...", "labels": [-100, 3, 6, -100, 6, 8, -100, 8, 11, ...] }

  • 时间戳以 80 ms 分辨率(12.5 帧/秒)表示
  • 帧索引 3 对应 3 × 0.08 s = 0.24 s

预期用途

该数据集适用于监督微调预测词级时间戳的序列模型(如 Qwen3 微调)。双重一致性筛选提供了比单个对齐器更高置信度的地面真值边界。
搜集汇总
数据集介绍
nb-asr-qwen3whisperxagreement-v1 数据集图片
构建方式
本数据集基于挪威语语音语料库NB-ASR构建,通过整合两套独立的强制对齐系统——WhisperX与Qwen3(Lunde强制对齐器)——的输出结果,筛选出二者在单词边界上高度一致的样本。具体而言,将两系统输出的单词起止时间统一转换为80毫秒分辨率的帧索引后,仅保留每个单词起始帧差异不超过2帧(≤160毫秒)、结束帧差异不超过5帧(≤400毫秒)的样本,并剔除词数不一致的记录。经过这一严格过滤,原始1,637,091个候选片段中最终保留702,067个高质量对齐样本,通过率约为42.9%。
使用方法
数据集以JSON格式存储,每条记录包含唯一标识符、16kHz单声道WAV音频路径、嵌入<timestamp>占位符的文本序列以及对应的帧索引标签序列。使用时,模型需将文本中的<timestamp>标记与标签列表中的起止帧索引对齐,其中非时间标记位置填充-100以忽略损失计算。该数据集最适合用于Qwen3等序列模型的微调,通过监督学习使模型掌握从音频信号中预测单词级时间戳的能力,也可作为评估其他挪威语强制对齐系统性能的标准参考基准。
背景与挑战
背景概述
随着自动语音识别(ASR)技术的迅猛发展,尤其是端到端模型在各类语言任务中取得突破,词级强制对齐(word-level forced alignment)作为连接声学特征与文本序列的关键环节,日益受到研究者关注。针对挪威语这一资源相对稀缺的语言,挪威国家图书馆(NB-ASR)与多家研究机构联合构建了nb-asr-qwen3whisperxagreement-v1数据集。该数据集于近期创建,核心研究问题在于如何利用双系统一致性筛选策略,生成高置信度的词级时间戳标注,以支持基于时间戳预测的序列模型(如Qwen3)的微调。通过整合WhisperX与Qwen3(Lunde强制对齐器)两种独立对齐系统的结果,并施加严格的对齐容忍度阈值,数据集在降低标注噪声方面展现了显著优势,为挪威语语音处理领域提供了可靠的训练基准,有力推动了低资源语言ASR及语音时间对齐技术的研究进展。
当前挑战
该数据集致力于解决挪威语ASR领域中词级时间戳标注不精确的领域难题。传统单对齐器方法常因声学变异性、音素边界模糊或长尾词汇而引入偏差,导致下游模型训练不稳定。其构建过程面临多重挑战:首先,需设计跨系统的对齐比较框架,将WhisperX与Qwen3的原始输出统一转换为80毫秒帧索引,确保坐标一致可比;其次,筛选阈值(起始帧≤2帧,结束帧≤5帧)需谨慎权衡——过于宽松则引入噪声,过于严格则丢弃大量有效样本——最终约57%的候选被拒,体现精细化权衡的复杂性;此外,处理单词计数不匹配(12,487例被拒)及跨系统异构错误模式,要求开发灵活的过滤逻辑,确保数据质量与规模之间的微妙平衡。
常用场景
经典使用场景
在语音处理与自然语言理解交叉领域中,词级强制对齐(forced alignment)是构建高质量语音转录与时间戳预测模型的基础环节。nb-asr-qwen3whisperxagreement-v1数据集专为训练能够从音频中精确预测每个单词起止时间戳的序列模型而设计,其独特之处在于融合了WhisperX与Qwen3(Lunde强制对齐系统)双对齐器的共识结果。研究者可将该数据集用于微调诸如Qwen3等架构,使其学习解析以<timestamp>占位符嵌入的文本序列,并输出对应的帧级时间标签。典型流程包括将音频与带占位符的转录文本配对,训练模型在80毫秒分辨率的帧索引上生成对齐预测,从而在单词级别实现高精度的语音与文本同步。
解决学术问题
该数据集核心解决了学术研究中语音对齐标注质量参差不齐与标签噪声累积的典型困境,特别是在低资源语言如挪威语的语音识别与对齐任务中。通过实施严格的双对齐器容差过滤——起始帧差异不超过2帧(160毫秒)、结束帧差异不超过5帧(400毫秒),以及剔除词数不一致样本——数据集将原始约163万候选样本中的高质量共识片段筛选至约70万条,约42.9%的通过率确保了训练标签的极高置信度。这一策略有效降低了单一对齐器系统固有偏差与误差的干扰,显著提升了时间戳预测模型训练数据的信噪比,为精确评估模型在细粒度时间定位上的泛化能力提供了可靠的基准,推动了语音对齐方法论在鲁棒性和一致性方面的进步。
实际应用
在实际应用中,nb-asr-qwen3whisperxagreement-v1数据集为广播与议会语音语料库的自动化处理开辟了高效路径,其原始音频来源于NB-ASR挪威语广播与议会语音语料库,覆盖了真实场景下的多说话人、噪声与语速变化。基于该数据集训练的模型可直接服务于字幕自动生成系统,实现单词级别的时间戳精确定位,提升字幕与语音的同步准确性;同时可用于交互式语音问答、有声书制作、口语评测工具中的逐词回放与可视化,以及刑事侦测或会议记录中的语音证据分析。此外,双对齐器共识机制所产生的高质量对齐数据,为低资源语言的语音识别引擎提供了宝贵的辅助训练信号,有助于改善远程会议、教育平台及无障碍工具中挪威语语音处理的实用效能。
数据集最近研究
最新研究方向
该数据集聚焦于挪威语语音识别中词级时间戳对齐的前沿研究,通过整合WhisperX与Qwen3(Lunde对齐器)两种独立对齐系统的共识,构建高置信度标注数据。在自动语音识别领域,时间戳预测是提升口语理解与多模态交互精度的关键瓶颈,而该数据集采用的双重一致过滤策略,有效规避了单系统对齐误差,为序列模型(如Qwen3微调)提供了更可靠的训练标签。这一创新方法呼应了近年来语音处理中对标注质量与鲁棒性的迫切需求,尤其在挪威广播与议会语音等复杂场景中,显著推动了细粒度语音事件检测与端到端时间戳建模的进步,为跨语言对齐技术树立了新标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

