
lmlab/basic-math-10m
收藏官方服务:
资源简介:
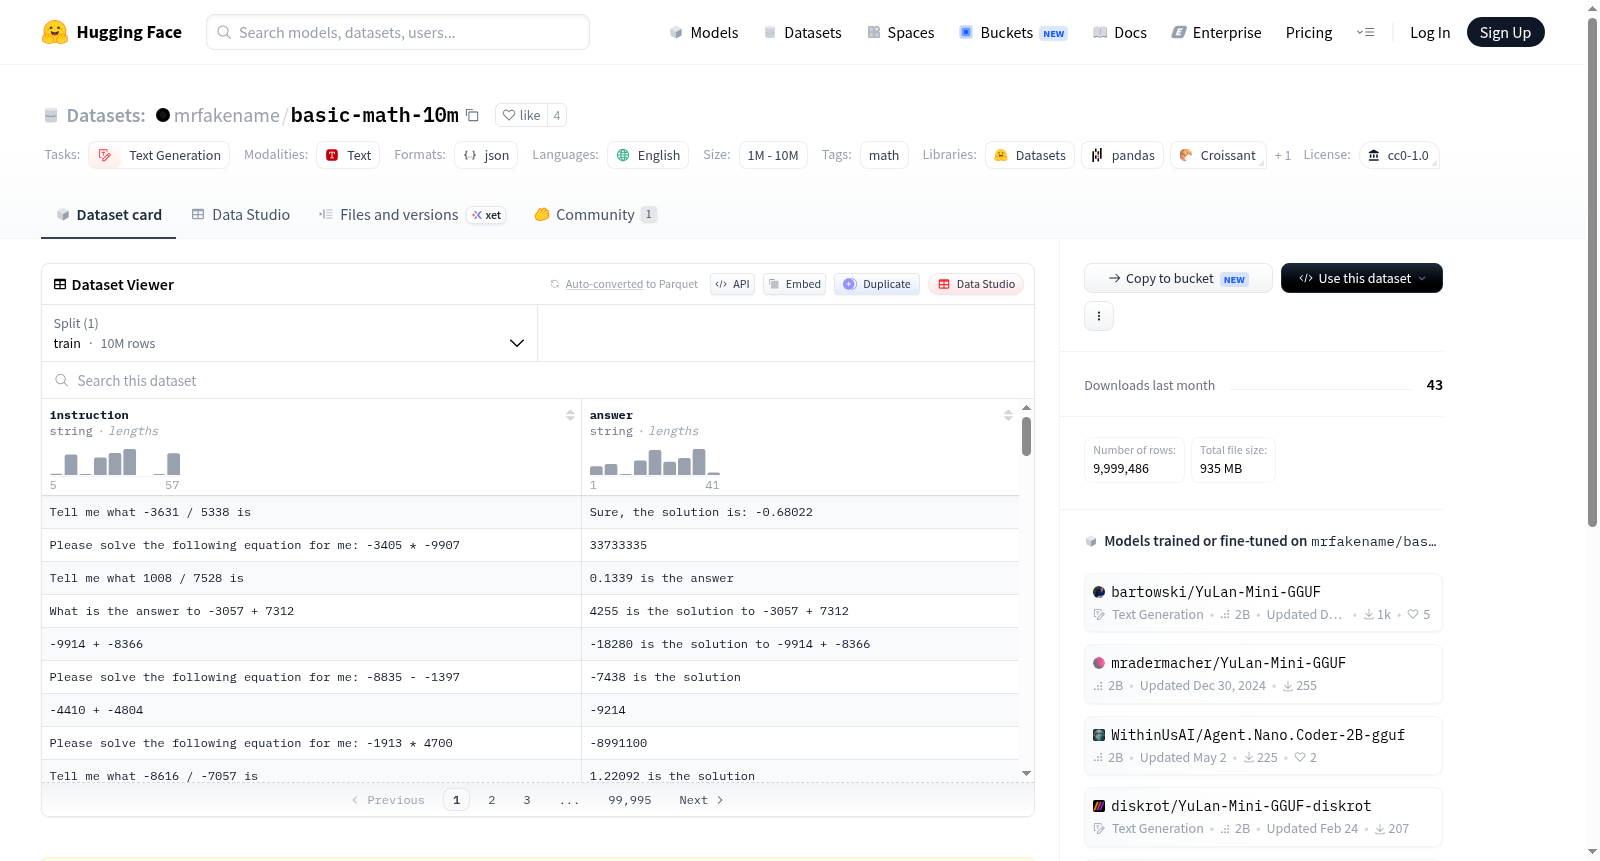
Basic Math 10M是一个包含1000万个基本算术问题的数据集,可能包含用户提示。它是Basic Math 1M的扩展版本。
Basic Math 10M是一个包含1000万个基本算术问题的数据集,可能包含用户提示。它是Basic Math 1M的扩展版本。
提供机构:
lmlab原始信息汇总
数据集概述
基本信息
- 名称: Basic Math 10M
- 任务类别:
- 文本生成
- 文本到文本生成
- 语言: 英语
- 标签: 数学
- 数据集大小: 10M<n<100M
- 许可证:
- CC-BY-SA-4.0
- GPL
详细描述
Basic Math 10M 是一个包含1000万个基础算术问题的数据集,包含潜在的用户提示。这是 Basic Math 1M 的扩展版本。
许可证
该数据集采用双重许可,用户可以选择 GNU GPL 许可证或 CC-BY-SA 4.0 许可证。如果需要将此数据集包含在其他不同许可的数据集中,请联系数据集创建者。
来源与灵感
Basic Math 10M 灵感来源于 Simple Math,但独立创建。
搜集汇总
数据集介绍
构建方式
在数学推理与语言模型交叉研究的蓬勃发展中,高质量算术数据集的构建成为提升模型数值计算能力的关键基石。lmlab/basic-math-10m数据集通过系统化生成策略,构建了包含一千万条基础算术问题及其对应用户提示的大规模语料库。该数据集是basic-math-1m的扩展版本,在继承其核心生成逻辑的基础上,将数据规模提升了十倍,从而为模型训练提供了更丰富的数值运算样本。每条数据均包含标准算术表达式与自然语言提示的配对,覆盖加减乘除等基本运算类型,确保了数据在多样性与规范性之间的平衡。
特点
该数据集在规模与结构上展现出显著优势。其一千万条的数据量使其成为当前最大的基础算术文本生成数据集之一,能够有效缓解模型在数值计算任务中的过拟合风险。数据采用text-generation与text2text-generation双任务标签,适用于多样化的训练范式。所有样本均以英文呈现,并遵循CC0-1.0许可协议,消除了版权壁垒,便于学术与工业界自由使用。此外,数据集的构建灵感来源于Simple Math项目,在问题设计的简洁性与提示的实用性上进行了精细化打磨。
使用方法
研究者可灵活调用该数据集进行数学推理模型的预训练或微调。在text-generation模式下,模型可基于算术问题生成逐步推理过程;在text2text-generation模式下,则适合训练端到端的计算器式问答系统。由于数据集以HuggingFace Datasets格式托管,用户可通过简单调用load_dataset('lmlab/basic-math-10m')实现快速加载。建议将数据按8:1:1比例划分为训练、验证与测试集,并配合tokenizer进行数值标记化处理。对于需要更高精度的场景,可结合few-shot学习策略,从数据集中采样典型示例构建提示模板。
背景与挑战
背景概述
在自然语言处理与数学推理的交汇领域,大规模、多样化的数学问题数据集对于训练和评估大型语言模型的算术能力至关重要。lmlab/basic-math-10m数据集应运而生,它是对Basic Math 1M的扩展版本,由研究团队在Simple Math数据集的启发下创建,旨在提供更海量的基础算术问题资源。该数据集包含超过1000万个基本算术问题及其对应的用户提示,覆盖了加、减、乘、除等核心运算,为模型在数值计算和简单逻辑推理方面的微调与评测提供了坚实基础。其发布显著推动了数学语言模型的发展,成为验证模型符号理解与运算准确性的重要基准之一。
当前挑战
该数据集所解决的领域问题在于,尽管大型语言模型在文本生成上表现优异,但在精确算术推理上仍存在系统性缺陷,特别是对多步运算和数值一致性处理的不足。Basic Math 10M通过提供大规模、结构化的算术问题,旨在缓解模型在基础数学任务上的不稳定性和幻觉现象。在构建过程中,挑战包括确保数据集的多样性与平衡性,避免运算类型与数值范围的偏斜;同时,生成10M级别的高质量、无噪声算术对需要高效的自动化脚本与严格的验证流程,以防止错误标签或重复样本干扰模型训练效果,这对数据清洗与质量控制提出了较高要求。
常用场景
经典使用场景
在数学推理与自然语言处理的交叉领域中,lmlab/basic-math-10m数据集凭借其千万级的基础算术问题规模,成为训练和评估语言模型数学能力的重要基准。该数据集涵盖了加减乘除等基础运算,并辅以多样化的用户提示,为模型提供了从简单计算到复杂逻辑链推理的丰富训练素材。研究者常利用该数据集微调预训练语言模型,使其掌握基本的数学符号操作与数值计算规律,从而在文本生成任务中实现精准的数学推导。
衍生相关工作
该数据集衍生了一系列经典工作,如基于其扩展版本开发的数学专用语言模型,以及针对算术推理的对抗训练方法。研究者还将其与符号计算引擎结合,提出混合推理框架,显著提升了复杂问题的求解准确率。此外,该数据集催生了数学能力评估基准,如MathQA和GSM8K的补充测试集,推动了数学推理领域模型性能的标准化比较与迭代优化。
数据集最近研究
最新研究方向
在当前大语言模型快速发展的背景下,数学推理能力作为衡量模型认知水平的关键指标,正受到学术界和工业界的广泛关注。lmlab/basic-math-10m数据集通过提供千万级别的基础算术问题与用户提示对,为模型在数值运算领域的微调与评估提供了坚实的数据基础。该数据集的前沿研究方向聚焦于如何利用海量结构化数学数据增强语言模型的逻辑推理与精确计算能力,尤其是在小样本学习与指令遵循场景中,这类数据集被视为突破模型数学泛化瓶颈的重要资源。与Simple Math等同类数据集相比,Basic Math 10M的规模优势使其能够支撑更大参数规模模型的训练,推动了从简单算术到复杂数学问题解决能力的迁移研究。其CC0许可协议也促进了开放科学合作,加速了数学推理领域的基础设施建设,对提升AI在教育和科研场景中的实际应用价值具有深远意义。
以上内容由遇见数据集搜集并总结生成


