
遇见数据集

JingweiNi/ocr2_hardest_questions_10k_k2_think_medium_vllm_direct_seed20260527_valid_suffix

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

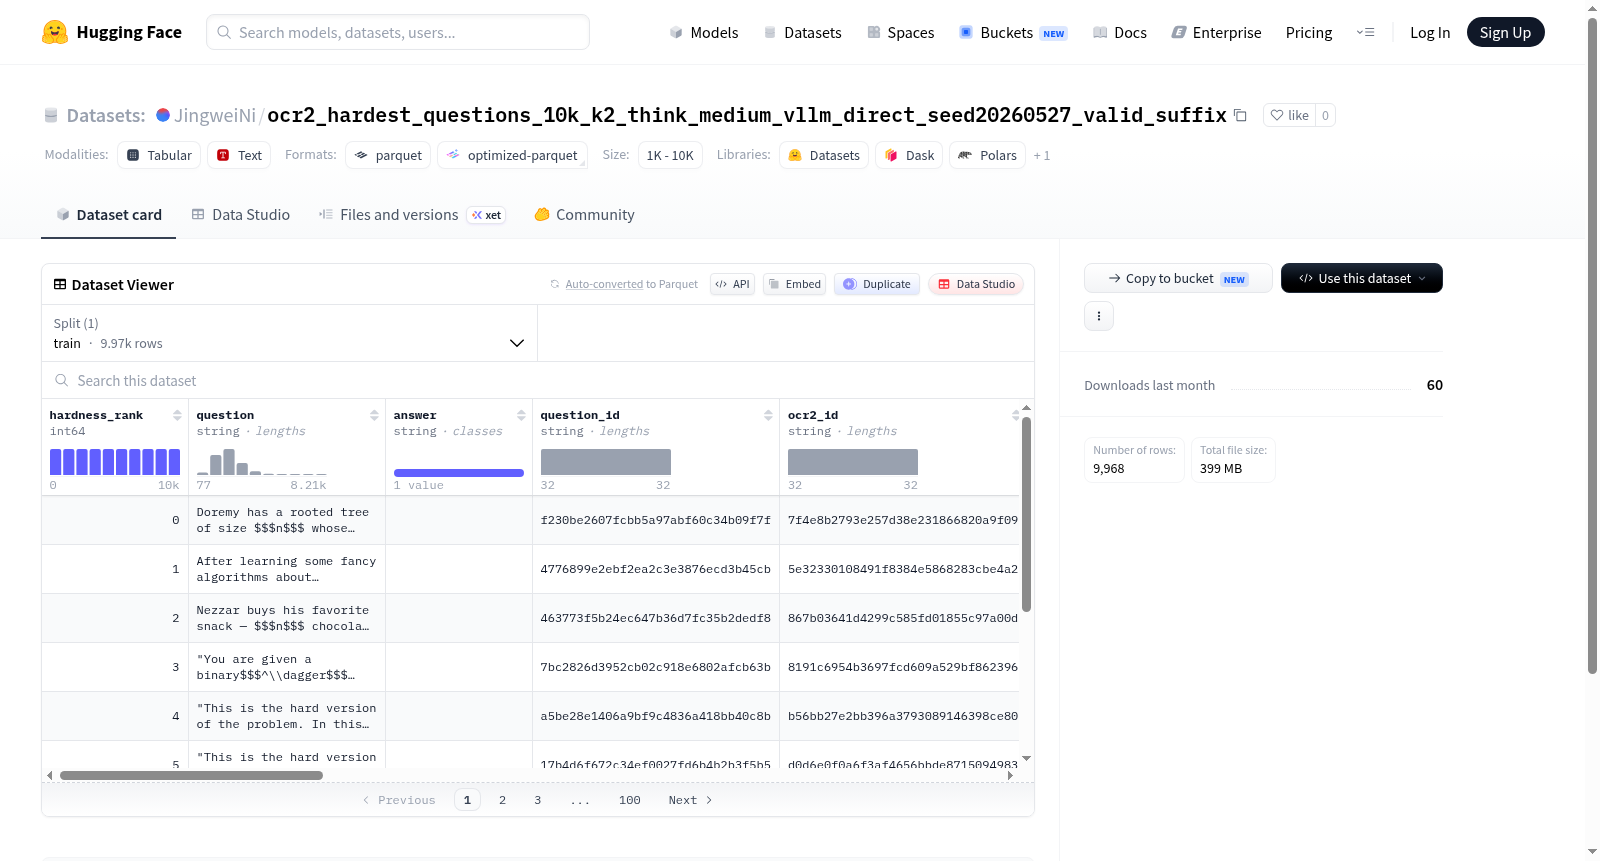
--- dataset_info: features: - name: hardness_rank dtype: int64 - name: question dtype: string - name: answer dtype: string - name: question_id dtype: string - name: ocr2_id dtype: string - name: language_split dtype: string - name: source_dataset dtype: string - name: source_split dtype: string - name: source_platform dtype: string - name: difficulty dtype: string - name: difficulty_score dtype: float64 - name: difficulty_score_type dtype: string - name: judgement dtype: string - name: pass_rate dtype: string - name: source_index dtype: string - name: sample_seed dtype: int64 - name: input_ids list: int32 - name: reply dtype: string - name: sample_idx dtype: int64 - name: original_index dtype: int64 splits: - name: train num_bytes: 836011715 num_examples: 9968 download_size: 398504326 dataset_size: 836011715 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
JingweiNi
搜集汇总
数据集介绍
JingweiNi/ocr2_hardest_questions_10k_k2_think_medium_vllm_direct_seed20260527_valid_suffix 数据集图片
构建方式
该数据集基于OCR2基准测试中的高难度题目构建,从原始题目池中筛选出难度排名靠前的10,000个问题,并通过k2-think-medium模型结合vLLM推理引擎直接生成答案。构建过程中采用了固定随机种子(seed=20260527)以确保可复现性,同时引入了有效的后缀处理机制来优化生成答案的质量。最终数据集包含9,968个训练样本,每个样本均包含了问题文本、参考答案、多维度难度评分以及模型生成的回复,确保了数据构建的严谨性与科学性。
使用方法
该数据集可直接用于语言模型的训练与评估,尤其适合于测试模型在复杂推理问题上的泛化能力。用户可通过HuggingFace Datasets库加载默认配置下的训练集,利用question与answer字段进行监督学习,或采用reply字段作为模型输出进行对比分析。同时,数据集中的input_ids字段提供了预标记化的输入序列,便于直接导入Transformer架构的模型中进行微调或零样本评估,降低了数据处理门槛。
背景与挑战
背景概述
该数据集名为ocr2_hardest_questions_10k_k2_think_medium_vllm_direct_seed20260527_valid_suffix,由相关研究机构于近期构建,旨在聚焦多模态大语言模型在复杂光学字符识别(OCR)任务中的推理能力评估。核心研究问题在于如何系统性地筛选并标注出大模型难以准确回答的OCR问题,以揭示模型在文字理解、噪声干扰及上下文推理方面的局限性。数据集包含近万个样本,涵盖难度评分、通过率及多源平台信息,为细粒度分析模型性能提供了基准资源。其在多模态模型评测领域具有重要影响力,推动了针对OCR高难度问题的专项研究。
当前挑战
该数据集针对的领域挑战包括:多模态大模型在复杂OCR场景中识别模糊、扭曲或低分辨率文本的能力不足,以及模型对文字语义与视觉线索的联合推理薄弱。构建过程中的挑战在于:如何从海量OCR问题中自动识别并保留模型普遍失效的“硬样本”,避免随机采样带来的难度偏差;同时,需统一多源数据集的难度评估标准,融合客观得分与人工判定,确保标签可靠。此外,大规模筛选还需平衡计算成本与样本多样性,以避免同质化问题过多影响评测公平性。
常用场景
经典使用场景
在自然语言处理与人工智能的交叉领域中,问答(QA)数据集始终是衡量模型推理能力与知识掌握程度的核心基准。该数据集汇聚了经过精心筛选的高难度问题,尤其聚焦于那些在现有模型中仍具有较高错误率的挑战性样本。其经典使用场景在于作为大语言模型的鲁棒性测试平台,通过考察模型对复杂、多义或知识密集型问题的应答质量,精准定位模型在逻辑推理、常识运用及信息整合方面的薄弱环节,从而推动模型朝着更深层次的语义理解与认知能力演进。
解决学术问题
该数据集主要解决了当前问答系统中普遍存在的‘难例覆盖不足’这一学术困境。传统的评估基准往往难以区分模型的真实理解与表层模式匹配,而本数据集通过引入精细化的难度评分与多维度错误判别机制,使得研究者能够系统性地剖析模型在极端与模糊场景下的失效模式。它对推动复杂推理、跨领域知识融合以及错误类型分析等研究方向具有深远意义,不仅提升了评估的科学性,更为构建更类人、更可靠的智能对话系统奠定了坚实的理论与数据基础。
实际应用
在实际应用层面,该数据集为智能客服、教育辅导及知识检索系统提供了极具价值的验证与优化工具。通过模拟用户可能提出的高难或边界性问题,企业能够快速检测并修正对话机器人在真实服务场景中的响应缺陷,从而显著降低‘答非所问’或‘错误引导’的风险。此外,其在自动化试题难度标定与个性化学习路径推荐中亦展现出巨大潜力,能够依据数据集的难度分级,动态调整教学内容,实现因材施教,极大提升了教育产品的智能化水平。
数据集最近研究
最新研究方向
当前,多模态大语言模型的推理能力与指令遵循精度已成为前沿角逐的焦点。该数据集聚焦于光学字符识别(OCR)领域中最具挑战性的样本,通过引入细粒度的难度排名与多维度评估指标(如pass_rate、judgement),为模型在复杂视觉文本理解任务上的鲁棒性研究提供了关键基准。其设计紧密关联近期大模型在长文本推理与高难度问答中的表现瓶颈,尤其服务于思维链(Chain-of-Thought)与直接回答策略的对比优化,对推动模型从表层字符识别向深层语义推断的跨越具有里程碑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

