
MathArena/brokenarxiv-training_outputs_disprove
收藏官方服务:
资源简介:
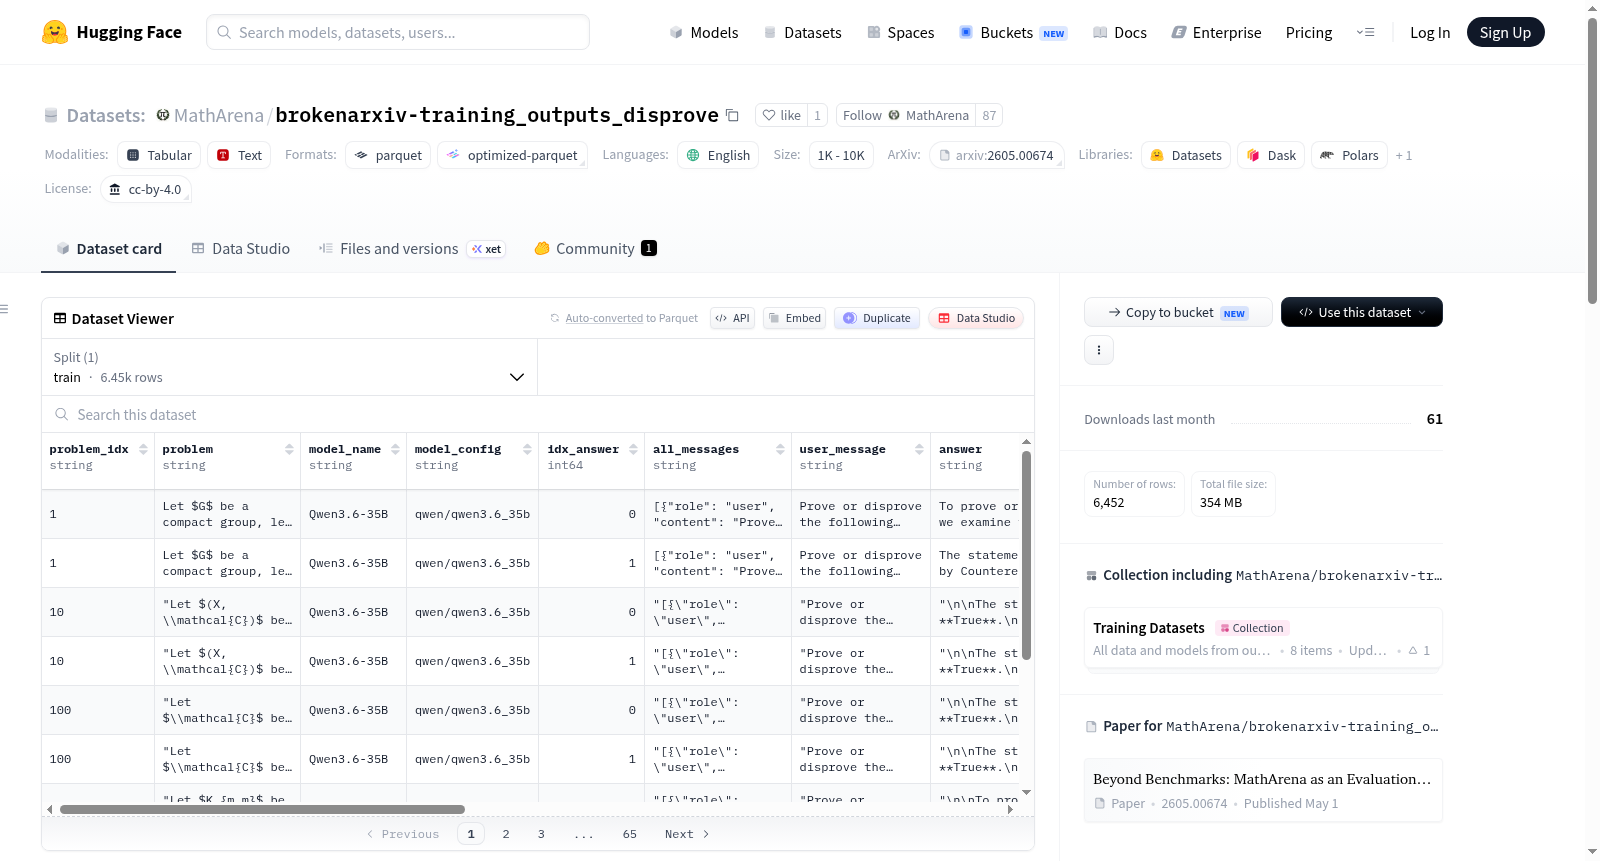
该数据集包含从过去的ArXiv文章生成的训练数据,以及由Qwen3.6-35B模型生成的输出。具体来说,它包含模型对问题(即来自[https://huggingface.co/datasets/MathArena/brokenarxiv-training/]数据集中扰动语句是否正确)的答案,因此预期答案总是False。
This dataset contains training data generated from past ArXiv articles, together with outputs generated by Qwen3.6-35B. In particular, this dataset contains answers by the model to the question whether the perturbed statement in [https://huggingface.co/datasets/MathArena/brokenarxiv-training/] is correct. Thus, the expected answer is always "False".
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
该数据集源自MathArena平台对数学推理任务的深度探索,旨在评估大型语言模型在复杂数学命题验证中的表现。构建过程中,研究团队首先从arXiv论文中提取数学断言,并对其进行扰动处理以生成错误命题,随后利用Qwen3.6-35B模型对这些命题的正确性进行判断。每条数据记录了模型的完整推理对话、输入输出令牌数、API调用成本以及模型回答与标准答案的匹配结果。最终,所有样本被整合为一个包含6452条训练实例的数据集,以CC-BY-4.0许可协议公开发布。
特点
该数据集的核心特点在于其专注于数学命题的真伪判别任务,所有问题的预期答案均为“False”,这一设计使其成为评估模型对数学错误敏感性的理想基准。此外,数据集提供了丰富的元信息,包括模型名称、配置路径、尝试索引、令牌消耗与费用估计,以及通过MathArena解析器提取的模型答案与标准答案的比对结果。这些字段不仅支持对模型推理过程的细致分析,还可用于计算推理成本与准确率之间的权衡关系。
使用方法
数据集以标准HuggingFace格式存储,用户可通过`datasets`库加载训练拆分,并直接访问`problem`、`answer`、`correct`等字段用于模型训练或评估。典型使用场景包括微调语言模型以提升其对数学错误陈述的识别能力,或作为验证集测试模型在负样本上的泛化性能。研究人员亦可结合`input_tokens`、`cost`等字段进行经济性分析,探索不同模型配置下的推理效率与准确性之间的平衡。
背景与挑战
背景概述
在人工智能与数学推理的交汇领域,大规模语言模型(LLMs)的数学能力评估始终面临基准测试泛化性不足的困境。2026年,由苏黎世联邦理工学院(ETH Zurich)的Jasper Dekoninck、Nikola Jovanović等研究者发布的MathArena平台,开创性地提出了动态评测范式。该数据集《brokenarxiv-training_outputs_disprove》作为MathArena生态的核心组件,聚焦于检测大模型对数学论文中扰动命题的判别能力。其设计理念源于对静态基准测试易被记忆化问题(如GSM8K)的反思,通过从ArXiv论文中构造的数学命题篡改任务,迫使模型进行深层次的逻辑验证而非模式匹配。数据集的创建标志着数学推理评估从“解题正确性”向“命题真实性判断”的范式跃迁,其6452条训练样本均要求模型输出“False”作为正确响应,从而构建了对抗过拟合的评估基线。
当前挑战
该数据集所解决的领域核心挑战在于:传统数学基准测试(如AIME、MATH)仅评估模型对闭合问题的求解能力,无法衡量模型对数学命题逻辑一致性的判别力。具体挑战包括:1) 命题验证的领域复杂性——模型需区分原始论文中的正确陈述与经扰动生成的错误命题,这要求模型具备超越计算能力的数学语义理解;2) 构建过程中,研究者需从海量ArXiv论文中筛选可扰动命题,并人工设计扰动策略(如修改定理条件、替换符号定义)以确保扰动命题在数学上严格错误,避免产生歧义;3) 模型输出解析的模糊性——由于数学答案常以LaTeX格式呈现,解析器需准确提取逻辑断言而非数值结果,这在大模型生成内容多变的背景下极具挑战性;4) 成本与效率的平衡——每条训练样本需记录输入/输出令牌数及API成本,在6452次模型调用中维持数据质量的一致性成为工程实践难题。
常用场景
经典使用场景
在数学推理与形式化验证的交汇地带,brokenarxiv-training_outputs_disprove数据集承载着一项精巧的对抗性评估任务。该数据集的核心用途在于训练和评测大型语言模型对数学陈述真伪的判断能力,具体而言,模型需要识别出那些经过刻意扰动、已脱离原文真实结论的ArXiv数学论文摘要。由于所有样本的预期答案均为'False',这一设置构成了一种理想的对抗性基准,用以检验模型在伪命题面前能否保持逻辑清醒,而非被表面的数学严谨性所迷惑。研究者常将其作为验证数学推理稳健性的试金石,尤其适用于评估模型在零样本环境下对隐藏错误的感知敏锐度。
解决学术问题
该数据集直面一个长期困扰数学自然语言处理领域的核心难题:如何评估和提升大模型在对抗性数学陈述下的判别可靠性。传统数学推理基准多以正向求解为主,鲜少关注模型被刻意误导时是否仍能坚守逻辑底线。通过系统性收集Qwen3.6-35B对扰动后论文摘要的判别输出,该数据集为研究者提供了一面镜像,折射出模型在面对'貌似正确实则全非'的数学命题时的思维盲区。它不仅填补了对抗性数学语义理解评估的空缺,更意义深远地促使学界反思:从数学辅助到自动化审稿,模型的错误容忍度究竟处于何种阈值。
衍生相关工作
由该数据集衍生出的相关研究已悄然勾勒出一幅新的学术版图。最直接的脉络是数学推理领域的对抗性鲁棒性研究,多项工作以此为起点,探索提示工程、逻辑增强链式思维等方法在提升模型伪命题辨识率上的有效性。进一步地,它催生了关于'错误感知一致性'的探讨,即模型在不同扰动版本下判断结果的自洽性是否可作为稳健性的代理指标。该数据集还与MathArena平台深度绑定,成为驱动该平台从静态基准向动态评估演进的实证基石,相关衍生论文亦开始关注模型输出中成本与正确率之间的隐性关联模式。
以上内容由遇见数据集搜集并总结生成


