
遇见数据集

scribe-project/nbtale3

收藏
Hugging Face2023-04-25 更新2024-03-04 收录
官方服务:

资源简介:

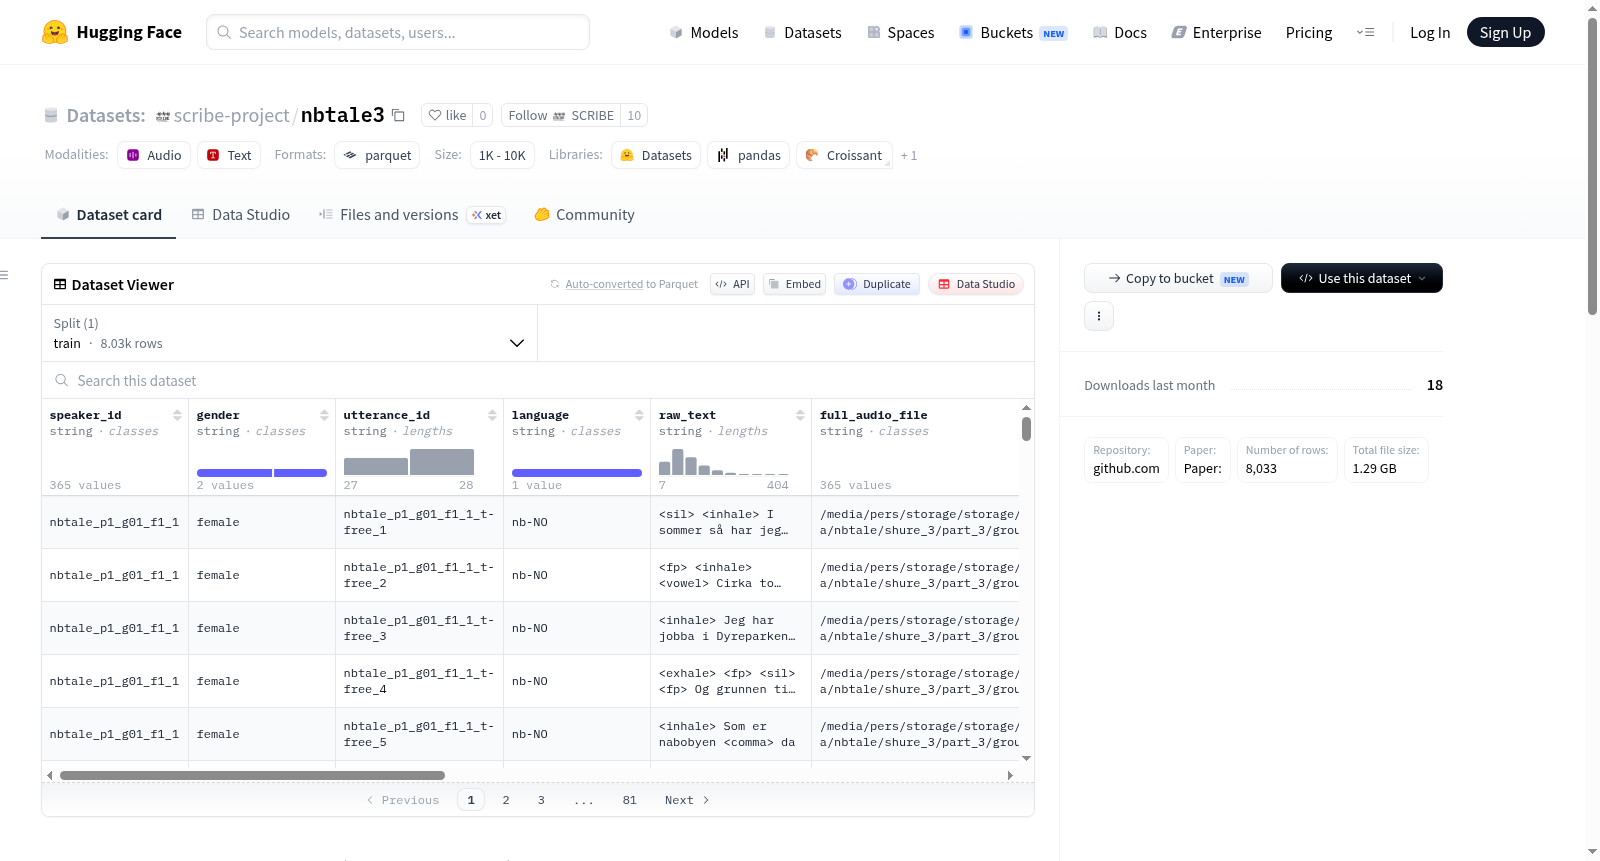
这是NB Tale模块3的博克马尔语片段版本,用于测试论文《Improving Generalization of Norwegian ASR with Limited Linguistic Resources》中的模型,该论文在NoDaLiDa 2023会议上发表。数据集仅包含长度小于15秒的片段,且包含本地和非本地说话者的语音片段。在论文分析中,`region`字段为`foreign`的说话者被过滤掉了。数据集的特征包括说话者ID、性别、话语ID、语言、原始文本、完整音频文件、原始数据分割、地区、持续时间、开始时间、结束时间、话语音频文件和标准化文本。数据集分为训练集,包含8033个样本,总大小为1233495883.99字节。数据集的许可证为CC0。

This is the segmented Bokmål version of NB Tale Module 3, used for testing models in the paper *Improving Generalization of Norwegian ASR with Limited Linguistic Resources*, which was published at the NoDaLiDa 2023 conference. This dataset only contains segments with a duration of less than 15 seconds, and includes speech segments from both native and non-native speakers. In the paper's analysis, speakers with the `region` field marked as `foreign` were filtered out. The features of this dataset include Speaker ID, Gender, Utterance ID, Language, Raw Text, Full Audio File, Original Data Split, Region, Duration, Start Time, End Time, Utterance Audio File, and Normalized Text. This dataset is split into the training set, which contains 8033 samples with a total size of 1233495883.99 bytes. The license for this dataset is CC0.

提供机构:
scribe-project
原始信息汇总

数据集概述

数据集特征

  • speaker_id: 字符串类型
  • gender: 字符串类型
  • utterance_id: 字符串类型
  • language: 字符串类型
  • raw_text: 字符串类型
  • full_audio_file: 字符串类型
  • original_data_split: 字符串类型
  • region: 字符串类型
  • duration: 浮点数类型
  • start: 浮点数类型
  • end: 浮点数类型
  • utterance_audio_file: 音频类型
  • standardized_text: 字符串类型

数据集分割

  • train:
    • num_bytes: 1233495883.99
    • num_examples: 8033

数据集大小

  • download_size: 1287266972
  • dataset_size: 1233495883.99

数据集描述

  • 包含时长小于15秒的挪威语Bokmål段落。
  • 数据集用于测试论文中提到的模型,该论文讨论了在有限语言资源下提高挪威自动语音识别的一般化能力。
  • 数据集包含本地和非本地说话者,但在论文分析中排除了地区设置为foreign的说话者。

语言

  • 挪威语 Bokmål

数据集创建

  • 源数据: 来自挪威语言银行的完整数据集。
  • 初始数据收集和规范化: 使用Spraakbanken下载器获取数据,并通过结合数据集标准化脚本进行标准化。

许可证信息

  • CC0

引用信息

@inproceedings{ solberg2023improving, title={Improving Generalization of Norwegian {ASR} with Limited Linguistic Resources}, author={Per Erik Solberg and Pablo Ortiz and Phoebe Parsons and Torbj{o}rn Svendsen and Giampiero Salvi}, booktitle={The 24rd Nordic Conference on Computational Linguistics}, year={2023} }
搜集汇总
数据集介绍
scribe-project/nbtale3 数据集图片
构建方式
在挪威语自动语音识别(ASR)领域,高质量且多样化的语音数据集对于提升模型泛化能力至关重要。NB Tale模块3数据集正是为此而生,其构建源于挪威语言银行(Norwegian Language Bank)的完整语音资源。研究团队首先利用Spraakbanken下载工具获取原始数据,随后通过标准化的联合数据集处理脚本进行格式统一与文本规范化。为聚焦于短时语音片段的分析,仅提取时长不足15秒的书面挪威语(Bokmål)片段,这一筛选过程借助专用代码实现,最终形成了包含8033个训练样本的紧凑型数据集。该数据集不仅涵盖母语者,还纳入了非母语者的语音,以增强语言多样性,但在论文分析阶段,将地区属性标记为“foreign”的说话者予以剔除,以确保研究聚焦于特定语言场景。
特点
该数据集的核心特色在于其针对ASR模型泛化能力优化的精心设计。所有语音片段均被严格限制在15秒以内,这一长度平衡了模型训练效率与语音信息的完整性,特别适合处理短时语音识别任务。数据集中每条样本均附带丰富的元数据,包括说话者标识、性别、语言、地区、原始文本及标准化文本等,为多维度分析提供了坚实基础。尤为突出的是,数据集同时包含母语与非母语说话者的录音,这种语言背景的多样性使得模型能够更好地应对真实世界中口音与发音变异的挑战。此外,音频文件以标准格式存储,并提供了精确的起止时间戳和时长信息,便于研究人员进行切片式处理与对齐。
使用方法
使用该数据集时,研究人员可通过HuggingFace的datasets库直接加载,无需繁琐的本地下载与预处理。加载后的数据集以字典形式呈现,其中'utterance_audio_file'字段包含可直接用于模型输入的音频数据,而'speaker_id'、'gender'、'region'等字段则助力于分组分析或公平性评估。对于论文复现,建议参照原始研究中的分析流程,利用'region'字段过滤掉非母语者样本,以匹配实验设置。该数据集特别适用于训练和评估端到端ASR模型,尤其是需要处理短时语音片段的应用场景,如语音命令识别或对话系统。结合标准化文本字段,还可用于文本后处理或语言模型微调,以进一步提升识别准确率。
背景与挑战
背景概述
在低资源语言自动语音识别(ASR)领域,挪威语因其多样化的方言、非母语发音变体以及有限的标注数据资源而面临独特挑战。NB Tale数据集模块3(nbtale3)由挪威国家图书馆(Nasjonalbiblioteket)的研究人员Per Erik Solberg等人于2023年创建,旨在探索如何利用有限的语言资源提升挪威语ASR系统的泛化能力。该数据集专注于时长小于15秒的书面挪威语(Bokmål)语音片段,涵盖母语与非母语说话者,其核心研究问题在于验证多源数据联合训练策略对低资源场景下ASR性能的改善效果。作为NoDaLiDa 2023会议论文《Improving Generalization of Norwegian ASR with Limited Linguistic Resources》的测试基准,nbtale3为挪威语语音处理领域提供了标准化的评估工具,推动了针对语言多样性、说话者变异性和数据稀缺性的方法论探索。
当前挑战
nbtale3数据集所解决的领域挑战集中在低资源挪威语ASR的泛化能力提升,具体包括:1)语言多样性难题,即书面挪威语与多种口语方言之间的音系和词汇差异导致声学模型难以捕捉统一模式;2)非母语说话者引入的发音变异性,如重音、音段替换和韵律偏移,加剧了声学建模的不确定性;3)有限标注数据条件下,模型易过拟合于特定录音环境或说话者特征,难以推广至未见场景。构建过程中,挑战主要源于数据标准化流程:原始语料来自挪威语言银行的不同来源,需通过统一脚本处理以消除格式、采样率和标注粒度差异;同时,严格筛选时长小于15秒的片段以符合模型输入约束,但此举可能排除长语音中的上下文信息;此外,过滤非母语说话者(region为foreign)虽能减少发音变异,却也可能削弱模型对真实多语环境的鲁棒性。
常用场景
经典使用场景
在低资源语言自动语音识别(ASR)研究领域,NB Tale 3模块数据集被广泛用于探索如何在有限标注数据条件下提升模型的泛化能力。该数据集精选了时长小于15秒的挪威博克马尔语语音片段,涵盖了母语与非母语说话者,为研究说话者变异、口音差异对ASR性能的影响提供了标准化测试基准。研究者常利用此数据集评估端到端或混合ASR系统在跨领域、跨说话者场景下的鲁棒性,尤其关注模型对非母语发音的适应能力。通过在此数据集上进行微调与评估,学术界得以验证数据增强、多任务学习及迁移学习等策略在低资源北欧语言上的有效性。
衍生相关工作
该数据集衍生了一系列关于低资源ASR标准化与联合训练的开创性工作。基于NB Tale 3,研究者开发了asr-standardized-combined工具包,统一了多个挪威语数据集的文本标准化流程。后续工作如《Combined Training for Low-Resource Norwegian ASR》进一步探索了将NB Tale与其他方言数据(如尼诺斯克语)混合训练的策略,以缓解语料库碎片化问题。此外,该数据集催生了面向非母语发音的声学模型适配研究,例如通过对抗性训练消除说话者区域偏差。相关代码与实验配置均在GitHub仓库中公开,为斯堪的纳维亚语系ASR社区提供了可复现的基准。
数据集最近研究
最新研究方向
在低资源语言场景下,挪威语自动语音识别(ASR)模型的泛化能力提升成为当前研究热点。nbtale3数据集聚焦于时长小于15秒的书面挪威语(Bokmål)语音片段,涵盖母语与非母语说话人,为探索跨区域、跨口音语音识别鲁棒性提供了关键资源。结合NoDaLiDa 2023会议提出的联合训练策略,该数据集被用于验证在有限语言学资源条件下,如何通过标准化预处理与数据筛选优化模型性能。其CC0许可协议进一步降低了研究门槛,推动挪威语ASR技术向少样本学习、领域自适应等前沿方向延伸,对维护语言多样性、促进北欧数字人文发展具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

