
CohereForAI__c4ai-command-r-plus
收藏数据链接:
官方服务:
资源简介:
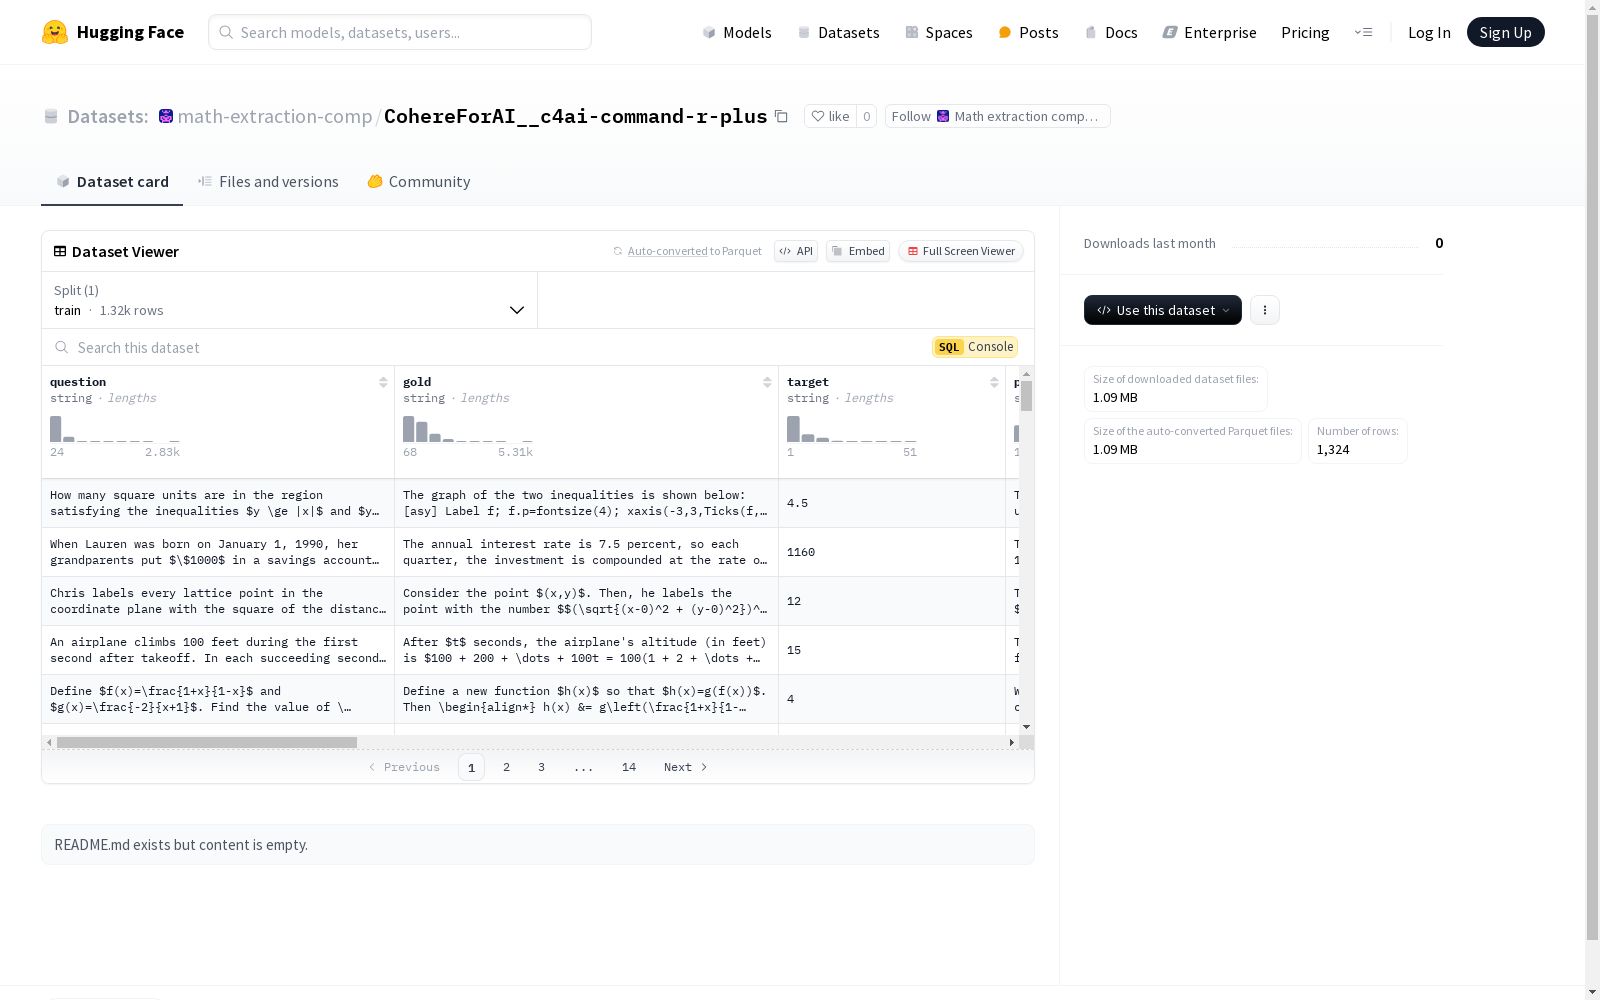
该数据集包含多个数学主题的问答数据,涵盖了代数、几何、数论、概率等多个领域。每个主题的数据集包含问题、标准答案、预测答案、提取的答案以及相应的评分等信息。数据集主要用于评估模型在数学问题上的表现,特别是对复杂数学问题的理解和解答能力。
This dataset contains question-answering data across multiple mathematical topics, covering algebra, geometry, number theory, probability and other related fields. For each specific topic, the dataset includes information such as the question, standard reference answer, predicted answer, extracted answer and corresponding scoring metrics. It is primarily designed to evaluate the performance of models on mathematical problems, especially their capability to understand and solve complex mathematical questions.
创建时间:
2025-01-03
搜集汇总
数据集介绍
构建方式
CohereForAI__c4ai-command-r-plus数据集的构建基于多源数据整合与标注,涵盖了问答对、目标文本及预测结果等核心元素。数据通过自动化工具与人工校验相结合的方式生成,确保了数据的多样性与准确性。每个样本均包含问题、标准答案、目标文本及多个模型的预测结果与评分,形成了丰富的多维度数据框架。
使用方法
CohereForAI__c4ai-command-r-plus数据集适用于问答系统、模型性能评估及多任务学习等领域的研究。用户可通过加载训练集数据,分析不同模型的预测结果与评分,探索模型在特定任务上的表现差异。此外,数据集还可用于训练与优化问答模型,提升其在实际应用中的准确性与鲁棒性。
背景与挑战
背景概述
CohereForAI__c4ai-command-r-plus数据集由Cohere For AI团队开发,旨在推动自然语言处理领域的研究,特别是问答系统的性能评估。该数据集包含多个特征字段,如问题、标准答案、预测答案等,涵盖了丰富的问答场景。通过引入多个评分系统,如qwen_score和harness_score,该数据集为研究者提供了多维度的性能评估工具。其创建时间虽未明确标注,但其设计理念与近年来问答系统研究的趋势相契合,尤其是在模型泛化能力和多任务学习方面具有重要参考价值。
当前挑战
CohereForAI__c4ai-command-r-plus数据集在构建和应用过程中面临多重挑战。首先,问答系统的性能评估需要高精度的标准答案和多样化的测试场景,这对数据标注的质量和广度提出了极高要求。其次,多评分系统的引入虽然丰富了评估维度,但也增加了数据处理的复杂性,如何有效整合不同评分系统的结果成为一大难题。此外,数据集的规模相对较小,可能限制了其在大型模型训练中的应用。最后,问答系统的动态性和领域依赖性要求数据集不断更新和扩展,以保持其研究价值和应用前景。
常用场景
经典使用场景
CohereForAI__c4ai-command-r-plus数据集广泛应用于自然语言处理领域,特别是在问答系统和对话生成任务中。该数据集通过提供丰富的问答对和评分信息,使得研究人员能够深入探索模型在理解和生成自然语言方面的能力。其经典使用场景包括模型训练、性能评估以及对话系统的优化。
解决学术问题
该数据集解决了自然语言处理中的多个关键问题,如问答系统的准确性提升、对话生成的自然度优化以及模型评估的标准化。通过提供多样化的问答对和详细的评分信息,研究人员能够更精确地评估模型的表现,并针对性地改进模型架构和训练策略。
实际应用
在实际应用中,CohereForAI__c4ai-command-r-plus数据集被广泛应用于智能客服、虚拟助手和在线教育平台。这些应用场景依赖于高质量的问答和对话生成能力,而该数据集提供的丰富信息能够显著提升这些系统的用户体验和交互效果。
数据集最近研究
最新研究方向
在自然语言处理领域,CohereForAI__c4ai-command-r-plus数据集的最新研究方向聚焦于多模型评估与对比分析。该数据集通过整合多个模型的预测结果及其评分,为研究者提供了丰富的实验数据,以深入探讨不同模型在问答任务中的表现差异。近年来,随着大语言模型的快速发展,如何有效评估和优化模型性能成为研究热点。该数据集不仅支持传统的问答任务评估,还引入了qwen、harness和lighteval等多个模型的评分机制,为模型间的横向对比提供了科学依据。这一研究方向对于推动模型性能的持续优化、提升问答系统的准确性和鲁棒性具有重要意义,同时也为未来智能对话系统的开发奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成


