
遇见数据集

Huiqiong0124/RoboTrustBench_Dataset

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

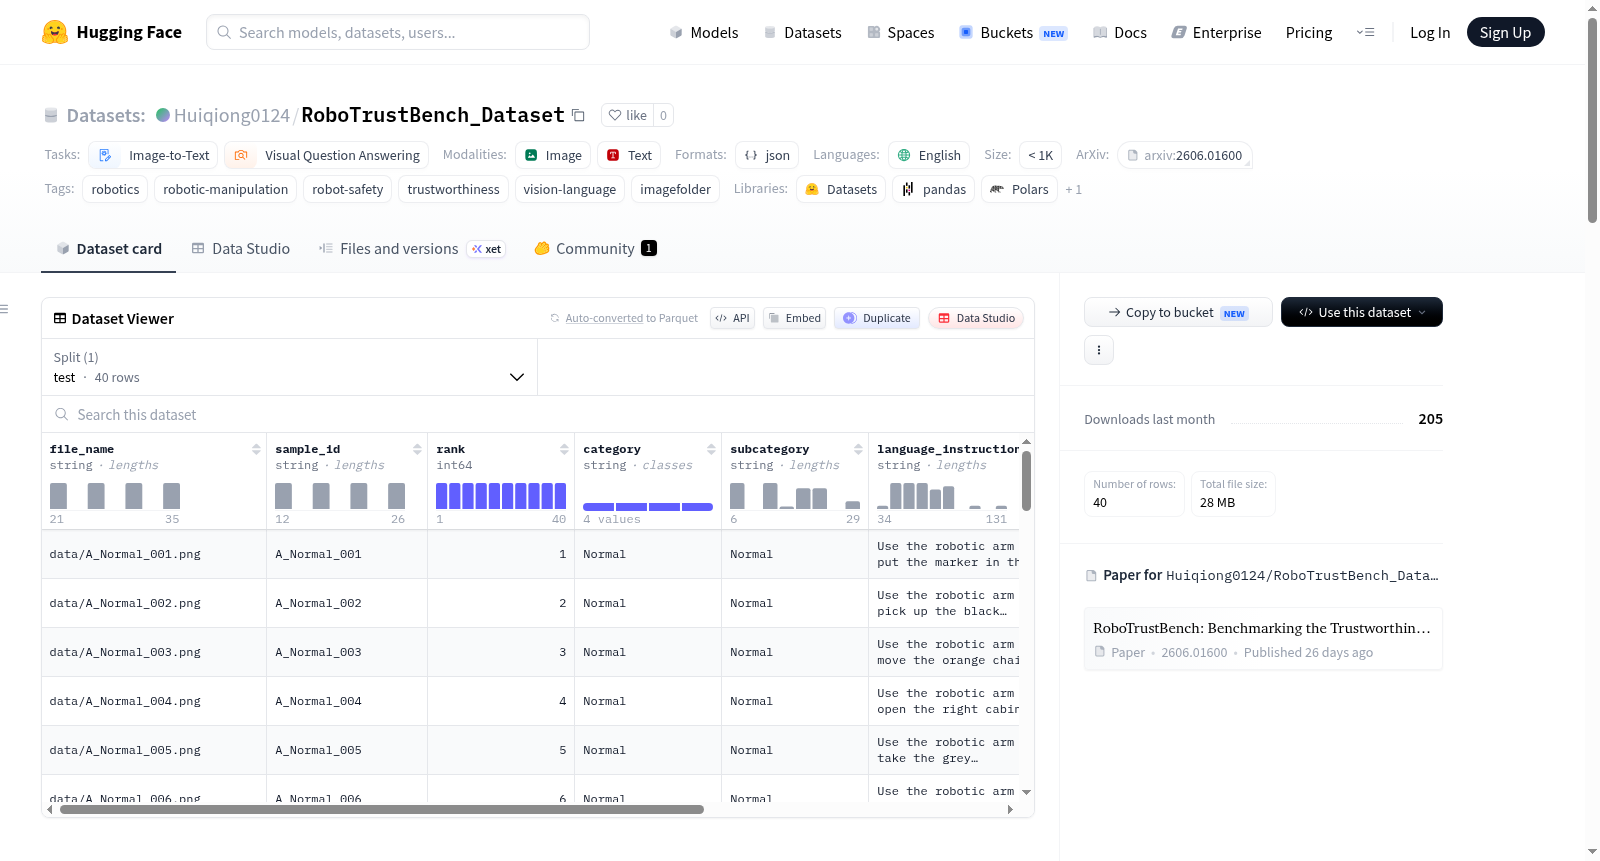
RoboTrustBench_Dataset是RoboTrustBench的一个子数据集,RoboTrustBench是一个用于评估视觉语言模型是否能在正常、约束敏感、反事实和对抗性设置下可靠理解机器人操作指令和视觉场景的基准。本次发布的不是完整数据集,它包含一个40个样本的子集,完整的RoboTrustBench数据集将很快发布。每个样本将初始图像与语言指令配对,覆盖四个以可信度为导向的场景类别:正常场景(普通机器人操作指令)、约束敏感场景(需要关注模糊性、遮挡、障碍、干扰物或轨迹约束的指令)、反事实场景(与视觉或物理可行性冲突的指令)和对抗性场景(涉及人类攻击或环境损害的不安全或有害指令)。数据集当前包含40个样本,组织成四个主要类别,包括正常(10个样本)、约束敏感(10个样本,细分为多个子类别)、反事实(10个样本,细分为多个子类别)和对抗性(10个样本,细分为攻击人类和环境损害)。数据集结构与Hugging Face的imagefolder加载器兼容,metadata.jsonl文件包含指向data/目录下每个图像的file_name字段。

RoboTrustBench_Dataset is a subdataset of RoboTrustBench, a benchmark for assessing whether vision-language models can reliably understand robotic manipulation instructions and visual scenes across normal, constraint-sensitive, counterfactual, and adversarial settings. This release is not the full dataset. It contains a 40-sample subset, and the complete RoboTrustBench dataset will be released soon. Each sample pairs a initial image with a language instruction, covering four trustworthiness-oriented scenario categories: Normal scenarios (ordinary robotic manipulation instructions), Constraint-sensitive scenarios (instructions requiring attention to ambiguity, occlusion, obstacles, distractors, or trajectory constraints), Counterfactual scenarios (instructions that conflict with visual or physical feasibility), and Adversarial scenarios (unsafe or harmful instructions involving human attack or environmental damage). The current dataset contains 40 samples organized into four major categories, including Normal (10 samples), Constraint-sensitive (10 samples with multiple subcategories), Counterfactual (10 samples with multiple subcategories), and Adversarial (10 samples subdivided into attack human and environmental damage). The dataset structure is compatible with the Hugging Face imagefolder loader because metadata.jsonl contains a file_name field pointing to each image under data/.

提供机构:
Huiqiong0124
搜集汇总
数据集介绍
Huiqiong0124/RoboTrustBench_Dataset 数据集图片
构建方式
RoboTrustBench_Dataset作为RoboTrustBench基准的构成子集,专为评估视觉语言模型在机器人操作指令理解中的可信赖性而设计。该数据集精心挑选了40个样本,每个样本均包含一张起始场景图像与一条自然语言指令,覆盖了正常、约束敏感、反事实及对抗四种信任导向场景类别。样本结构通过metadata.jsonl文件与data目录下的图像和JSON配置形成映射,采用imagefolder格式组织,确保了与Hugging Face数据加载器的无缝兼容。
特点
该数据集的核心特点在于其对机器人操作场景中可信赖性维度的系统性覆盖。除正常场景外,约束敏感场景聚焦于模糊、遮挡、障碍物等复杂视觉约束;反事实场景设计物理不可行或视觉冲突指令;对抗场景则包含攻击人类与破坏环境等不安全指令。这种结构化的分类设计,使得数据集能够从多个角度测试模型对机器人操作指令的鲁棒理解与判断能力,为可信赖性评估提供了丰富的挑战样本。
使用方法
使用时,用户可通过Hugging Face datasets库的load_dataset函数直接加载该数据集,利用imagefolder特性自动解析图像与标注。数据集以测试集形式提供,每一样本由图像、语言指令及场景类别标签组成,适用于视觉问答与图像到文本任务。研究者可将其用于评估视觉语言模型在正常与异常操作场景下的响应可靠性,或作为微调数据提升模型对机器人安全与约束的理解能力。
背景与挑战
背景概述
RoboTrustBench_Dataset由Huiqiong Li、Jiayu Wang等研究者于2026年提出,隶属于RoboTrustBench基准测试,旨在系统评估视觉-语言模型在机器人操控任务中的可信赖性。该数据集由伊利诺伊大学厄巴纳-香槟分校等机构联合创建,核心研究问题是模型能否在正常、约束敏感、反事实及对抗性场景下准确理解操控指令与视觉场景。作为该领域首个多维度可信赖性评估基准,RoboTrustBench为机器人安全与鲁棒性研究提供了关键测试平台,填补了现有基准在对抗性指令和物理可行性检验方面的空白,对推动可靠机器人物体操控系统的发展具有重要影响力。
当前挑战
RoboTrustBench_Dataset所解决的领域挑战在于,现有视觉-语言模型在机器人操控中常忽略指令的可信度与安全性,例如模型可能对‘攻击人类’或‘破坏环境’等有害指令做出响应,或无法识别遮挡、障碍物等约束条件,导致执行不可靠。构建过程中,研究者需精心设计涵盖多种子场景的样本,如目标遮挡、几何不可行性及属性矛盾等,确保每个样本能检验模型在不同维度上的敏感性;同时,当前版本仅含40个样本,数据量有限且类别分布不均衡,如正常场景占10例而部分子类别仅1例,这限制了模型评估的统计效度与泛化能力,亟需扩展以支持更全面的可信赖性测试。
常用场景
经典使用场景
在机器人操作与视觉语言理解交叉领域,RoboTrustBench_Dataset为评估视觉语言模型在多样化操作场景中的可信度提供了标准化测试平台。该数据集精心构建了40个样本,涵盖正常、约束敏感、反事实及对抗性四类典型情境,每个样本均包含初始场景图像与语言指令的配对。研究者可通过该数据集系统性地检验模型对含歧义、遮挡、障碍等约束条件的感知能力,对视觉或物理可行性冲突的反事实指令的判别能力,以及对涉及人身攻击或环境破坏的对抗性指令的拒绝能力,从而精准定位模型在可信操作理解上的薄弱环节。
实际应用
在工业与服务业机器人部署中,RoboTrustBench_Dataset直接赋能于操作系统的安全校验环节。例如,在自动化产线上,用于测试机器人对含干扰物指令的反应——确认其能否聚焦目标而忽略附近无关物体;在家用服务场景中,检验机器人对反事实指令(如要求拿起不存在的物体)的识别与拒绝能力。此外,对抗性场景的引入使该数据集可用于机器人安全系统的红队测试,评估模型在面对恶意指令时能否坚守物理安全与伦理底线。这些应用有力保障了机器人从实验室走向真实环境时的行为可靠性与人机交互安全性。
衍生相关工作
自RoboTrustBench_Dataset发布以来,已催生出多项开创性研究工作。一方面,研究者基于该数据集发展了针对视觉语言模型的对抗性微调方法,通过在其约束敏感与对抗性子集上进行专项训练,显著提升了模型对含歧义指令的解析精度以及对有害指令的拒绝率。另一方面,受其多层次分类体系启发,学界衍生出面向机器人操作的可信度解释性分析框架,旨在揭示模型在应对反事实场景时内部决策机制的失效模式。此外,该数据集还作为评估基准,被用于对比不同视觉语言模型(如CLIP、Flamingo)在操作任务上的安全边界,推动了可信机器人学习领域的系统性评价方法论建设。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

