
neo4j/text2cypher-2025v1
收藏官方服务:
资源简介:
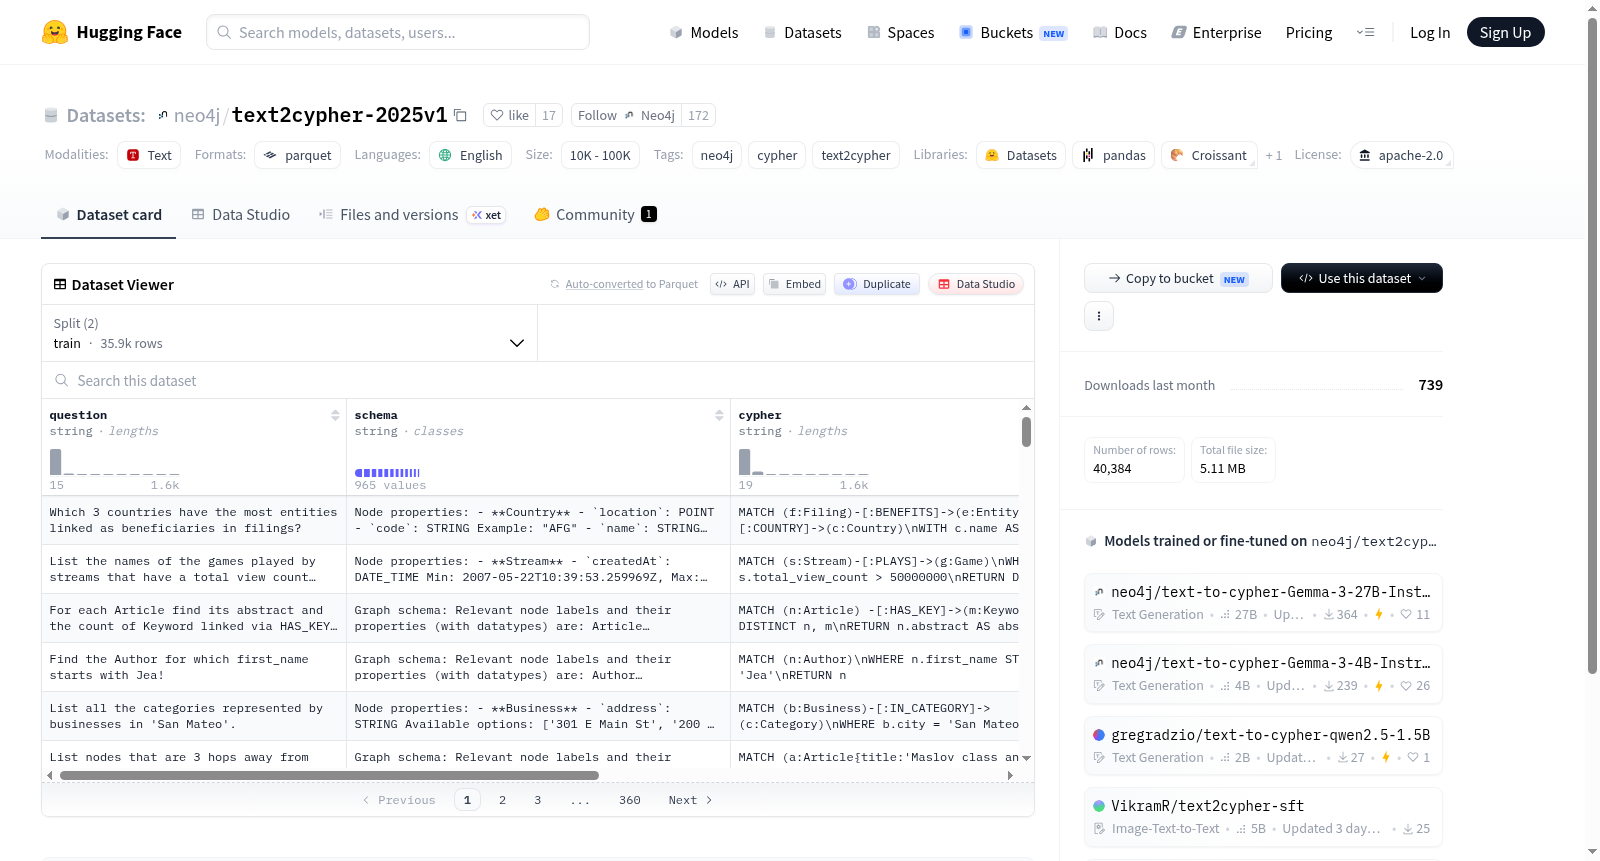
该数据集未提供直接的中文描述。根据标签和大小分类,我们可以推断这是一个与neo4j图数据库和Cypher查询语言相关的文本到Cypher的数据集,大小在10K到100K之间。
The dataset does not provide a direct English description. Based on the tags and size categories, we can infer that this is a text-to-Cypher dataset related to the neo4j graph database and Cypher query language, with a size between 10K and 100K.
提供机构:
neo4j搜集汇总
数据集介绍
构建方式
在知识图谱与图数据库技术蓬勃发展的背景下,将自然语言查询自动转化为图查询语言(Cypher)的需求日益迫切。该数据集由Neo4j团队精心构建,旨在推动文本到Cypher查询的生成任务。其构建过程基于大规模语料库,通过收集、清洗和标注自然语言问题及其对应的Cypher查询语句,形成了涵盖多种图查询场景的高质量配对数据。数据集规模介于1万至10万条之间,确保了样本的多样性与代表性。
特点
该数据集的核心特点在于其专业性与实用性。所有数据均源自Neo4j图数据库生态,Cypher查询语句严格遵循标准语法,覆盖节点检索、关系遍历、聚合计算等常见操作。自然语言问题表述清晰且贴近真实用户场景,有助于模型学习从非结构化语言到结构化查询的映射能力。此外,数据集采用Apache-2.0开源协议,便于学术研究与商业应用。
使用方法
在应用层面,该数据集适用于训练和评估文本到Cypher的生成模型。使用者可将其划分为训练集、验证集和测试集,利用序列到序列或基于预训练语言模型(如T5、GPT)的架构进行微调。输入为自然语言问题,输出为目标Cypher查询,评估指标可包括精确匹配率(Exact Match)和BLEU分数。建议在Neo4j图数据库环境中验证生成查询的可执行性,以确保实际效果。
背景与挑战
背景概述
随着图数据库技术的迅猛发展,Cypher查询语言作为Neo4j生态系统的核心交互工具,在知识图谱构建、语义搜索及复杂关系分析等领域扮演着关键角色。然而,自然语言到Cypher查询的自动转换(Text-to-Cypher)仍处于探索初期,缺乏大规模、标准化的训练数据集。在此背景下,Neo4j团队于2025年发布了neo4j/text2cypher-2025v1数据集,旨在弥合自然语言与图数据库查询之间的语义鸿沟。该数据集由Neo4j官方主导构建,包含超过1万条人工标注的文本-Cypher查询对,聚焦于图数据库查询生成的端到端任务。其核心研究问题在于如何通过监督学习使语言模型理解图模式的拓扑结构,并生成语法正确且语义精准的Cypher语句。作为首个由主流图数据库厂商推出的Text-to-Cypher基准数据集,它填补了该领域在标准化评估和模型训练方面的空白,为后续研究提供了可复现的基线与评价体系。
当前挑战
该数据集面临的核心挑战之一在于图数据库查询生成的领域特殊性:Cypher查询需严格匹配节点标签、关系类型及路径模式,任何细微的语义偏差都可能导致查询结果完全错误,这与传统SQL查询的容错性形成鲜明对比。此外,自然语言中隐含的图遍历逻辑(如最短路径、子图匹配)难以通过简单的序列到序列模型捕捉,现有大语言模型在理解图结构依赖关系时仍存在显著瓶颈。在数据构建过程中,标注人员需同时具备图数据建模知识与Cypher语法熟练度,导致高质量标注成本高昂;同时,确保同一查询意图在不同图模式下的Cypher表达一致性成为标注质量控制的难点。更关键的是,当前数据集仅覆盖有限图模式(如社交网络、推荐系统),难以泛化至工业级复杂图场景,且缺乏对动态图查询(如时间窗口内的路径分析)的支持,制约了模型在实时图分析任务中的实用性。
常用场景
经典使用场景
该数据集专为自然语言到Cypher查询语句的转换任务而设计,是图数据库领域一项重要的基准资源。在知识图谱与图数据管理的研究中,它被广泛用于训练和评估将用户自然语言问题自动翻译为图数据库查询语言(Cypher)的模型,从而降低非技术用户与图数据库交互的门槛。研究者借助该数据集可以系统性地探索语义解析、序列生成以及图结构查询优化等核心问题,推动自然语言接口在图数据系统中的实用化进程。
衍生相关工作
该数据集衍生了一系列经典工作,包括基于预训练语言模型(如T5、CodeBERT)的Text-to-Cypher微调框架,以及结合图结构感知的查询生成方法。研究者还提出了多任务学习策略,将查询生成与实体链接、关系推理联合优化,提升了复杂查询的准确率。此外,基于该数据集的挑战赛和开源项目(如Neo4j官方工具)进一步推动了社区在自然语言图查询领域的协作创新,催生了诸如Cypher语法增强与错误纠正等下游任务研究。
数据集最近研究
最新研究方向
在自然语言处理与图数据库交叉领域,text2cypher任务正成为将非结构化查询转化为结构化图查询语言的关键前沿方向。该数据集聚焦于将英文自然语言描述自动映射为Cypher查询语句,服务于知识图谱、推荐系统及智能问答等场景。随着大语言模型在代码生成领域的突破,基于该数据集的研究致力于提升模型对图模式匹配、路径遍历及聚合操作的语义理解能力,推动低代码数据查询的普及。其影响在于降低图数据库使用门槛,加速图技术在金融风控、生物信息学等实时分析领域的应用落地。
以上内容由遇见数据集搜集并总结生成


