DeepSeek-V4-Pro-Distilled-200K
收藏资源简介:
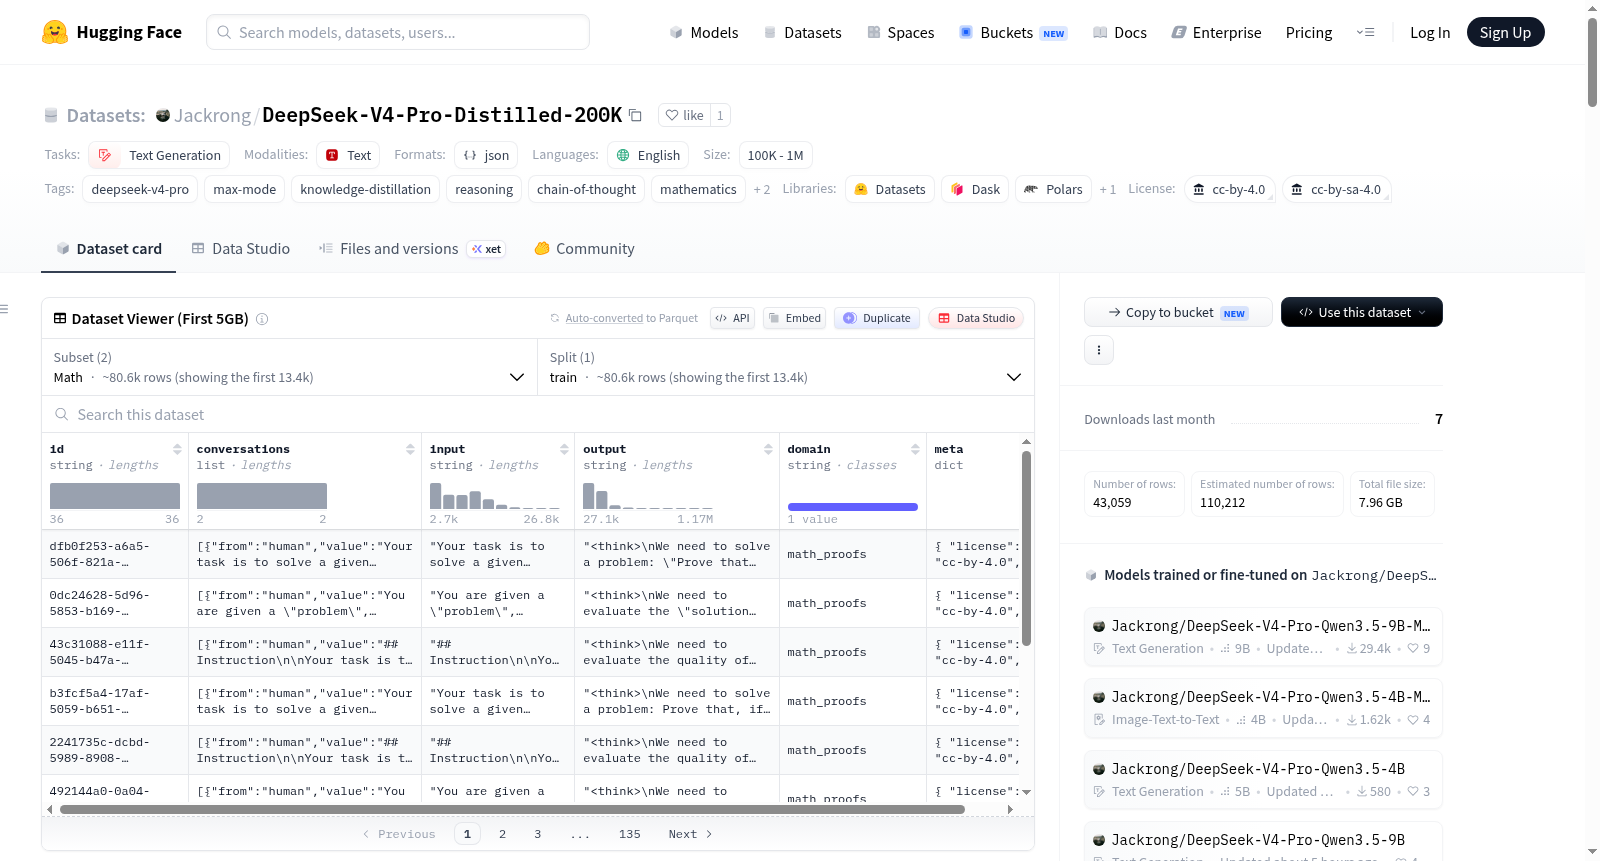
DeepSeek-V4-Pro-Distilled-200K 是一个监督微调数据集,包含 188,027 条长篇数学和科学推理样本。这些样本由 DeepSeek-V4-Pro 在最大推理模式(Max mode)下生成,并标准化为紧凑的对话格式,适用于知识蒸馏。数据集包含两个配置:Math(158,383 条记录)和 STEM(29,644 条记录),涵盖数学、物理、化学、生物学等领域。每条记录包含六个字段:id(唯一标识符)、conversations(一轮 human 和一轮 gpt 对话)、input(用户提示)、output(教师模型生成的推理过程和最终答案)、domain(细粒度领域)、meta(元数据,包括许可证、源数据集和教师模型名称)。数据集经过严格质量控制,包括去重、字段验证和元数据统一。该数据集主要用于数学和科学推理的监督微调、证明生成与验证、长链思维推理实验以及受控的 Math/STEM 混合研究。数据来源于 NVIDIA 发布的 Nemotron-Math-Proofs-v2、Nemotron-SFT-Math-v4 和 Nemotron-SFT-Science-v2 数据集,许可证为 CC-BY-4.0 和 CC-BY-SA-4.0。用户需遵守每条记录的许可证要求。注意:模型生成的答案可能存在错误,数据集偏向数学领域,且长推理链可能不适合简洁的生产环境。基准测试结果来自参考检查点,不直接证明该数据集的因果改进效果。该数据集仅供研究使用。
DeepSeek-V4-Pro-Distilled-200K is a supervised fine-tuning dataset containing 188,027 long-form mathematical and scientific reasoning samples. These samples are generated by DeepSeek-V4-Pro in Max mode and standardized into a compact conversation format suitable for knowledge distillation. The dataset includes two configurations: Math (158,383 records) and STEM (29,644 records), covering fields such as mathematics, physics, chemistry, and biology. Each record contains six fields: id (unique identifier), conversations (one human turn and one GPT turn), input (user prompt), output (reasoning process and final answer generated by the teacher model), domain (fine-grained domain), and meta (metadata including license, source dataset, and teacher model name). The dataset undergoes strict quality control, including deduplication, field validation, and metadata unification. It is primarily used for supervised fine-tuning of mathematical and scientific reasoning, proof generation and verification, long-chain reasoning experiments, and controlled Math/STEM mixture research. The data originates from NVIDIAs Nemotron-Math-Proofs-v2, Nemotron-SFT-Math-v4, and Nemotron-SFT-Science-v2 datasets, with licenses CC-BY-4.0 and CC-BY-SA-4.0. Users must comply with the license requirements of each record. Note: model-generated answers may contain errors, the dataset is biased towards mathematics, and long reasoning chains may not be suitable for concise production environments. Benchmark results are derived from reference checkpoints and do not directly prove causal improvement from this dataset. This dataset is for research use only.
DeepSeek‑V4‑Pro‑Distilled‑200K 数据集详情
数据集概述
该数据集是一个用于监督微调的高质量数学与科学推理数据集,由 DeepSeek‑V4‑Pro 在 Max 推理模式 下生成的响应构建而成,并统一转换为紧凑的对话式结构以支持模型蒸馏。数据集仅包含 Math 和 STEM 两个配置,每条记录具有相同的六个顶层字段。
数据集规模
| 配置 | 记录数 | 分片数 | 划分 |
|---|---|---|---|
| Math | 158,383 | 32 | train |
| STEM | 29,644 | 6 | train |
| 总计 | 188,027 | 38 | — |
数据模式
每条记录包含六个顶层字段:
id(string):稳定记录标识符conversations(list):一个human轮次后接一个gpt轮次input(string):用户提示output(string):教师模型生成的推理过程与最终答案domain(string):细粒度来源领域meta(object):所选配置的最小来源元数据(含许可证、来源数据集、教师模型)
示例数据中,output 包含 <think>...</think> 形式的推理轨迹,且 meta 中记录教师模型为 DeepSeek-V4-Pro-Max。
质量控制
- 保证 188,027 个唯一 ID 与唯一归一化输入
- 全局移除 24 条重复归一化输入
- 对话轮次与
input、output完全一致 - 元数据基于严格配置白名单重建
- 所有 gzip JSONL 分片通过流式解析与模式验证
下游参考结果
以下结果为 9B 参考检查点的测量值,作为蒸馏效果的实际参考,而非受控数据集消融实验。
GSM8K
- 平均准确率:95.28%(完整 1,319 道题测试集,独立四轮评测)
- 四轮准确率分别为 95.22%、94.92%、95.75%、95.22%
对比模型(跨模型参考):
| 模型 | 准确率 |
|---|---|
| MiMo-V2.5-Pro | 99.60% |
| Llama-3.1-405B-Instruct | 96.80% |
| Llama-3.3-70B-Instruct | 94.84% |
| DeepSeek‑V4‑Pro distilled 9B | 95.28% |
| DeepSeek-V4-Pro | 92.60% |
| DeepSeek-V3 | 89.30% |
评测设置:temperature=1.0、top_p=0.95、32K 上下文、Q8 MTP 检查点、精确归一化数字答案匹配。
MMLU‑Pro 选科(数学、物理、化学,各 500 题,共 1,500 题)
- 平均准确率:90.53%,其中数学 92.4%、物理 89.4%、化学 89.8%
- 较 Qwen3.5‑9B 官方高 0.93 个百分点,较 Claude Mythos-distilled 27B 高 4.33 个百分点,较 Claude Mythos-distilled 9B 高 9.46 个百分点
加载方式
支持通过 Hugging Face datasets 库加载:
python
from datasets import load_dataset
math = load_dataset("Jackrong/DeepSeek-V4-Pro-Distilled-200K", "Math", split="train", token=True) stem = load_dataset("Jackrong/DeepSeek-V4-Pro-Distilled-200K", "STEM", split="train", token=True)
预期用途
- 数学与科学推理的监督微调
- 证明生成、批判与验证研究
- 长链思维与工具集成推理实验
- 受控的 Math/STEM 混合研究
局限性
- 模型生成的答案可能存在事实、数学、科学或推理错误
- 数据集中于 Math,分布不均
- 精确输入去重未移除所有语义近似重复
- 长推理轨迹可能不适用于简洁的生产型助手
- 基准结果属于参考检查点测量值,不能证明该数据集单独带来的因果提升
- 基准比较应仅在文档记录的评测与提取设置下解读
来源与许可
数据来自以下源数据集的合并整理,原始卡片对创建方法、署名、所有权与条款具有权威性:
- nvidia/Nemotron‑Math‑Proofs‑v2 — CC BY 4.0
- nvidia/Nemotron‑SFT‑Math‑v4 — CC BY 4.0 与 CC BY-SA 4.0 的记录级混合
- nvidia/Nemotron‑SFT‑Science‑v2 — CC BY-SA 4.0
每条记录的 meta.license 在过滤或再分发时具有权威性。源数据集由 NVIDIA Corporation 发布,本合并版本不代表 NVIDIA 或 DeepSeek 的认可。
免责声明
本数据集仅供研究与开发使用,重大应用前需独立验证数据与模型输出。