generations-qwen3-8b-undial-bm25-10b-rebuttal
收藏资源简介:
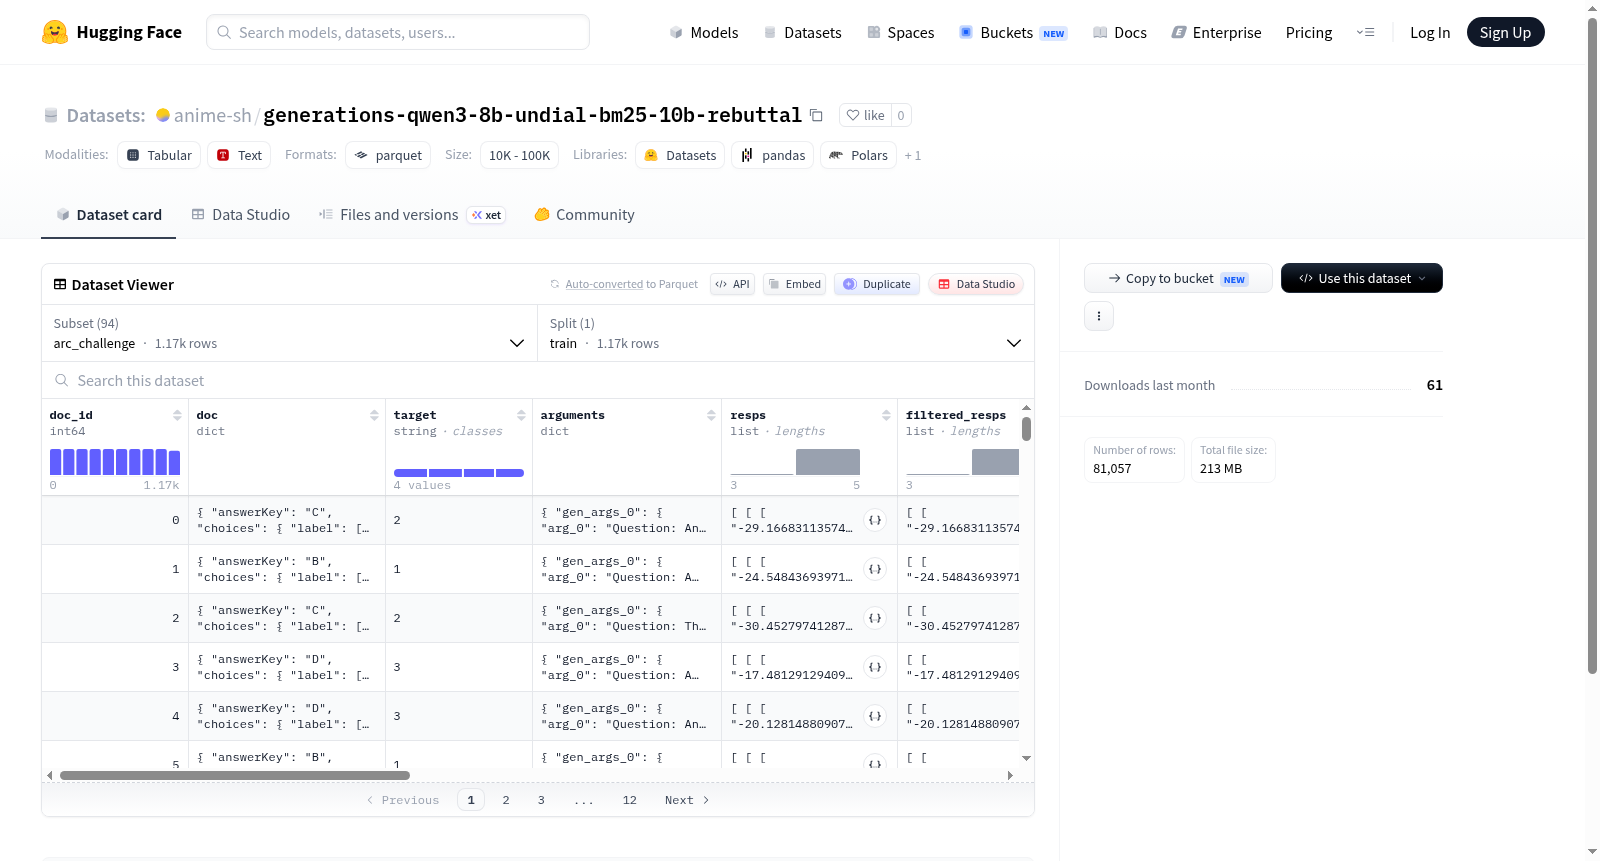
该数据集是一个集合,包含多个用于评估语言模型推理能力的基准任务配置。核心配置包括:1) ARC 挑战赛(arc_challenge):包含科学相关的问题、多项选择答案和标准答案键,用于评估科学推理能力,共有1172个训练样本。2) 一系列 BBH(BIG-Bench Hard)任务的少样本思维链(CoT)版本,涵盖多种推理类型,例如:布尔表达式、因果判断、日期理解、消歧问答、Dyck 语言、形式谬误、几何形状、超常语序、逻辑推理(涉及三、五、七个对象)、电影推荐、多步算术、导航、物体计数、表格中的企鹅、关于彩色物体的推理、毁坏的名字等。每个 BBH 任务配置通常包含输入(input)和目标答案(target)字段,并各有250个训练样本(部分任务如因果判断为187个,表格中的企鹅为146个)。所有数据条目均包含丰富的元数据,如模型生成参数(arguments)、原始和过滤后的模型响应(resps, filtered_resps)、用于数据标识的哈希值(doc_hash, prompt_hash, target_hash)以及评估分数(score)。该数据集适用于对语言模型进行多任务、少样本的推理能力评估、思维链生成分析以及模型响应质量研究。
This dataset is a collection that includes multiple benchmark task configurations for evaluating the reasoning capabilities of language models. Core configurations include: 1) ARC Challenge (arc_challenge): Contains science-related questions, multiple-choice answers, and standard answer keys, used to assess scientific reasoning ability, with a total of 1172 training samples. 2) A series of few-shot Chain-of-Thought (CoT) versions of BBH (BIG-Bench Hard) tasks, covering various reasoning types, such as: Boolean expressions, causal judgment, date understanding, disambiguation QA, Dyck languages, formal fallacies, geometric shapes, hyperbaton, logical deduction (involving three, five, and seven objects), movie recommendation, multi-step arithmetic, navigation, object counting, penguins in a table, reasoning about colored objects, ruined names, etc. Each BBH task configuration typically includes input and target answer fields, with 250 training samples each (some tasks, such as causal judgment, have 187 samples, and penguins in a table have 146 samples). All data entries contain rich metadata, such as model generation parameters (arguments), original and filtered model responses (resps, filtered_resps), hash values for data identification (doc_hash, prompt_hash, target_hash), and evaluation scores (score). This dataset is suitable for multi-task, few-shot reasoning ability evaluation of language models, Chain-of-Thought generation analysis, and model response quality research.
数据集详情总结
数据集概述
该数据集是一个基于 Qwen3-8B 模型生成的评测数据集,专注于多种推理任务的响应结果。数据集名称中的 "undial" 表明该评测可能针对非对话式场景,而 "bm25-10b" 暗示了与 BM25 检索算法和 10B 参数模型的相关性。
配置与任务类型
数据集包含多种配置(config),覆盖多个评测任务,主要分为两大类:
ARC Challenge
- 任务类型:常识问答推理
- 特征:包含问题(question)、答案选项(choices)、正确答案(answerKey)等
- 样本数量:1172 个训练样本
Big-Bench Hard (BBH) 任务集
包含多个子任务,每个任务均为“思维链”(Chain-of-Thought)少样本评测,主要任务包括:
| 任务名称 | 样本数 | 下载大小 |
|---|---|---|
| Boolean Expressions | 250 | 680 KB |
| Causal Judgement | 187 | 1.23 MB |
| Date Understanding | 250 | 697 KB |
| Disambiguation QA | 250 | 1.29 MB |
| Dyck Languages | 250 | 919 KB |
| Formal Fallacies | 250 | 1.53 MB |
| Geometric Shapes | 250 | 2.00 MB |
| Hyperbaton | 250 | 1.17 MB |
| Logical Deduction (Five Objects) | 250 | 1.22 MB |
| Logical Deduction (Seven Objects) | 250 | 1.26 MB |
| Logical Deduction (Three Objects) | 250 | 1.07 MB |
| Movie Recommendation | 250 | 777 KB |
| Multistep Arithmetic Two | 250 | 837 KB |
| Navigate | 250 | 800 KB |
| Object Counting | 250 | 554 KB |
| Penguins in a Table | 146 | 610 KB |
| Reasoning about Colored Objects | 250 | 979 KB |
| Ruin Names | 250 | - |
数据字段结构
各配置的数据字段结构相似,主要包含:
通用字段
- doc_id: 文档标识(整数型)
- doc: 原始任务文档,包含输入(input)和目标(target)
- target: 标准答案
- arguments: 生成参数配置
- resps: 模型生成的原始响应列表(嵌套列表结构)
- filtered_resps: 过滤后的响应(仅保留第一个生成结果)
- filter: 过滤方法描述
- metrics: 评估指标
- doc_hash: 文档哈希值
- prompt_hash: 提示词哈希值
- target_hash: 目标哈希值
- score: 模型得分(浮点型)
ARC Challenge 特有字段
- answerKey: 正确答案标签
- choices: 选项列表,包含标签(label)和文本(text)
- question: 问题内容
BBH 任务特有生成参数
- do_sample: 是否采样
- max_gen_toks: 最大生成 token 数
- temperature: 采样温度
- until: 生成终止条件
数据规模
- 总下载大小:约 28 MB(各配置合计)
- 总样本数:5,425 个样本(含所有配置)
- 数据格式:所有配置均包含单个训练划分(train split)
数据结构特点
- 多层级响应结构:resps 为三维嵌套列表,表示多次生成的响应;filtered_resps 为二维列表,存储过滤后的单一响应
- 参数化生成配置:不同配置的生成参数可能不同,BBH 任务包含详细的采样参数设置
- 完整哈希追踪:提供文档、提示词和目标三个层面的哈希值,便于数据溯源