
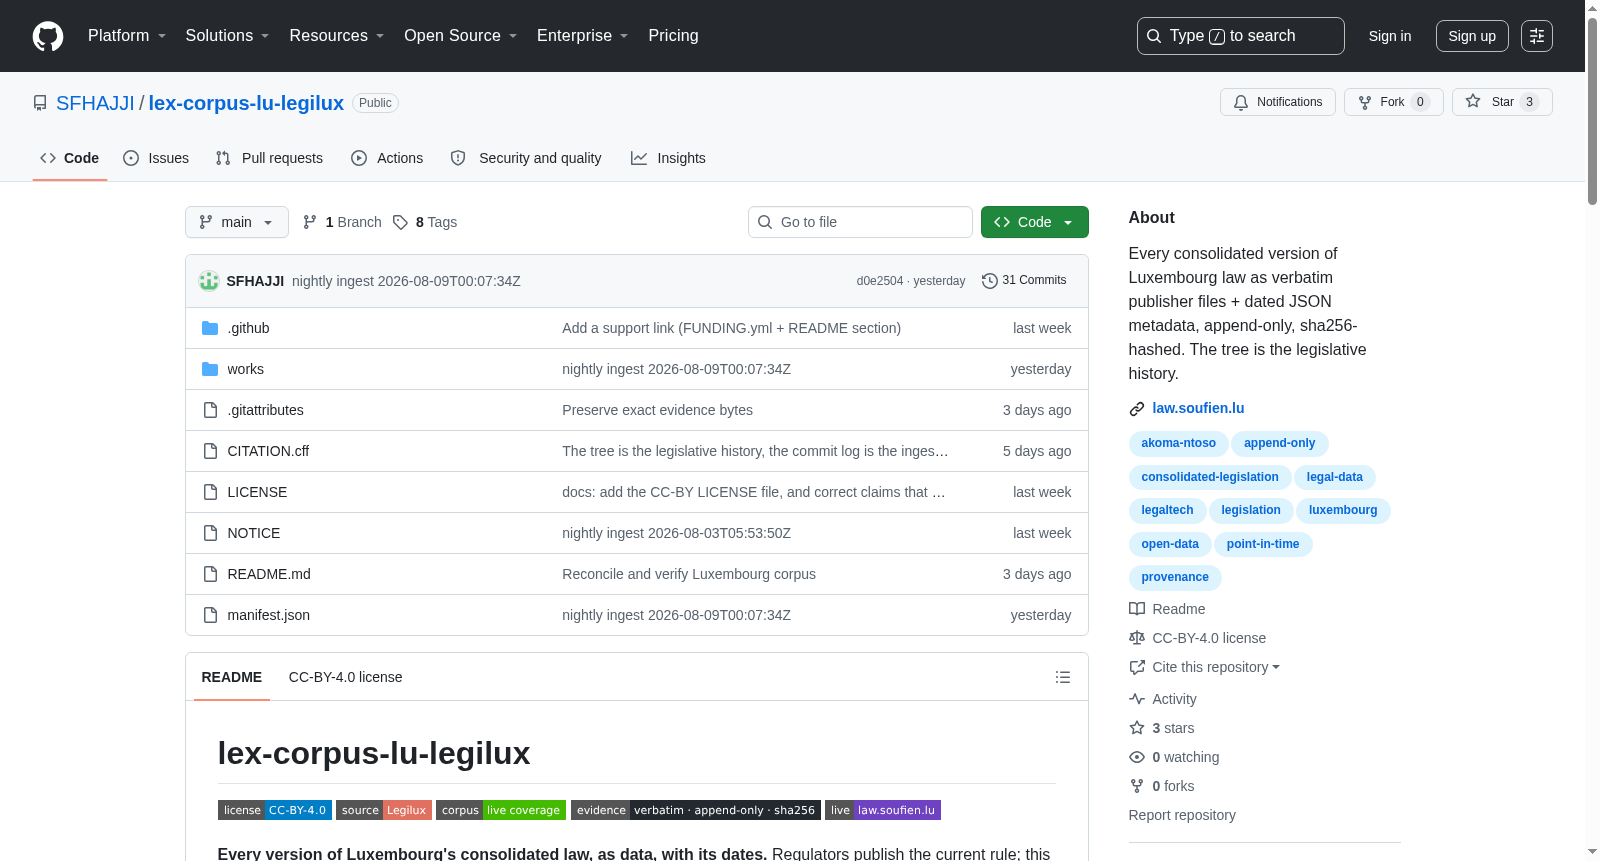
lex-corpus-lu-legilux
收藏官方服务:
资源简介:
卢森堡法律的每个合并版本,以数据形式呈现,附带生效日期。
Each consolidated version of Luxembourg’s laws, presented as data and accompanied by its corresponding effective date.
创建时间:
2026-08-01
原始信息汇总
卢森堡综合法律语料库(lex-corpus-lu-legilux)
数据集概述
该数据集收录了卢森堡大公国官方发布的全部整合版法律文本(consolidated law),以结构化数据形式保存每个版本的完整内容及其生效日期。数据集源自卢森堡官方法律门户 Legilux(https://legilux.public.lu),由 Service central de législation(中央立法局)发布,遵循 CC-BY-4.0 许可协议。
核心特性
- 版本完整性:收录 Legilux 发布的所有整合法律版本,支持按日期查询特定时间点生效的法律文本
- 数据可靠性:内容为逐字节原文存储(byte-verbatim),采用追加写入(append-only)模式,每个文件附带 sha256 哈希值以保障完整性
- 双重时间轴:树结构按法律工作和有效期排列,可直接读取立法历史;git 日志记录的是采集时间而非法律生效时间,两者分离存储
- 官方原始文本:每版文本为 Legilux 官方发布的 Akoma Ntoso 3.0 XML 原文件,保留所有语言版本
数据覆盖范围
- 覆盖声明:2017年起数据密集且可靠;2017年之前覆盖稀疏但真实存在;另有孤立的历史及未来日期快照
- 数据边界:不含 Legilux 未纳入整合法律集合的法案(Acts),该缺口在文档中明确说明
- 内容类型:法律(Lois)、大公国条例(règlements grand-ducaux)、法典(codes)、汇编(recueils)及宪法(Constitution)
目录结构
works/<法律工作标识>/versions/<生效日期>/
- meta.json # 包含出版方声明的有效期、首次采集时间戳、sha256哈希及官方文本链接
- 正文XML文件 # 逐字节原文存储的 Akoma Ntoso 3.0 XML
构建与维护机制
- 每日自动更新:单一定时任务(GitHub Actions)驱动全部出版源的数据采集
- 异常防护:作品数量下降超5%时自动丢弃当次数据,确保历史数据不被破坏
- 确定性校验:源文件未变但衍生输出变化时立即失败并停止提交
- 安全部署:不可变镜像 + 零流量预演 + 健康检查通过后才正式发布
数据许可与版权
- 数据来源:Ministère dÉtat, Service central de législation, Grand-Duché de Luxembourg
- 许可协议:内容文件与元数据均为 CC-BY-4.0 许可,允许商业使用
- 法律文本版权:根据卢森堡2001年4月18日法律第10条第8款,法案文本不享有版权
访问方式
- 浏览数据:直接访问仓库中任意
works/<slug>/versions/<date>/meta.json - 在线演示:https://law.soufien.lu
- MCP 接口:https://law.soufien.lu/mcp
- 逐条数据集:https://github.com/SFHAJJI/lex-articles
- 引擎与工具:https://github.com/SFHAJJI/lex
配套资源
- 实时覆盖页面:https://law.soufien.lu/coverage
- 数据验证页面:https://law.soufien.lu/verify
- 决策文档:https://law.soufien.lu/decisions
- 构建状态:https://law.soufien.lu/built
搜集汇总
数据集介绍
构建方式
本数据集以卢森堡官方立法门户Legilux为唯一数据源,系统性地采集并整理了该国全部合并版法律文本及其历史版本。构建过程严格遵循官方发布渠道,通过SPARQL端点获取版本元数据,并以字节级原样保存官方发布的Akoma Ntoso 3.0 XML全文,确保数据的权威性与完整性。每个版本均附带出版商声明的效力时间区间、首次发现时间戳及SHA256哈希值,以可验证的方式记录法律文本的演变轨迹。数据集采用Git仓库作为存储与分发载体,通过每日自动化的摄取流水线实现持续更新,并在异常检测与确定性保护机制下确保数据质量,从而构建出一个兼具历史纵深与实时性的法律语料库。
特点
该数据集的核心特色在于其独特的双时间轴设计,将法律效力时间与数据摄取时间严格分离,存储于内容哈希之中而非可变的提交元数据,实现了对法律历史状态的精确回溯。作为证据层,它采用仅追加模式,所有文本均不可被篡改或覆盖,辅以内嵌SHA256摘要,提供防篡改的完整性保障。数据集遵循CC-BY-4.0许可,支持商业与非商业再利用,并完整保留所有语言版本,覆盖从2017年起致密、此前稀疏但真实的历史快照。其目录结构按法律工作与生效日期组织,无需工具即可直观阅读立法史,而git日志则忠实记录摄取过程,形成了透明、可审计且具有高度时间粒度的法律数据资产。
使用方法
使用者可通过Git克隆获取完整数据集,并通过浏览works目录下各法律条目的versions子目录,按日期查看特定时点的合并文本。每个版本的meta.json文件提供了效力区间、官方来源链接及内容哈希,便于验证与引用。此外,项目提供了在线演示站点law.soufien.lu,支持实时查询与搜索,并配备了MCP(模型上下文协议)端点,方便集成至AI助手等应用。对于需要精细分析的用户,关联的lex-articles数据集提供了按条款拆分的粒度层,而生成了清单文件manifest.json则可用于批量处理与验证。数据集的更新由夜间自动化任务驱动,使用者可放心获取最新状态,同时通过覆盖率页面与验证页面监控数据完整性。
背景与挑战
背景概述
lex-corpus-lu-legilux数据集由Soufien Hajji等人创建,旨在系统性地捕获卢森堡 consolidated law 的每个历史版本,填补了法律数据领域长期存在的历史版本缺失问题。该数据集依托卢森堡官方立法门户Legilux的开放数据资源,自2017年起实现了高密度覆盖,通过Git仓库存储经过SHA256哈希验证的原始Akoma Ntoso 3.0 XML文件,确保数据完整性与不可篡改性。其核心研究问题在于将法律时间轴(适用日期)与数据摄取时间分离,以精确回答“某日生效的法律条款”,这一设计对法律信息学、数字政府和历史法律研究具有重要价值,为跨境法律比较和自动化法律分析提供了可靠的数据基础。
当前挑战
构建此类全面法律语料库面临多重挑战。在领域问题层面,法律文本的规范化表述与多语言版本并存,要求数据模型同时支持精确的时间区间和版本追溯,而现行法律系统的动态更新使得历史状态重建尤为复杂。构建过程中,需处理Legilux部分历史数据稀疏、未来日期版本回溯等数据质量问题,同时遵守robots.txt限制和CC-BY许可条款,确保文化法律文本无版权障碍。此外,Git仓库虽提供版本控制,但需设计双层时间轴机制,避免将摄取时间误认为法律适用时间,并发展确定性校验流程以防范非确定性提取,保障数据可信度。
常用场景
经典使用场景
该数据集的核心应用场景在于为卢森堡 consolidated 法律文本提供完整的版本历史追溯能力。通过将 Legilux 官方发布的每一版 consolidated 法律文本以结构化形式存储于 Git 仓库中,研究者得以按‘效力日期’精确检索任意时间点生效的法律表述,从而化解了传统法律研究中‘当时有效版本’难以获取的困境。其按‘法律文件—版本日期’组织的目录结构,使得用户无需借助复杂工具即可直接浏览某部法律在特定日期的完整内容,极大降低了立法历史研究的门槛,为比较法学与立法动态分析提供了坚实的数据基础。
衍生相关工作
围绕此数据集已衍生出多项重要工作。其中,作为配套的‘逐条文本’数据集(lex-articles)将整部法律拆解为条款级别,支持更细粒度的语义检索与跨版本对比研究。同时,该数据集促成的‘lex-index/3’发布契约,引入了基于哈希和 Azure Key Vault 签名的完整工件清单,为第三方应用提供了可验证的信任根。在此基础上构建的实时演示站点与 MCP 服务器,则展示了将法律数据融入标准化对话式交互界面的可行性,为后续研究如何在自然语言处理与法律推理中利用此类高质量版本化语料库奠定了实践基础。
数据集最近研究
最新研究方向
在数字法律信息学领域,对法律数据的时序完整性、可验证性与机器可读性的追求正成为前沿焦点。lex-corpus-lu-legilux以其对卢森堡 consolidated 法律的全量版本化存档,开创了以 Git 仓库为载体的立法史研究新范式。其核心创新在于将法律文本的有效时间与交易时间分离,通过内置 SHA256 哈希确保数据不被篡改,实现了对任意历史时点法律状态的精确回溯。该数据集紧密契合全球开放政府数据与可验证计算的热点趋势,其 append-only 的不可变存储机制与基于 OIDC 的自动化流水线,为法律科技领域树立了从数据获取、完整性校验到安全部署的全新标杆。这不仅为法律史学者提供了丰富的研究素材,也为智能司法、合规自动化等应用奠定了坚实的数据基础设施,推动了法律数据从静态发布向动态、可验证生态的演进。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


