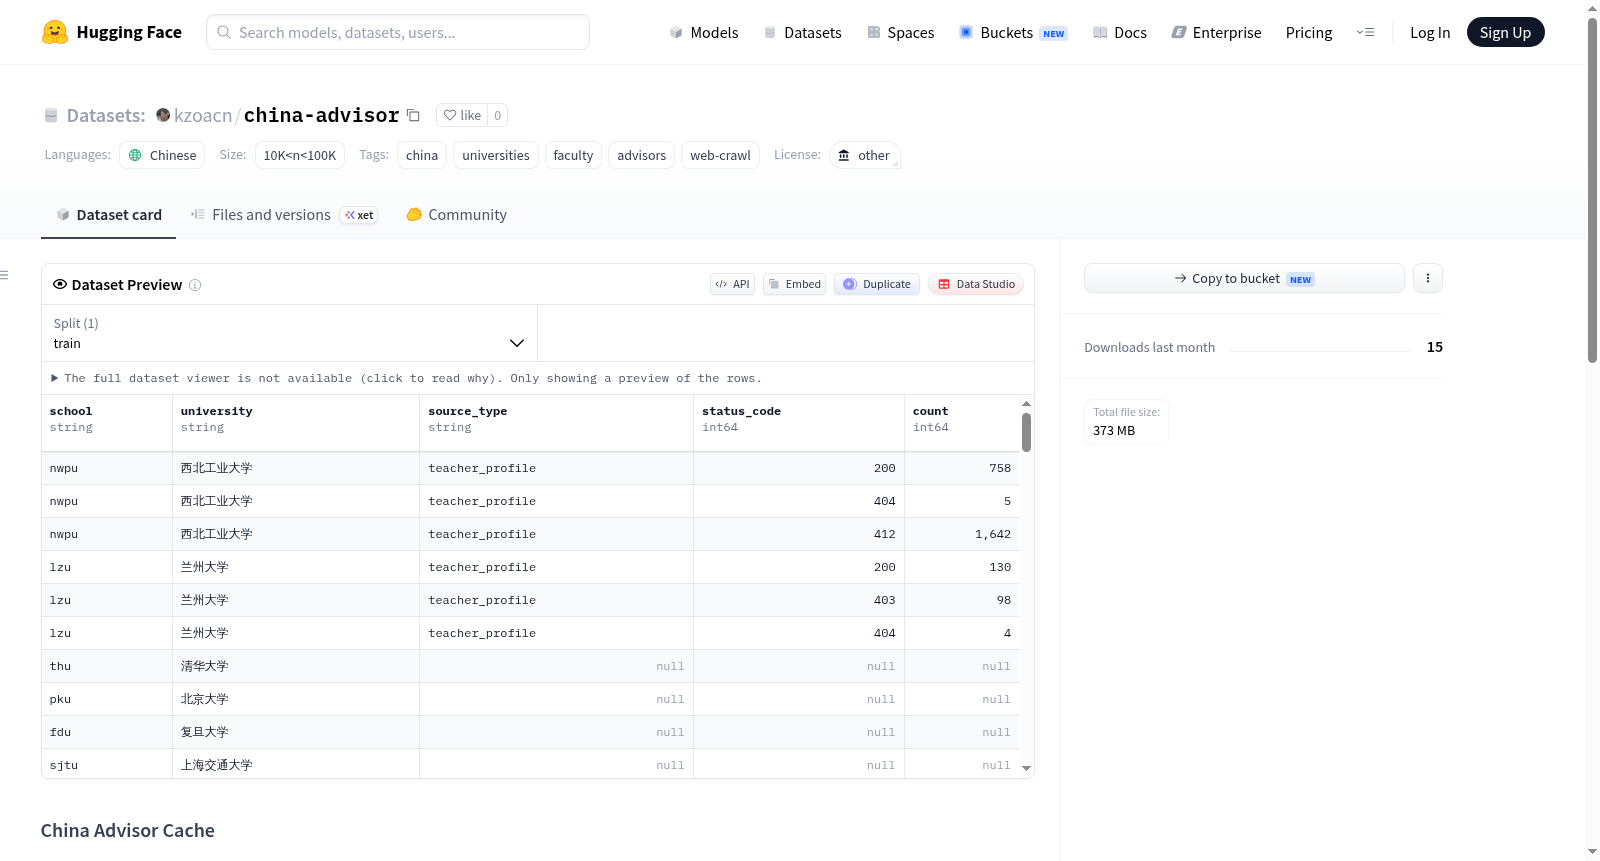
china-advisor
收藏资源简介:
China Advisor Cache 数据集是一个包含中国大学导师/教师页面缓存公共网页、API 响应和提取文本的资源集合,旨在为研究或应用提供中国高校教师信息的结构化数据。它覆盖了39所985高校,当前数据规模包括77968条元数据记录和71437条教师档案记录,其中69288条为状态码200的有效教师档案记录。数据集内容主要包括缓存存档文件(如archives/china-advisor-cache-2026-06-20.tar.zst)、缓存模式与元数据格式说明、985爬取报告、每所高校的缓存统计摘要、错误日志、种子源注册配置以及用于爬取和修复的脚本。数据通过尊重的爬取方式获取,爬取器遵守robots.txt规则,不绕过访问控制,并记录被阻止的URL,适用于高校教师信息分析、学术网络研究、数据爬取与缓存技术验证等任务。
The China Advisor Cache dataset is a resource collection containing cached public web pages, API responses, and extracted text from Chinese university advisor/teacher pages. It aims to provide structured data on Chinese higher education instructors for research or applications, covering 39 Project 985 universities. The current data scale includes 77,968 metadata records and 71,437 teacher profile records, with 69,288 being valid teacher profile records with a status code of 200. The dataset primarily consists of cached archive files (e.g., archives/china-advisor-cache-2026-06-20.tar.zst), cache schema and metadata format descriptions, 985 crawling reports, cache statistical summaries for each university, error logs, seed source registration configurations, and scripts for crawling and repair. Data is acquired through respectful crawling methods, with crawlers adhering to robots.txt rules, not bypassing access controls, and logging blocked URLs. It is suitable for tasks such as university teacher information analysis, academic network research, and data crawling and cache technology validation.
数据集概述:China Advisor Cache
来源地址:https://huggingface.co/datasets/kzoacn/china-advisor
语言:中文
许可协议:其他(未明确指定开源许可)
标签:中国、大学、教职、导师、网页爬取
数据规模:约 10K-100K 条记录
数据集内容
该数据集存储了缓存的中国高校导师/教职页面、API 响应及提取的文本数据。主要包含以下内容:
-
缓存归档文件:
archives/china-advisor-cache-2026-06-20.tar.zst:完整缓存归档,保留本地data/cache/...目录结构。archives/china-advisor-cache-2026-06-20.tar.zst.sha256:归档文件的 SHA256 校验和。
-
元数据文件:
metadata/CACHE_FORMAT.md:缓存模式及元数据格式说明。metadata/REPORT.md:985 高校爬取报告。metadata/cache_summary.tsv:按学校统计的缓存数量。metadata/cache_summary.json:机器可读的按学校统计缓存数量。metadata/cache_status_summary.tsv:针对疑似被屏蔽的个人主页的状态码摘要。metadata/errors.tsv:遵循爬取规则的错误日志。
-
配置文件:
configs/985_sources.yaml:985 高校种子来源注册表。configs/985_*repair_sources.yaml:针对中央及学院级门户的定向修复源注册表。
-
脚本文件:
scripts/crawl_985_cache.py:用于 985 扩展的阶段性爬虫。scripts/repair_985_low_coverage.py:针对 Tsites 门户和基于公共 API 的门户的修复爬虫。
数据规模与覆盖
当前 985 高校覆盖报告显示,覆盖了 39 所 985 工程学校,包含:
- 77974 条元数据记录
- 71411 条
teacher_profile记录 - 69271 条状态码为 200 的
teacher_profile记录
恢复方法
从数据集仓库中执行以下命令解压归档文件:
bash tar --use-compress-program=zstd -xf archives/china-advisor-cache-2026-06-20.tar.zst
执行后会在当前目录生成 data/cache/<学校名称>/{pages,text,metadata}/... 目录结构。
爬取说明
- 缓存包含原始本地缓存副本,以及针对 985 高校的全局爬取和修复爬取结果。
- 爬虫记录被屏蔽的 URL,且不会绕过
robots.txt、TLS 失败、登录、验证码、CC 防护等访问控制。