krr-oxford/OntoLAMA
收藏资源简介:
OntoLAMA是一组用于本体子集推理的语言模型探测数据集。该工作遵循“LMs-as-KBs”文献,但专注于从形式化的知识库(如OWL本体)中提取的概念化知识。具体来说,子集推理(SI)任务以自然语言推理(NLI)风格引入和表述,其中子概念和超概念被语言化并拟合到模板中,分别形成前提和假设。采样的公理通过本体推理进行验证。SI任务进一步分为原子SI和复杂SI,前者仅涉及原子命名概念,后者涉及原子和复杂概念。OntoLAMA使用了不同规模和领域的真实世界本体进行构建,总共有四个原子SI数据集和两个复杂SI数据集。
OntoLAMA是一组用于本体子集推理的语言模型探测数据集。该工作遵循“LMs-as-KBs”文献,但专注于从形式化的知识库(如OWL本体)中提取的概念化知识。具体来说,子集推理(SI)任务以自然语言推理(NLI)风格引入和表述,其中子概念和超概念被语言化并拟合到模板中,分别形成前提和假设。采样的公理通过本体推理进行验证。SI任务进一步分为原子SI和复杂SI,前者仅涉及原子命名概念,后者涉及原子和复杂概念。OntoLAMA使用了不同规模和领域的真实世界本体进行构建,总共有四个原子SI数据集和两个复杂SI数据集。
数据集概述
名称: OntoLAMA
任务类别: 文本分类
标签:
- 本体论
- 包含推理
- 自然语言推理
- 概念知识
- 语言模型作为知识库
数据集大小: 1M<n<10M
语言: 英语
数据集结构
数据实例
-
Atomic SI 示例:
{ v_sub_concept: ctpase activity, v_super_concept: ribonucleoside triphosphate phosphatase activity, label: 1, axiom: SubClassOf(http://purl.obolibrary.org/obo/GO_0043273 http://purl.obolibrary.org/obo/GO_0017111) }
-
Complex SI 示例:
{ v_sub_concept: ham and cheese sandwich that derives from some lima bean (whole), v_super_concept: lima bean substance, label: 0, axiom: SubClassOf(ObjectIntersectionOf(http://purl.obolibrary.org/obo/FOODON_03307824 ObjectSomeValuesFrom(http://purl.obolibrary.org/obo/RO_0001000 http://purl.obolibrary.org/obo/FOODON_03302053)) http://purl.obolibrary.org/obo/FOODON_00002776), anchor_axiom: EquivalentClasses(http://purl.obolibrary.org/obo/FOODON_00002776 ObjectIntersectionOf(http://purl.obolibrary.org/obo/FOODON_00002000 ObjectSomeValuesFrom(http://purl.obolibrary.org/obo/RO_0001000 http://purl.obolibrary.org/obo/FOODON_03302053)) ) }
-
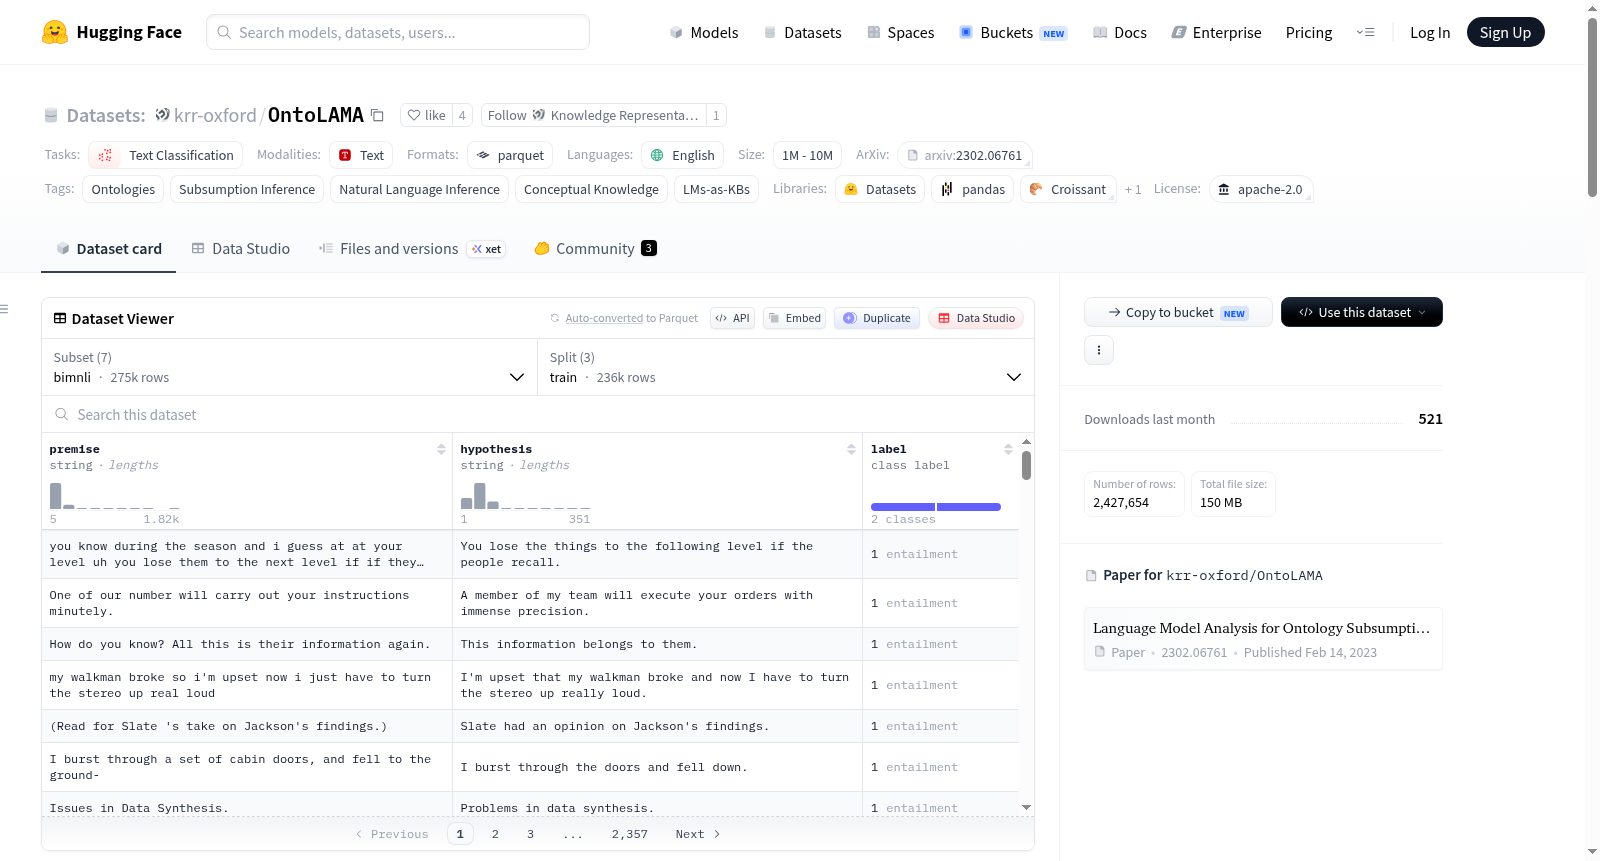
biMNLI 示例:
{ premise: At the turn of the 19th century Los Angeles and Salt Lake City were among the burgeoning metropolises of the new American West., hypothesis: Salt Lake City was booming in the early 19th century., label: 1 }
数据字段
-
SI 数据字段:
v_sub_concept: 口头表达的子概念。v_super_concept: 口头表达的超概念。label: 二元类别标签,指示两个概念是否真的形成包含关系(1表示是)。axiom: 原始包含公理的字符串表示,有助于追溯到本体。anchor_axiom: (仅限复杂SI)用于采样axiom的锚定等价公理的字符串表示。
-
biMNLI 数据字段:
premise: 继承自MNLI数据集。hypothesis: 继承自MNLI数据集。label: 二元类别标签,指示矛盾(0)或蕴含(1)。
数据分割
| 来源 | #概念名称 | #等价公理 | #数据集 (训练/验证/测试) |
|---|---|---|---|
| Schema.org | 894 | - | Atomic SI: 808/404/2,830 |
| DOID | 11,157 | - | Atomic SI: 90,500/11,312/11,314 |
| FoodOn | 30,995 | 2,383 | Atomic SI: 768,486/96,060/96,062 <br /> Complex SI: 3,754/1,850/13,080 |
| GO | 43,303 | 11,456 | Atomic SI: 772,870/96,608/96,610 <br /> Complex SI: 72,318/9,040/9,040 |
| MNLI | - | - | biMNLI: 235,622/26,180/12,906 |
许可证信息
Apache-2.0