
liupf/KAR4DDI
收藏官方服务:
资源简介:
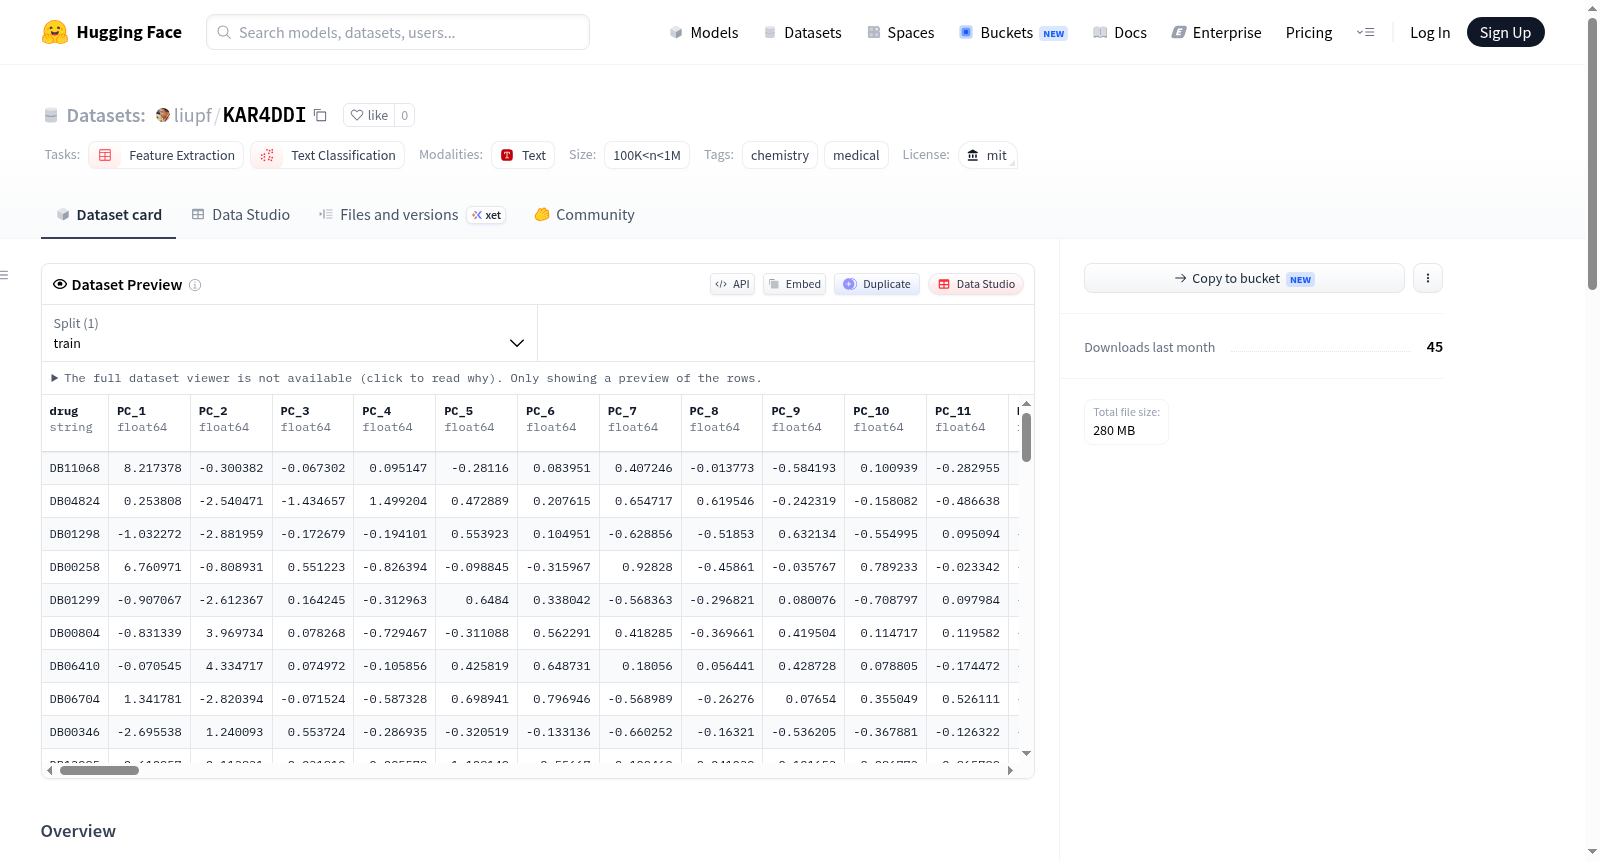
本研究中的数据集是一个药物-药物相互作用事件(DDIE)数据集,来源于DeepDDI 2。该数据集包含2,386种药物的详细信息,每种药物由一个50维的主成分分析(PCA)特征向量和相应的SMILES字符串表示。此外,数据集还整合了来自DDInter和DrugBank的药物描述。DDIE数据集包含222,127对药物,能够预测113种不同的DDIE类型。由于临床环境中罕见和记录不全的药物相互作用频繁发生,处理少样本场景至关重要。数据样本在不同交互频率类别(常见、少量、罕见)中的分布情况也被详细列出,并解释了如何处理不同频率类别的挑战。知识提取方法包括将药物特征转换为药物类型,通过t-SNE进行降维,并使用K-means、Birch和Agglomerative聚类算法进行聚类分析。
本研究中的数据集是一个药物-药物相互作用事件(DDIE)数据集,来源于DeepDDI 2。该数据集包含2,386种药物的详细信息,每种药物由一个50维的主成分分析(PCA)特征向量和相应的SMILES字符串表示。此外,数据集还整合了来自DDInter和DrugBank的药物描述。DDIE数据集包含222,127对药物,能够预测113种不同的DDIE类型。由于临床环境中罕见和记录不全的药物相互作用频繁发生,处理少样本场景至关重要。数据样本在不同交互频率类别(常见、少量、罕见)中的分布情况也被详细列出,并解释了如何处理不同频率类别的挑战。知识提取方法包括将药物特征转换为药物类型,通过t-SNE进行降维,并使用K-means、Birch和Agglomerative聚类算法进行聚类分析。
提供机构:
liupf原始信息汇总
数据集概述
数据集简介
- 名称: Drug-Drug Interaction Event (DDIE) 数据集
- 来源: DeepDDI 2
- 包含信息:
- 2,386种药物的50维主成分分析(PCA)特征向量
- 对应的SMILES字符串
- 来自DDInter和DrugBank的药物描述
- 数据量: 222,127对药物
- 任务类型: 预测113种不同的DDIE类型
数据样本分布
- 分类: 根据DDIE发生频率分为common, few, 和 rare三类
- 分布:
- 训练集:
- Common: 44,126
- Few: 108
- Rare: 43
- 验证集:
- Common: 44,113
- Few: 128
- Rare: 34
- 测试集:
- Common: 132,110
- Few: 298
- Rare: 85
- 训练集:
- 处理:
- 移除少于两个样本的类别
- 剩余样本按2:2:6的比例分配到训练、验证和测试集
知识提取
- 特征转换: 将药物特征转换为药物类型
- 降维: 使用t-SNE将特征降维至2维,便于可视化和聚类
- 聚类算法:
- K-means
- Birch
- Agglomerative clustering
搜集汇总
数据集介绍
构建方式
该数据集名为KAR4DDI,专注于药物-药物相互作用事件(DDIE)的预测。其构建源于DeepDDI 2,整合了2,386种药物的信息,每种药物以50维主成分分析(PCA)特征向量及SMILES字符串表示,并融合了来自DDInter和DrugBank的药物描述。数据集包含222,127个药物对,覆盖113种DDIE类型,为应对临床中罕见且记录不足的药物相互作用场景,特别引入了少样本学习设置。样本根据DDIE出现频率划分为常见、少和罕见三类,并剔除了样本量小于2的类别,最终以2:2:6的比例分配至训练集、验证集和测试集,以提升数据质量与可靠性。
特点
该数据集的核心特点在于其针对药物相互作用中频率分布不均问题的精心设计。通过将样本划分为常见、少和罕见三类,它有效模拟了真实临床场景中罕见相互作用带来的挑战。此外,数据集采用t-SNE降维技术将药物特征转化为2维空间,便于可视化和聚类分析,同时保留数据的局部结构。结合K-means、Birch和凝聚聚类等算法,能够揭示高维特征中的内在模式与关系。这种设计不仅增强了数据集在少样本学习任务中的实用性,还为研究药物相互作用事件提供了丰富的定量分析基础。
使用方法
KAR4DDI数据集适用于特征提取和文本分类任务,尤其在药物相互作用事件预测领域。用户可直接加载药物对的PCA特征向量及SMILES字符串作为输入,结合药物描述文本进行多模态学习。数据集的类别标签涵盖113种DDIE类型,支持少样本场景下的模型训练与评估。使用时可参照给定的2:2:6划分比例,分别构建训练、验证和测试子集。对于特征处理,建议采用t-SNE进行初步降维以探索数据分布,或直接利用原始50维特征进行深度学习建模。该数据集还兼容聚类算法,可用于无监督学习中的模式发现与药物关系挖掘。
背景与挑战
背景概述
药物相互作用事件预测是药物安全领域的关键研究课题,尤其在临床用药风险防控中具有重要价值。该数据集由研究团队基于DeepDDI 2构建,整合了DDInter和DrugBank的药物描述信息,包含2386种药物及其50维主成分分析特征向量与SMILES表达式,共形成222,127个药物对,可预测113种不同类型的药物相互作用事件。数据集的发布时间与具体研究机构虽未明确标注,但其规模与多样性为药物相互作用研究提供了重要资源,尤其通过引入低频交互类别的划分(常见、少量、罕见),显著推动了少样本学习场景下药物安全性预测的发展。
当前挑战
该数据集面临的核心挑战源于药物相互作用事件的频率分布不均衡,其中少量和罕见类别的样本数量极为稀少(如训练集中罕见类别仅43个样本),导致模型在少样本场景下的泛化能力不足。构建过程中,研究者需解决特征降维与聚类分析的适配性问题,例如使用t-SNE将高维特征压缩至二维空间时,可能丢失关键结构信息。此外,不同聚类算法(如K-means、Birch)对预设簇数的敏感性增加了知识提取的复杂性,而类别过滤策略(移除少于两个样本的类别)虽提升数据质量,却也进一步加剧了极低频交互事件的预测难度。
常用场景
经典使用场景
在药物-药物相互作用事件预测领域,KAR4DDI数据集凭借其涵盖222,127个药物对和113种交互类型的丰富规模,成为评估和训练少样本学习与特征提取模型的基准平台。该数据集通过主成分分析将2,386种药物降维至50维特征向量,并结合SMILES字符串与DDInter、DrugBank的药物描述,为多模态融合学习提供了结构化数据基础。其经典使用场景聚焦于对罕见交互事件的精准预测,通过将交互频率划分为常见、少量和罕见三类,研究者能够系统性地检验模型在数据稀疏条件下的泛化能力,特别是在临床中那些记录匮乏却至关重要的药物组合上。
解决学术问题
该数据集的核心学术贡献在于系统性地回应了药物相互作用预测中的少样本学习挑战,即如何从有限样本中挖掘罕见交互的潜在规律。传统方法常因数据不平衡而忽视低频事件,而KAR4DDI通过明确划分频率类别并剔除样本数不足两个的类别,构建了一个更具现实意义和统计可靠性的实验框架。这一设计推动了迁移学习、元学习及对比学习等前沿技术在药物安全领域的应用,使得模型能够在少量正例下捕捉药物结构特征与交互类型之间的深层关联,从而提升对临床罕见但高危的药物组合的预警能力,显著拓展了药物信息学的研究边界。
衍生相关工作
基于KAR4DDI数据集,衍生出了一系列聚焦于少样本药物交互预测的经典工作。研究者们利用t-SNE降维与K-means、Birch及凝聚层次聚类等无监督方法,将药物特征映射至二维空间进行模式分析,揭示了不同交互频率下药物类型的聚类结构。这些工作进一步催生了融合图神经网络与知识图谱的预测框架,通过在药物对之间构建异质图来捕捉高阶语义关系。同时,数据集中对SMILES字符串与描述文本的整合,激发了基于预训练语言模型(如BERT)的序列编码方法,这些方法在少样本场景下展现出卓越的迁移性能,为后续药物发现与安全评估研究奠定了方法论基石。
以上内容由遇见数据集搜集并总结生成


