
cleanrl/summarize_from_feedback_tldr_3_filtered_oai_preprocessing_1704496365
收藏数据链接:
官方服务:
资源简介:
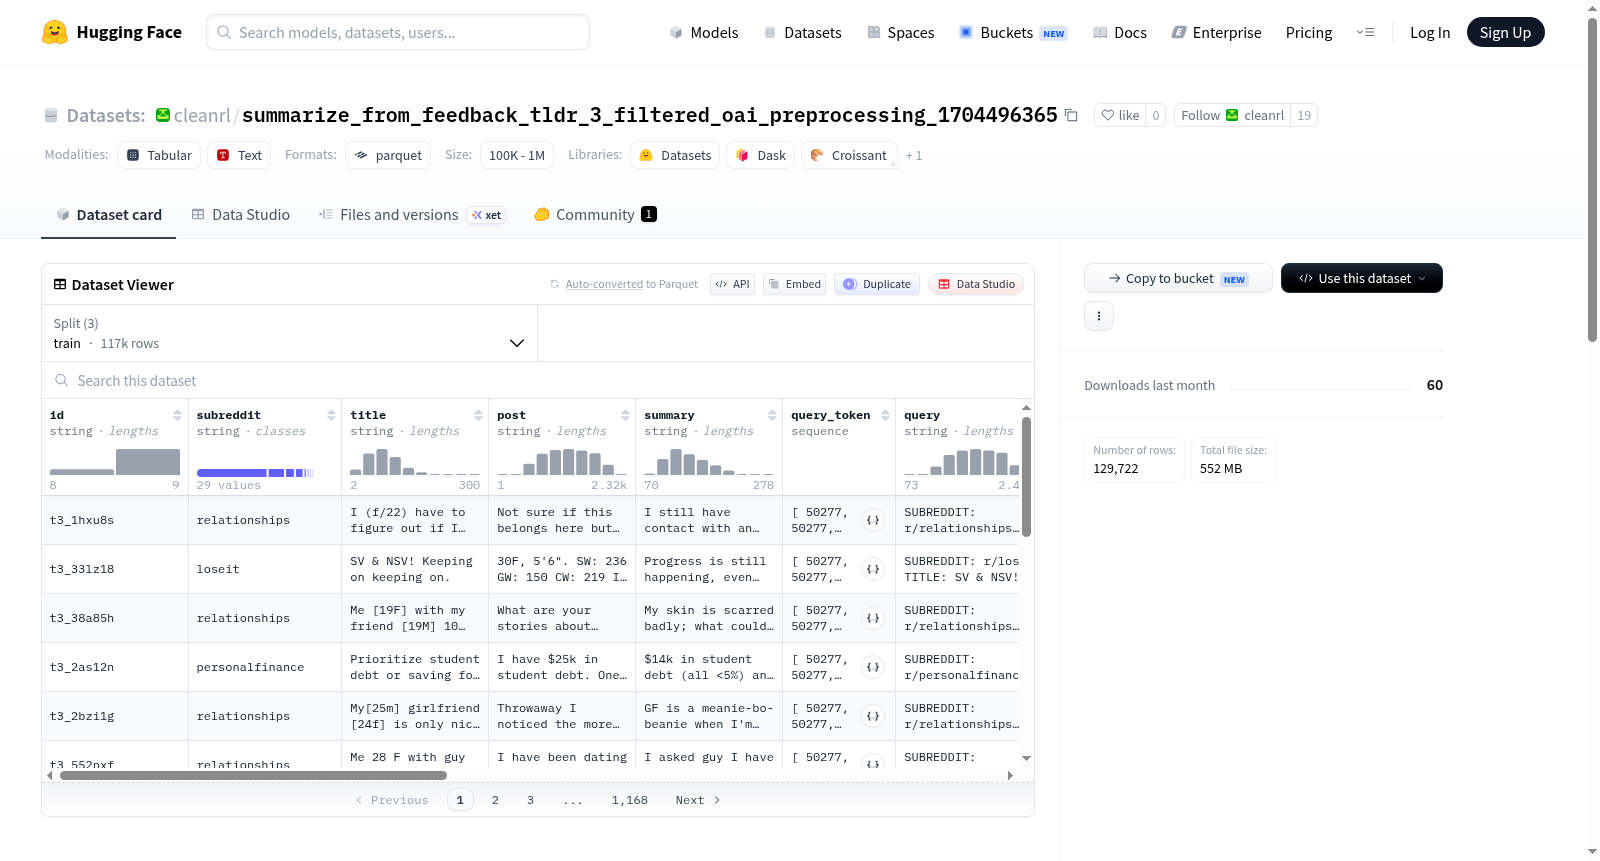
该数据集来源于OpenAI的Summarize from Feedback任务,具体是从Reddit的TL;DR数据集中提取的。数据集包含了多个特征列,如id、subreddit、title、post、summary等,这些列直接从原始数据集中提取。此外,通过预处理脚本添加了一些新的列,如query、query_token、reference_response_token等。数据集分为train、validation和test三个部分,分别包含不同数量的样本和字节大小。
该数据集来源于OpenAI的Summarize from Feedback任务,具体是从Reddit的TL;DR数据集中提取的。数据集包含了多个特征列,如id、subreddit、title、post、summary等,这些列直接从原始数据集中提取。此外,通过预处理脚本添加了一些新的列,如query、query_token、reference_response_token等。数据集分为train、validation和test三个部分,分别包含不同数量的样本和字节大小。
提供机构:
cleanrl原始信息汇总
数据集概述
数据集特征
- id: 帖子唯一标识符,数据类型为字符串。
- subreddit: 帖子来源的子版块,数据类型为字符串。
- title: 帖子标题,数据类型为字符串。
- post: 帖子正文,数据类型为字符串。
- summary: 帖子摘要,数据类型为字符串。
- query_token:
query的标记化版本,数据类型为整数序列。 - query: 用于摘要的长度受限查询,数据类型为字符串。
- reference_response: 帖子的参考回复,数据类型为字符串。
- reference_response_token:
reference_response的标记化版本,数据类型为整数序列。 - reference_response_token_len:
reference_response_token的长度,数据类型为整数。 - query_reference_response:
query.strip()和reference_response的连接,数据类型为字符串。 - query_reference_response_token:
query_reference_response的标记化版本,数据类型为整数序列。 - query_reference_response_token_len:
query_reference_response_token的长度,数据类型为整数。
数据集分割
- train: 训练集,包含116722个样本,总字节数为1600440249。
- validation: 验证集,包含6447个样本,总字节数为88425771。
- test: 测试集,包含6553个样本,总字节数为89922466。
数据集大小
- 下载大小: 551527888字节。
- 数据集大小: 1778788486字节。
搜集汇总
数据集介绍
构建方式
该数据集源自OpenAI的Summarize from Feedback任务,基于Reddit TL;DR语料库构建。原始数据包含帖子唯一标识符、所属子版块、标题、正文及人工撰写的摘要。在此基础上,通过OpenAI预处理脚本进行增强:首先对标题、子版块和正文进行长度限制,确保总token数不超过512,过长时在最后一个换行符处截断,过短则使用[PAD]标记或空格填充,形成标准化的查询字段。随后对查询和参考响应进行分词,并计算其长度。最后将清洗后的查询与参考响应拼接,并再次分词至预设的最大长度,从而生成用于监督式微调(SFT)的训练样本。整个流程确保了输入文本的格式统一和长度可控。
使用方法
使用该数据集时,可直接通过HuggingFace Datasets库加载,利用其内置的字段进行模型训练。对于监督式微调,典型做法是使用'query'字段作为输入,'reference_response'字段作为目标输出。若需进行序列到序列建模,可使用'query_reference_response'字段。分词后的token序列(如'query_token'和'reference_response_token')可直接用于PyTorch或TensorFlow的训练循环,避免重复分词开销。建议根据任务需求选择相应的字段,并利用'token_len'字段进行动态填充或批处理,以提升训练效率。数据集的划分已明确,可直接用于标准的训练、验证和测试流程。
背景与挑战
背景概述
在自然语言处理领域,文本摘要任务长期以来致力于从冗长的原始文本中提炼出简洁而准确的核心信息。随着大规模语言模型的崛起,基于人类反馈的强化学习(RLHF)技术为提升摘要质量开辟了新路径。由OpenAI主导的Summarize from Feedback项目,于2022年发布了Reddit TL;DR数据集,旨在通过收集人类对摘要质量的偏好反馈,训练模型生成更符合人类期望的摘要。cleanrl团队在此基础上进行了精细化预处理,于2023年底推出了过滤与标准化后的版本,主要依托EleutherAI的Pythia-1B模型进行token化处理。该数据集聚焦于跨子版块的帖子摘要生成,通过引入查询长度限制、填充策略等预处理步骤,为监督式微调(SFT)提供了标准化输入输出对,推动了摘要生成模型在可控性和忠实度方面的研究。其影响力体现在为RLHF框架下的摘要任务提供了可靠的数据基础,成为后续诸多文本生成优化工作的基准资源。
当前挑战
该数据集所解决的领域核心挑战在于,传统自动摘要指标(如ROUGE)难以捕捉人类对摘要质量的主观偏好,而基于人类反馈的强化学习需要大量高质量、结构化的偏好数据。构建过程中面临多重困难:首先,原始Reddit帖子内容长度差异悬殊,需设计统一的截断与填充策略(如以512个token为上限,优先在换行符处截断)以保证模型输入的一致性,但这也可能导致关键信息丢失。其次,数据清洗环节需过滤噪声文本(如广告、非英文内容),同时保留不同子版块的风格多样性,这对预处理算法的鲁棒性提出高要求。此外,为适配监督式微调,需将原始帖子与人工撰写的摘要拼接成标准格式,并确保token化后长度不超过预设阈值(如562个token),这一过程涉及复杂的长度权衡与填充符号选择。最后,数据集规模达12万训练样本,如何在海量数据中高效完成预处理流水线,同时避免因GPU内存限制导致的批处理失败,也是工程实现上的显著挑战。
常用场景
经典使用场景
在文本自动摘要生成领域,该数据集被广泛用于训练和评估基于强化学习与人类反馈的摘要模型。其核心设计在于将Reddit社区的长篇帖子与人工撰写的TL;DR摘要配对,并经过OpenAI的预处理流水线对文本进行长度限制和格式统一,使得模型能够在有限上下文内学习从嘈杂、多主题的网络文本中提炼关键信息的技能。研究者常利用该数据集进行有监督微调(SFT),为后续的奖励模型训练和近端策略优化(PPO)奠定基础。
解决学术问题
该数据集解决了摘要生成中两个关键学术问题:一是如何从非结构化、长度不一且包含大量冗余信息的用户生成内容中提取语义核心,二是如何将人类偏好融入摘要质量的评估与优化。通过提供参考摘要和经过长度约束的查询,它使研究者能够系统性地探索序列到序列模型在信息压缩中的边界,并借助人类反馈信号规避传统自动指标(如ROUGE)与人类判断之间的偏差。其意义在于为从“机器生成文本”向“符合人类期望的文本”过渡提供了可复现的实验基准。
实际应用
在实际应用中,该数据集驱动的模型被部署于内容聚合平台、社交媒体信息流和新闻摘要工具中,用于自动生成帖子或文章的简短摘要。例如,Reddit社区的内容推荐系统可借助训练后的模型为用户提供帖子核心观点的快速预览,提升信息筛选效率。此外,该数据集还支持开发面向长文档的智能阅读助手,帮助用户在海量文本中快速定位关键内容,在知识管理、舆情监测和个性化内容分发等场景中具有显著实用价值。
数据集最近研究
最新研究方向
该数据集聚焦于基于人类反馈的文本摘要优化,是OpenAI在强化学习与偏好对齐领域的前沿实践。通过预处理Reddit TL;DR语料,它引入了查询长度限制、分词对齐及参考响应拼接等策略,服务于监督微调(SFT)阶段。当前研究热点围绕如何利用此类高质量对比数据,结合RLHF(基于人类反馈的强化学习)技术提升大语言模型的摘要生成质量与事实一致性。这一方向与AI安全性、可控文本生成等前沿议题紧密相连,其标准化的预处理流程为跨模型比较和可复现研究提供了基准,对推动摘要任务从统计匹配向语义理解与价值对齐的跃迁具有关键意义。
以上内容由遇见数据集搜集并总结生成


