MESSIER
收藏资源简介:
MESSIER是一个用于跨基准测试的AI代理评估的高分辨率语料库,存储和比较代理评估结果,包含模型、支架、任务、验证器和评分信息。
MESSIER is a high-resolution corpus for cross-benchmark AI Agent evaluation, which stores and compares agent evaluation results, encompassing information related to models, backbones, tasks, validators, and scoring.
MESSIER 数据集概述
基本信息
- 名称:MESSIER
- 全称:A High-Resolution Corpus for Cross-Benchmark Agent Evaluation(面向跨基准智能体评估的高分辨率语料库)
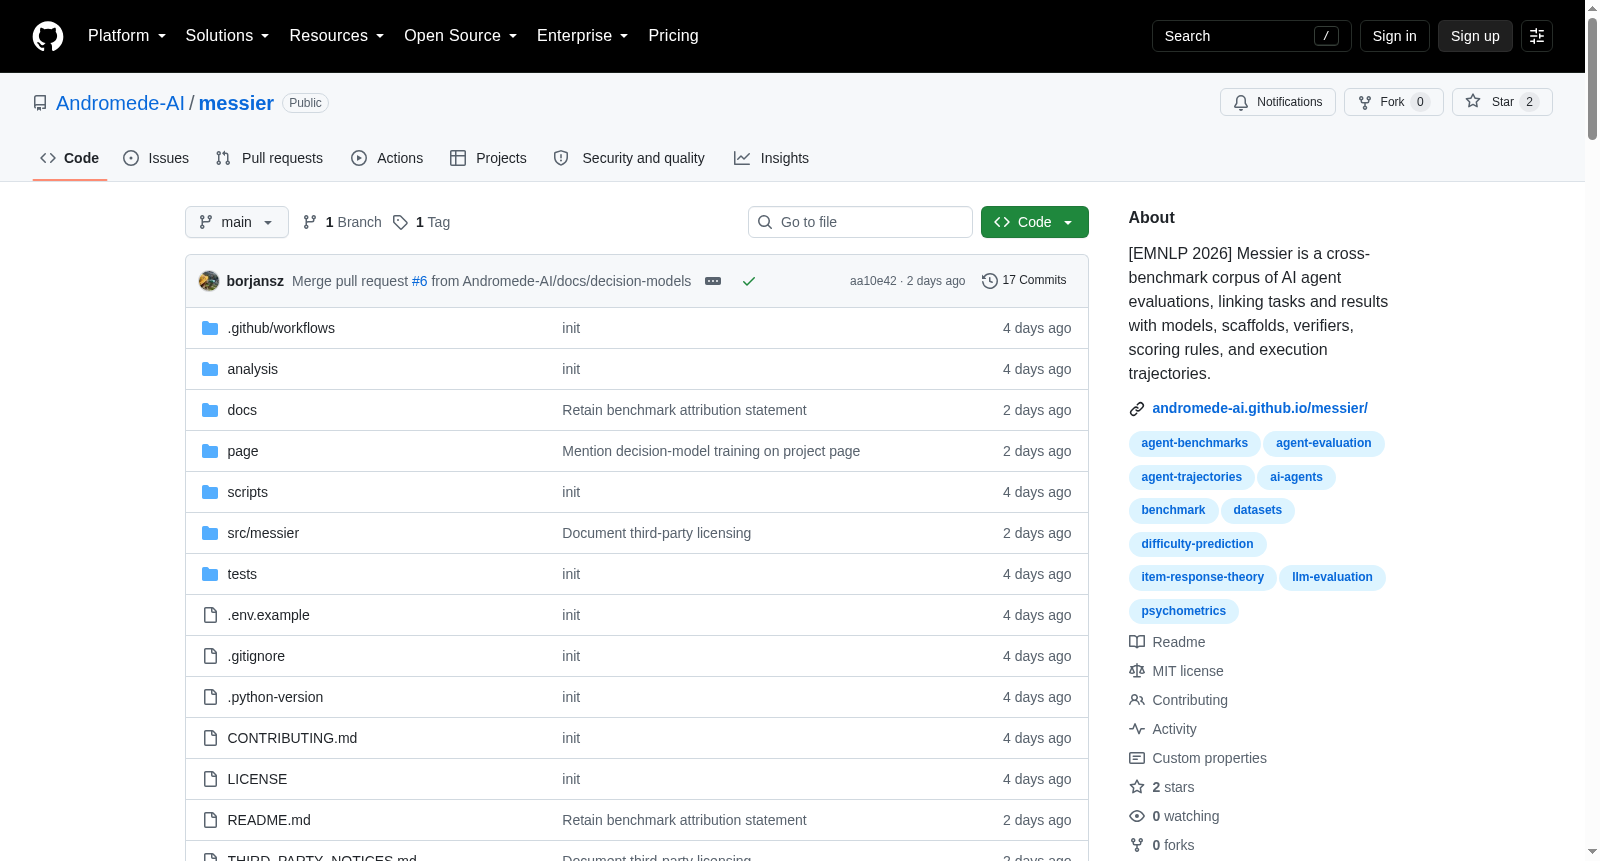
- 仓库地址:https://github.com/Andromede-AI/messier
- 数据集地址:https://huggingface.co/datasets/Andromede-AI/messier
- 项目主页:https://andromede-ai.github.io/messier/
- 论文:https://arxiv.org/abs/2607.25891
- 许可证:MIT
数据集简介
MESSIER 是一个用于存储和比较智能体评估结果的语料库,包含理解每个已发表结果如何产生所需的模型、脚手架(scaffold)、任务、验证器(verifier)和评分信息。该项目旨在枚举智能体评估的各个要素,并在不同基准之间统一其定义与表示。
数据规模
| 类别 | 数量 |
|---|---|
| 基准(Benchmarks) | 31 |
| 智能体(Agents) | 725 |
| 任务(Tasks) | 11,999 |
| 验证器(Verifiers) | 72,000 |
| 记录(Records) | 902,338 |
| 轨迹(Trajectories) | 118,089 |
数据内容
- 包含五张数据表:
tasks、records、verifiers、trajectories、classifications - 每个任务均带有 SOC 和 NAICS 分类,支持跨职业与行业的细粒度分析
- 在可用的情况下提供完整轨迹,以支持对智能体行为的深入分析
- 数据模型涵盖:多种动作空间类型、环境状态与访问、最终验证与顺序验证、模型推理努力程度等
主要功能与用途
- 支持误差分析
- 研究性能随时间、任务难度、模型与脚手架、不同验证器类型等维度的变化
- 通过 SOC 和 NAICS 分类进行职业与行业层面的分析
- 通过完整轨迹分析智能体行为
使用方法
安装
bash git clone https://github.com/Andromede-AI/messier.git cd messier uv sync
如需包含构建器、分析与验证工具:
uv sync --group dev
uv run python
下载数据
从 Hugging Face 下载全部五张表(需超过 9 GB 磁盘空间,轨迹占大部分): python from huggingface_hub import hf_hub_download
for table in ("tasks", "records", "verifiers", "trajectories", "classifications"): hf_hub_download( "Andromede-AI/messier", f"{table}.jsonl", repo_type="dataset", local_dir="data/artifacts" if table == "classifications" else "data/processed", )
Python 加载
python import messier
tasks = messier.tasks() records = messier.records() verifiers = messier.verifiers() trajectories = messier.trajectories()
流式加载(Hugging Face datasets)
python import json from datasets import load_dataset
tasks = load_dataset( "text", data_files="hf://datasets/Andromede-AI/messier/tasks.jsonl", split="train", streaming=True, ).map(lambda row: json.loads(row["text"]), remove_columns=["text"])
快速上手示例
- 收集单个任务的全部存储信息:通过
(benchmark, task_id)键关联五张表 - 在各基准内比较智能体:使用带评分的试验计算成功率
- 按模型发布季度追踪各基准最佳观测结果:运行
analysis/frontier_progress/run.py
文档
- 数据格式与术语:docs/data.md
- 添加基准:docs/builders.md
- 发布指南:docs/publishing.md
- 贡献指南:CONTRIBUTING.md
更新动态
- [26/10/2026] 将在 EMNLP 2026 主会议展示 MESSIER
- [09/10/2026] 论文 Predicting Task Difficulty Without Rollouts 将在 COLM 2026 Agent Behavior Workshop(WAB)以海报形式展示
- [26/09/2026] 发布 MESSIER 首个公开版本
- [13/09/2026] 数据模型更新,新增
extra_context,添加来自 HarveyAI-Lab、GDPval、DABStep、OSWorld、Toolathlon 的任务文件 - [05/09/2026] 更新 MathArena 至更新的固定源版本,并将 APEX 移至完整三片发布
- [27/08/2026] 新增 Toolathlon,包含 32 个应用的 108 个任务与 604 个工具,以及 22 个模型配置的 7,116 条结果
- [12/08/2026] 扩展数据模型以区分多种动作空间类型、环境状态与访问、最终与顺序验证及模型推理努力程度;修订 SOC 与 NAICS 分类
- [01–02/08/2026] 在 Berkeley RDI Summit 以海报形式展示 MESSIER
- [28/07/2026] 发布并公开 MESSIER 第一版
引用
bibtex @article{krsteski2026messier, title={Messier: A High-Resolution Corpus for Cross-Benchmark Agent Evaluation}, author={Krsteski, Stefan and Meyer, Charlotte and Allegre, Guillaume and OHalloran, Tony and Sallinen, Alexandre}, journal={arXiv preprint arXiv:2607.25891}, year={2026} }
后续扩展论文: bibtex @article{krsteski2026predicting, title={Predicting Task Difficulty Without Rollouts}, author={Krsteski, Stefan and Meyer, Charlotte}, journal={arXiv preprint arXiv:2608.05797}, year={2026} }
免责声明
MESSIER 包含来自原始基准和结果提供方的材料,其所有权和知识产权受到尊重。第三方材料仍受其原始条款约束,并记录于 THIRD_PARTY_NOTICES.md 中。