
MathArena/apex-shortlist
收藏官方服务:
资源简介:
该数据集包含来自MathArena Apex Shortlist 2025的问题。这些问题是从2025年各种竞赛中选出的,当前最先进模型在这些问题上的得分约为50%。
This dataset contains the questions from MathArena Apex Shortlist 2025. This contains problems on which current state-of-the-art models score approximately 50%, selected from various 2025 competitions.
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
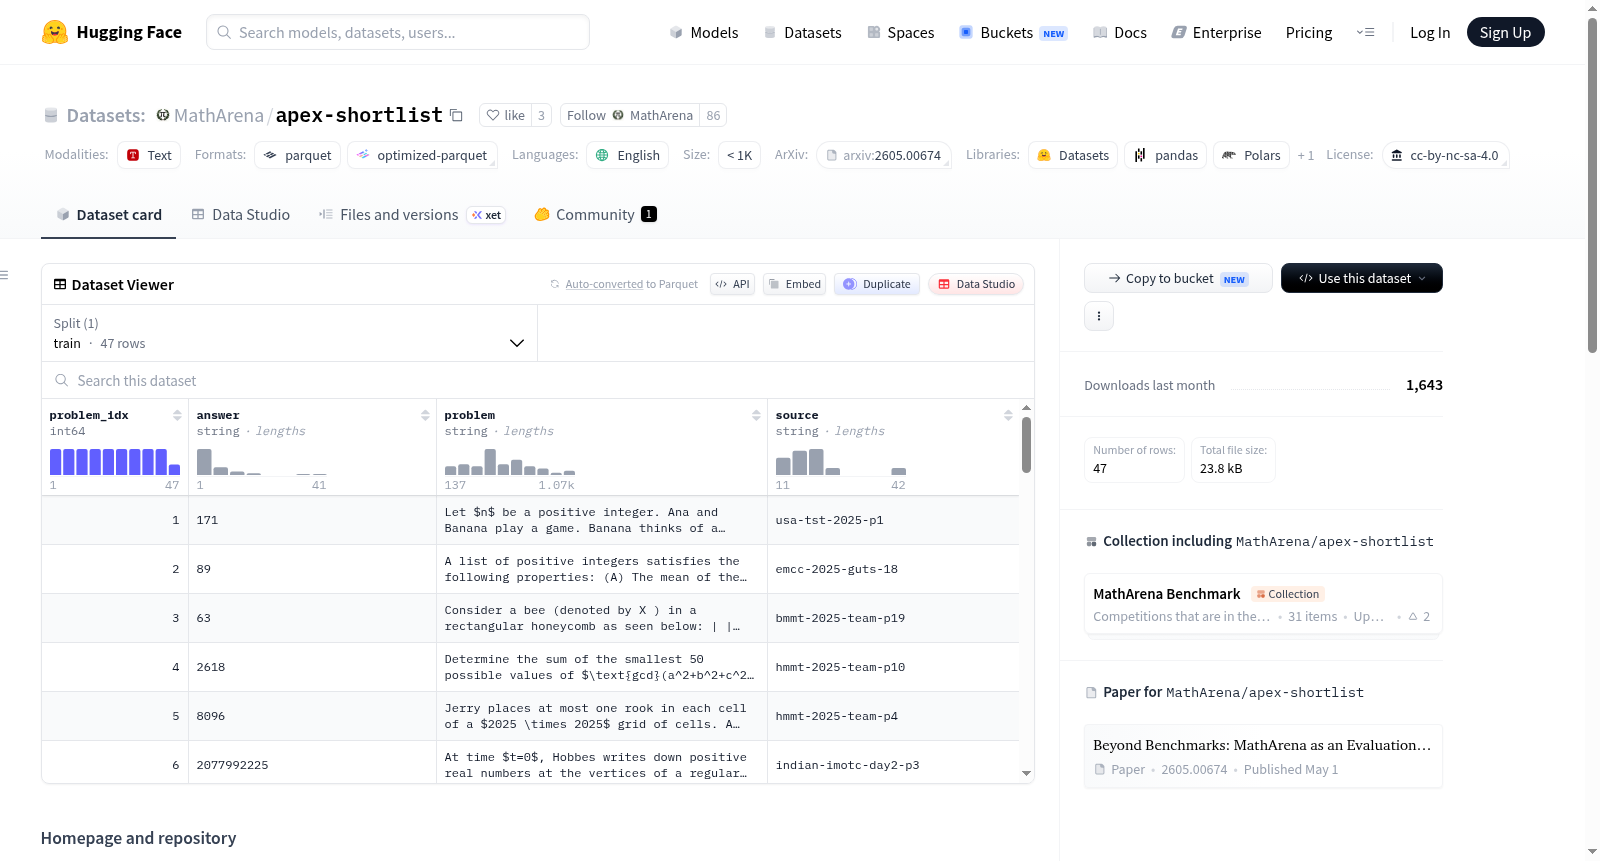
Apex-Shortlist数据集的构建源自2025年多项国际数学竞赛的题目精选。原始题目经过系统化的提取、转换与验证流程,被统一转化为LaTeX格式,以确保数学符号的精确表达与兼容性。随后,通过严格的筛选标准,从海量竞赛题中挑选出当前最先进模型正确率约为50%的中等难度问题,形成这一短名单。数据集以结构化形式存储,每条记录包含问题索引、黄金标准答案、题目来源标识及LaTeX格式的问题陈述,共计47个样本,服务于模型推理能力的精细化评估。
特点
该数据集的核心特点在于其针对性的难度设计,聚焦于当前大语言模型在数学推理上的瓶颈区域——约50%的正确率区间,从而提供更具区分度的评测能力。所有题目均源自真实竞赛环境,保证了问题的严谨性与多样性。数据格式高度规范化,采用LaTeX编码,便于直接集成到基于文本的模型评估管线中。此外,数据集采用CC BY-NC-SA 4.0许可协议,鼓励非商业性研究与共享,同时通过公开的GitHub仓库确保可复现性与社区协作。
使用方法
使用Apex-Shortlist数据集时,研究者可将其作为模型数学推理能力的基准测试集。推荐通过Hugging Face Datasets库直接加载,利用默认配置读取训练分片中的47个样本。每条数据中的'problem'字段可直接作为模型输入,通过模型生成答案并与'answer'字段中的黄金标准进行比对,计算准确率。由于数据量较小,适合快速迭代验证模型改进效果,亦可用于构建更为复杂的评估流程,如结合CoT或多数投票策略。结果提交时需遵守CC BY-NC-SA 4.0许可,并引用相关文献。
背景与挑战
背景概述
在大型语言模型(LLM)数学推理能力评估领域,现有基准测试普遍面临模型性能趋近饱和的困境,亟需能够精确区分前沿模型能力的挑战性数据集。由苏黎世联邦理工学院(ETH Zurich)安全可靠智能系统实验室的Jasper Dekoninck、Nikola Jovanović等研究人员于2025年创建的MathArena Apex Shortlist数据集,正是为应对这一需求而生。该数据集精选自2025年各类数学竞赛,经LaTeX格式化与严格验证后,形成47道高难度问题,当前最先进模型在其上的正确率约为50%,从而为评估LLM数学推理的上限提供了精准的“试金石”。作为MathArena评估平台的核心组件,该数据集为衡量LLM超越常规基准的真实能力开辟了新路径,对推动数学推理领域研究具有重要标杆意义。
当前挑战
该数据集面临的核心挑战在于领域问题的精确定位:现有基准测试中模型得分普遍偏高,难以区分顶尖模型的细微差异,因此需要构建一个难度适中、模型正确率恰好落在50%左右的测试集,以有效衡量和引导LLM数学推理能力的进阶。在构建过程中,挑战尤为突出:研究人员必须从纷繁的2025年赛事中筛选出难度匹配的原始题目,并经过复杂的LaTeX格式转换与多轮验证,确保47道问题在数学严谨性与呈现一致性上毫无瑕疵。由于样本量极小(仅47条记录),任何一道题目的表述偏差或答案误差都可能导致评估失真,这对题目筛选标准与质量控制流程提出了极高要求。
常用场景
经典使用场景
在数学推理与大型语言模型评估领域,MathArena Apex Shortlist 2025数据集堪称一块试金石。它精选自2025年各类数学竞赛的题目,当前最先进模型在其上的准确率仅徘徊于50%左右,因而成为衡量模型推理能力极限的理想标尺。研究者通常将其作为测试集,评估不同架构、训练策略或提示工程方法对数学解题性能的提升效果。该数据集的题目以LaTeX格式存储,适合自动化解析与评估,广泛应用于监督微调、强化学习及上下文学习等范式的对比实验。
解决学术问题
该数据集直面当前大语言模型在复杂数学推理中表现不佳的核心困境。传统评测基准如GSM8K或MATH已逐渐饱和,模型得分逼近天花板,难以区分细微性能差异。Apex Shortlist通过引入更高难度、更富技巧性的竞赛题目,精准定位模型的薄弱环节,揭示了现有方法在符号操作、多步推理与抽象建模上的根本局限。其发布推动了关于数学推理评估标准化的学术讨论,促使研究者重新思考模型泛化能力与问题求解深度的关联,为设计更具挑战性与区分度的评测体系树立了新标杆。
衍生相关工作
围绕Apex Shortlist已涌现一批重要衍生工作。最直接的便是MathArena评测平台本身,它基于该数据集构建了持续更新的动态排行榜,定期追踪前沿模型在数学推理上的演进。此外,有研究利用该数据集分析了模型在不同难度区间上的表现退化模式,进而提出针对性训练策略如过程监督与反向课程学习。另一些工作则将其与其他数学数据集结合,构建多任务训练集以提升模型泛化性。该数据集还常被用作迁移学习或领域适应实验的源域,验证从竞赛题目到实际应用题的知识迁移效果。
以上内容由遇见数据集搜集并总结生成


