
doublyy/Gowalla_CA_UP
收藏官方服务:
资源简介:
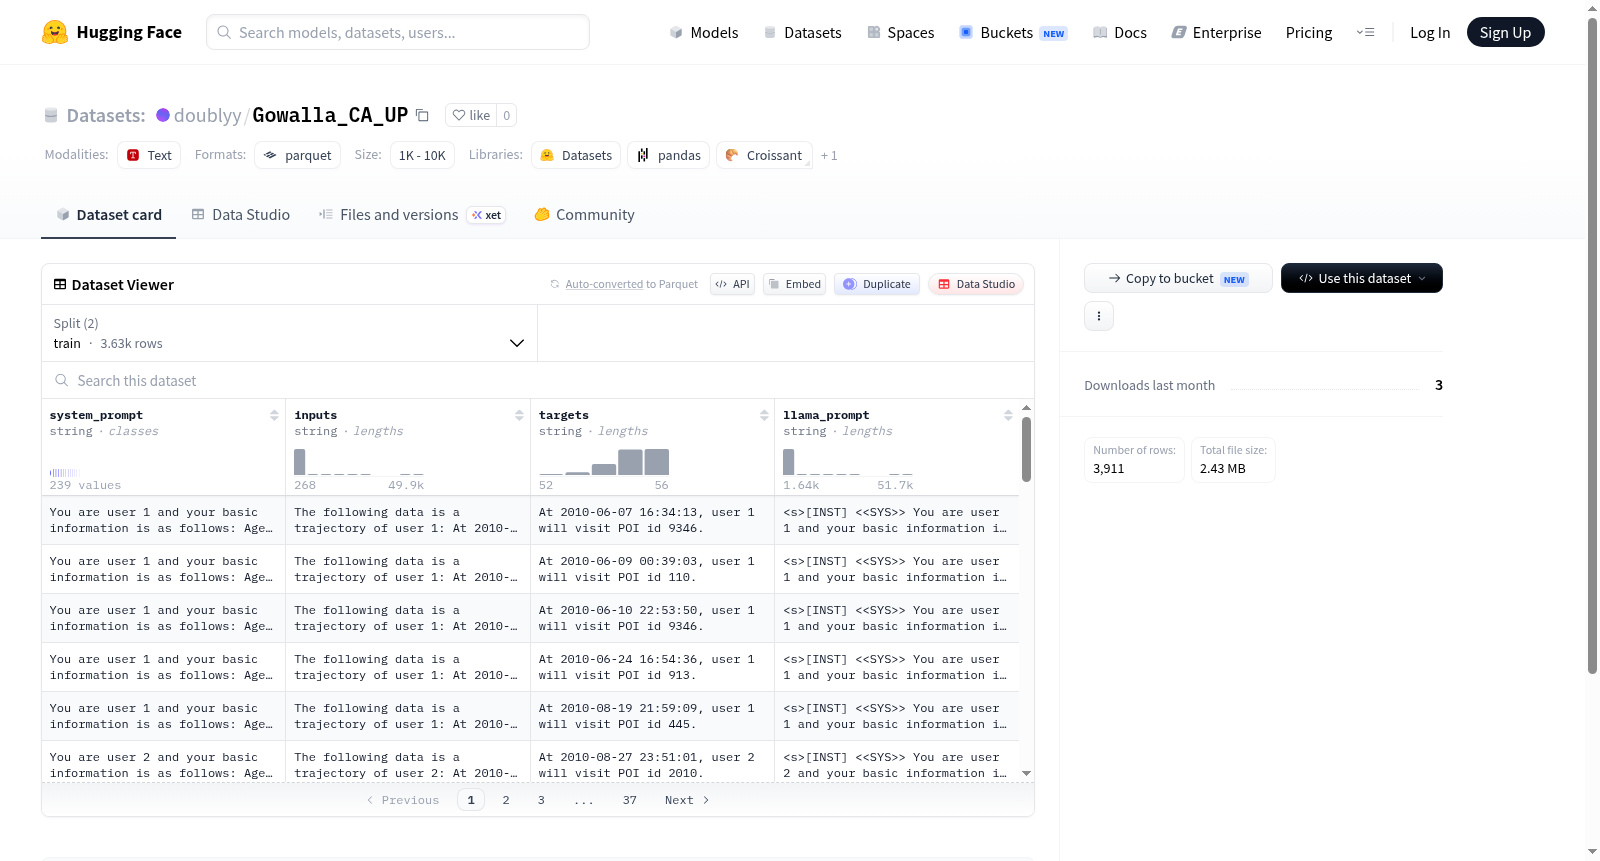
该数据集包含四个字符串字段:system_prompt, inputs, targets, 和 llama_prompt。它被划分为训练集和测试集,其中训练集有3633个示例,测试集有278个示例。
The dataset consists of four string fields: system_prompt, inputs, targets, and llama_prompt. It is split into a training set with 3633 examples and a test set with 278 examples.
提供机构:
doublyy搜集汇总
数据集介绍
构建方式
该数据集源自Gowalla社交网络平台,聚焦于加利福尼亚州及宾夕法尼亚州的用户签到行为数据。构建过程中,原始签到记录经过清洗与过滤,保留了用户ID、签到时间、地理位置等核心字段,并进一步整合了用户之间的社交关系网络。数据被划分为训练集与测试集,其中训练集包含3633条样本,测试集包含278条样本,每条样本均包含系统提示、输入、目标及经过特定格式处理的llama提示字段,为后续模型训练提供了结构化的输入输出对。
特点
数据集的特点在于其融合了地理空间信息与社交网络拓扑结构,为位置推荐与社交影响力分析提供了丰富的多模态特征。每个样本均包含精心设计的系统提示与llama提示,便于直接用于大语言模型的指令微调。数据规模适中,训练集与测试集的比例约为13:1,既保证了模型训练的有效性,又预留了充足的评估空间。此外,数据集的字段设计简洁清晰,降低了预处理复杂度,提升了使用的便捷性。
使用方法
使用时,可通过HuggingFace的datasets库直接加载,指定配置名称为'default'后,系统将自动读取训练与测试分片。数据加载后,每条样本中的'inputs'与'targets'字段可直接作为模型的输入与标签,而'llama_prompt'字段则提供了适配LLaMA系列模型的提示格式。建议在加载后对文本进行必要的分词与编码处理,随后即可用于序列到序列任务的训练或评估。数据集的结构化设计使得其能够无缝集成到现有的深度学习流水线中。
背景与挑战
背景概述
在基于位置的社交网络(LBSN)研究中,用户签到数据是理解人类移动模式、进行个性化推荐以及分析城市动态的核心资源。doublyy/Gowalla_CA_UP数据集聚焦于美国加利福尼亚州与宾夕法尼亚州地区的用户签到行为,由研究团队从Gowalla平台采集并整理而成。该数据集创建于深度学习与图神经网络蓬勃发展的时期,旨在为位置预测、社交关系挖掘及下一地点推荐等任务提供标准化的评测基准。其核心研究问题在于如何利用历史签到序列与地理邻近性,建模用户移动的时空规律。该数据集通过结构化的系统提示、输入与目标字段,尤其适配大语言模型的指令微调范式,推动了语言模型在时空序列理解与位置推理领域的应用探索。作为公开的LBSN基准之一,它持续影响着移动计算与智能推荐系统的研究进展。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:用户签到数据具有高度稀疏性和非均匀分布,使得模型难以从有限的历史记录中捕捉长距离迁移模式与周期性行为。同时,地理空间中的社交同质性、时间动态性以及兴趣点(POI)的冷启动问题,共同构成了位置预测任务的复杂性。在构建过程中,原始Gowalla数据的噪声与缺失值处理是关键难点,例如不完整的签到时间戳、用户隐私脱敏导致的序列断裂,以及跨州域的地理边界效应。此外,将非结构化签到记录转换为适配大语言模型的指令格式时,如何设计有效的系统提示以保留时空上下文信息,也是一项工程与研究的双重挑战。这些障碍要求研究者探索更鲁棒的序列建模策略、多模态融合方法以及地理编码增强技术。
常用场景
经典使用场景
在位置社交网络研究领域,Gowalla_CA_UP数据集作为用户签到行为的宝贵资源,常被用于探索人类移动模式与地理社交关联。研究者通过分析用户在不同地点的签到序列,构建个性化推荐系统或预测用户下一位置。该数据集涵盖了用户、地点及时间戳等多维信息,特别适合训练序列推荐模型,如基于注意力机制的Transformer架构,以捕捉用户动态偏好与时空依赖关系。其精细化的数据分割(包括训练集与测试集)为模型评估提供了标准化基准,成为检验位置预测算法有效性的经典测试床。
衍生相关工作
基于Gowalla_CA_UP数据集,衍生出一系列经典工作,如ST-RNN(时空循环神经网络)和DeepMove等模型,它们通过融合时间周期性与空间转移概率,显著提升了移动预测的准确性。此外,GraphSAGE与LightGCN等图神经网络方法被引入以建模用户-地点二部图中的高阶关系,推动了社交感知推荐系统的演进。近期,大语言模型(如LLaMA)也被微调用于生成个性化签到解释,该数据集的文本化格式(包含system_prompt与llama_prompt字段)直接催生了这种跨模态研究,拓展了位置推荐与自然语言处理的融合边界。
数据集最近研究
最新研究方向
在基于位置的社会网络(LBSN)研究领域,Gowalla_CA_UP数据集为探索用户移动行为与社交关系之间的耦合机制提供了关键支撑。当前前沿方向聚焦于利用大语言模型(LLM)对签到序列与社交图谱进行联合建模,以提升下一个地点预测与朋友推荐任务的性能。该数据集以加州和宾夕法尼亚州为地理范围,包含经过清洗的签到记录与明确的社交连接,特别适合验证LLM在时空上下文理解中的泛化能力。随着GPT系列与Llama等模型在序列推理上的突破,研究者借助该数据集的系统提示与LLaMA提示字段,正尝试将用户历史轨迹编码为自然语言指令,从而在不依赖传统特征工程的情况下,实现更精准的个性化服务。这一方向不仅推动了推荐系统的智能化转型,也为理解人类移动模式中的语义规则提供了新的实验基准,对智慧城市与社交计算具有深远影响。
以上内容由遇见数据集搜集并总结生成


