
遇见数据集

AxiomicLabs/LogicMark

收藏
Hugging Face2026-05-05 更新2026-04-12 收录
官方服务:

资源简介:

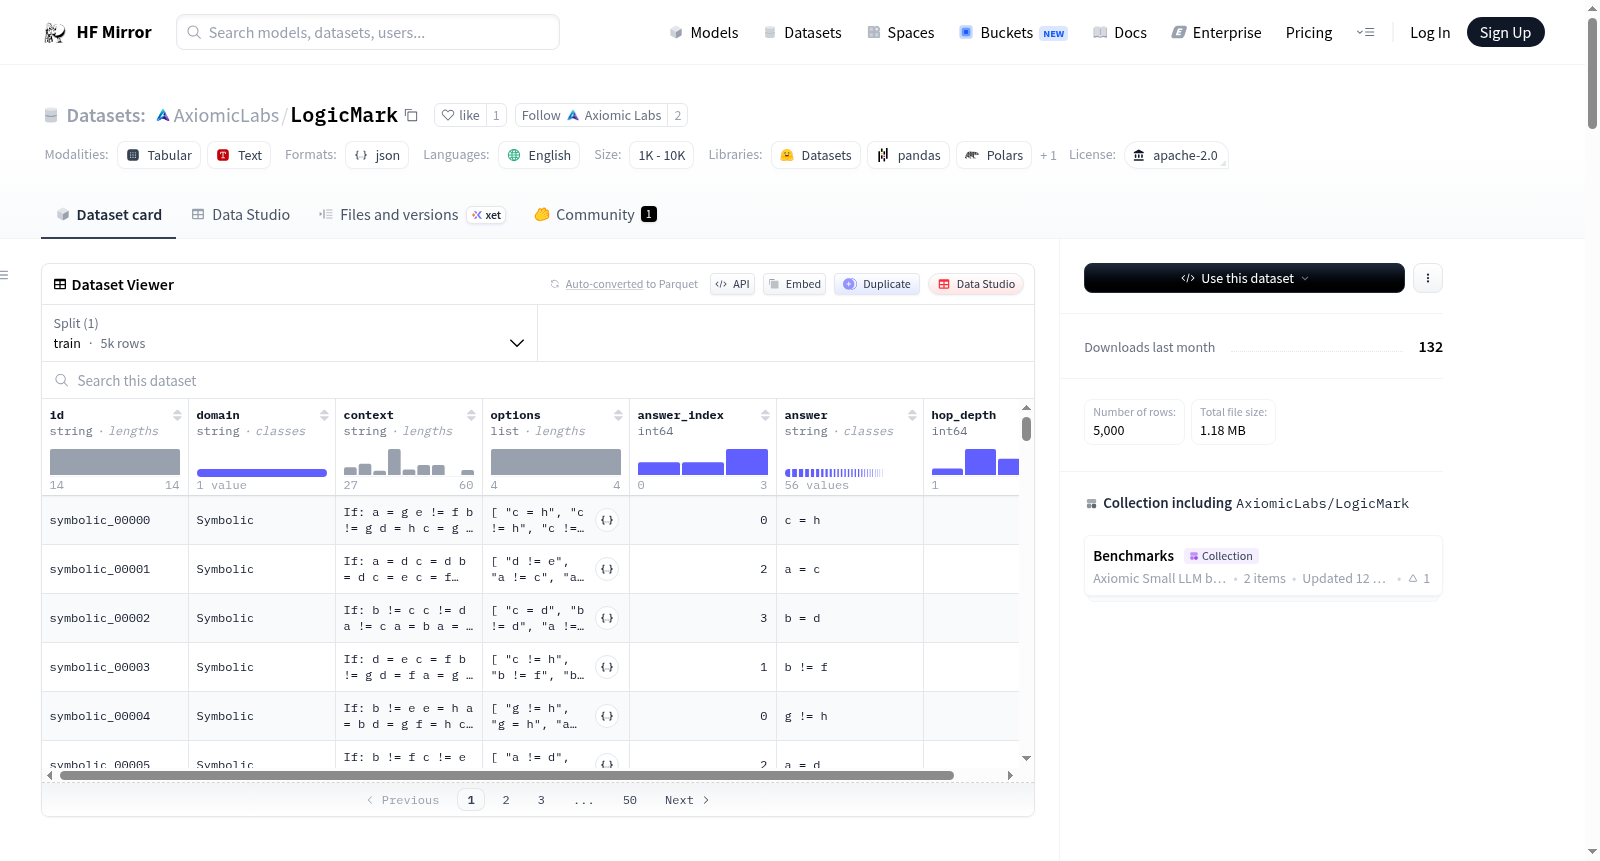
LogicMark是一个程序生成的基准测试,用于评估语言模型中的符号逻辑推理能力。每个问题呈现一组变量相等/不相等的前提,并要求模型识别哪个结论必然成立。与基于知识的基准不同,LogicMark不包含模型可能从预训练中记忆的任何事实。每个问题都使用抽象变量名(a, b, c, ...)新鲜生成,因此模型无法通过模式匹配训练数据,必须实际进行推理。这使得LogicMark成为对内在推理能力的直接探测:即通过训练构建到模型权重中的逻辑结构,独立于世界知识或表面启发式方法。评估采用对数似然多项选择方式,无需思维链或提示技巧,模型仅根据为正确完成分配概率的能力进行评分。

LogicMark is a procedurally generated benchmark for evaluating symbolic logic in language models. Each problem presents a set of variable equality/inequality premises and asks the model to identify which conclusion necessarily follows. Unlike knowledge-based benchmarks, LogicMark contains no facts a model could have memorised from pretraining. Every problem is generated fresh from abstract variable names (a, b, c, ...), so a model cannot pattern-match to training data - it must actually reason. This makes LogicMark a direct probe of intrinsic reasoning capability: the logical structure that has been built into the models weights through training, independent of world knowledge or surface-level heuristics. Evaluation is log-likelihood multiple-choice — no chain-of-thought, no prompting tricks. Models are scored purely on how well they assign probability to the correct completion.
提供机构:
AxiomicLabs
搜集汇总
数据集介绍
AxiomicLabs/LogicMark 数据集图片
构建方式
LogicMark基准测试集采用程序化生成方式构建,旨在评估语言模型在符号逻辑推理方面的能力。每个问题均以抽象变量名(如a、b、c)构建等式与不等式前提,并随机生成正确的推论选项及干扰项。构建过程通过图拓扑结构控制推理链的跳数深度(hop depth),涵盖链式、星形、聚类、树状、二分及混合六种图样式,并利用拒绝采样精确匹配目标跳数分布。此外,答案类型在等式与不等式之间保持50/50平衡,且始终包含正确答案的否定形式作为干扰项,以防止模型通过表面模式获取正确结果。
特点
LogicMark的核心特点在于其纯粹的逻辑推理评估属性。所有问题均从抽象变量生成,不存在任何模型可从预训练数据中记忆的事实知识,从而直接探测模型的内在推理能力而非知识检索水平。该测试集采用对数似然多选评估方式,无需链式思维或提示技巧,通过模型对正确补全的赋分能力量化其推理性能。数据集按推理跳数(1至5跳)分层标注,支持细粒度分析模型在不同复杂度推理链上的表现,并开放六种图拓扑结构以考察不同推理模式下的能力差异。
使用方法
使用LogicMark时,用户可直接加载Hugging Face数据集并调用预定义评估脚本。模型需接收形如'If: ... Then'的文本上下文,并从四个选项中选出逻辑上必然成立的结论。评估基于对数似然分数,通过比较模型对每个选项结尾标记的平均概率进行正确性判断,结果以各跳数层次的准确率呈现。用户可借助提供的baseloggen_v2.py生成器调整问题数量、变量范围、跳数分布及图样式等参数,从而定制适合自身研究需求的测试子集,并重复上述评估流程。
背景与挑战
背景概述
LogicMark数据集由Axiomic Labs于近期创建,旨在专门评估语言模型的符号逻辑推理能力。与依赖常识或事实记忆的传统基准不同,该数据集通过程序化生成基于抽象变量名(如a、b、c)的等式与不等式前提,迫使模型必须依赖纯粹的逻辑推演而非训练数据中的模式匹配来得出结论。这一设计直指大语言模型的核心研究问题:其权重中是否内化了真正的推理结构?通过控制推理步长(hop depth)并采用六种图拓扑结构(如链式、星型、树型)生成题目,LogicMark能够细致剖析模型在不同推理复杂度下的表现。在已评估的多个主流模型(如Qwen2.5、Pythia、GPT-2系列)中,性能随推理步长增加而显著下降,揭示了当前模型的逻辑推理能力仍十分有限,从而为领域提供了更具诊断性的评估工具。
当前挑战
LogicMark所解决的领域核心挑战在于,现有自然语言处理基准(如常识问答或文本蕴含)往往混合了知识记忆与逻辑推理,无法独立衡量模型的因果推演能力。该数据集通过去除所有可被记忆的语义信息,专门针对符号逻辑中的传递性(transitive)推理设计了1至5跳的递进式难题,每个问题均包含干扰项(如正确答案的否定形式),迫使模型必须进行精确的演绎推理。在构建过程中,关键挑战包括:1)确保前提图在给定跳数下具有唯一可推导结论,避免多解或歧义;2)通过拒绝采样(rejection sampling)精确平衡不同跳数的样本比例(如10%的1跳、40%的2跳),以反映推理深度对模型性能的梯度影响;3)控制等式与不等式类型的分布(各占50%),防止模型利用统计偏差(如更倾向于选择等式结论)来取巧获胜。
常用场景
经典使用场景
LogicMark数据集专为评估语言模型内在推理能力而设计,其核心在于通过程序化生成的符号逻辑问题,剥离外部知识对模型表现的干扰。每一道题目均采用抽象变量(如a、b、c)构成的等式或不等式前提,要求模型从四个候选结论中甄别出必然成立的逻辑推论。该数据集包含5000个样本,覆盖从1跳至5跳的推理深度阶梯,并引入链式、星形、簇状、树形、二分及混合六种图拓扑结构,全方位考察模型在不同逻辑复杂性下的演绎推理能力。评估采用对数似然多选机制,摒弃链式思维或提示技巧,仅基于模型对正确选项概率分配的精准度进行评分,从而提供对模型符号推理本质能力的纯净度量。
衍生相关工作
LogicMark的诞生催生了一系列后续研究路径,其中最直接的是基于其生成框架开发更复杂的逻辑推理基准。研究者可能扩展变量类型、引入模态逻辑或非单调推理规则,以覆盖更广泛的推理范式。此外,该数据集已成为评估新兴推理增强方法的标准参照,例如对比链式思维提示与隐式推理在不同模型上的效果。其精细化的跳数标签与拓扑分类为分析模型推理深度与结构偏好提供了量化基础,启发了诸如逻辑规则蒸馏、推理任务自适应训练等方向的工作。在模型比较层面,LogicMark排名榜持续被引用于发布新模型的符号推理能力评估报告,推动着语言模型从浅层模式匹配向深层逻辑理解的长足演进。
数据集最近研究
最新研究方向
LogicMark数据集聚焦于评估大语言模型在抽象符号逻辑推理上的原生能力,摒弃了传统基准测试中对事实记忆的依赖,通过程序化生成的等式与不等式前提,迫使模型进行真正的逻辑推导。当前研究前沿集中在多跳推理链的深度效应与模型参数量、架构设计的关联性上,例如在1至5跳的难度梯度中,不同规模模型的表现呈现出显著分化,揭示了参数规模与推理深度之间的非线性关系。该数据集对Graph Topology(链式、星型、簇群等)的精细化设计,进一步探索了逻辑结构复杂度对模型泛化能力的挑战,为构建更鲁棒的推理引擎提供了关键评测工具,其意义在于推动语言模型从表面模式匹配向内在符号运算能力的跃迁。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

