
guangchen/prismaga
收藏官方服务:
资源简介:
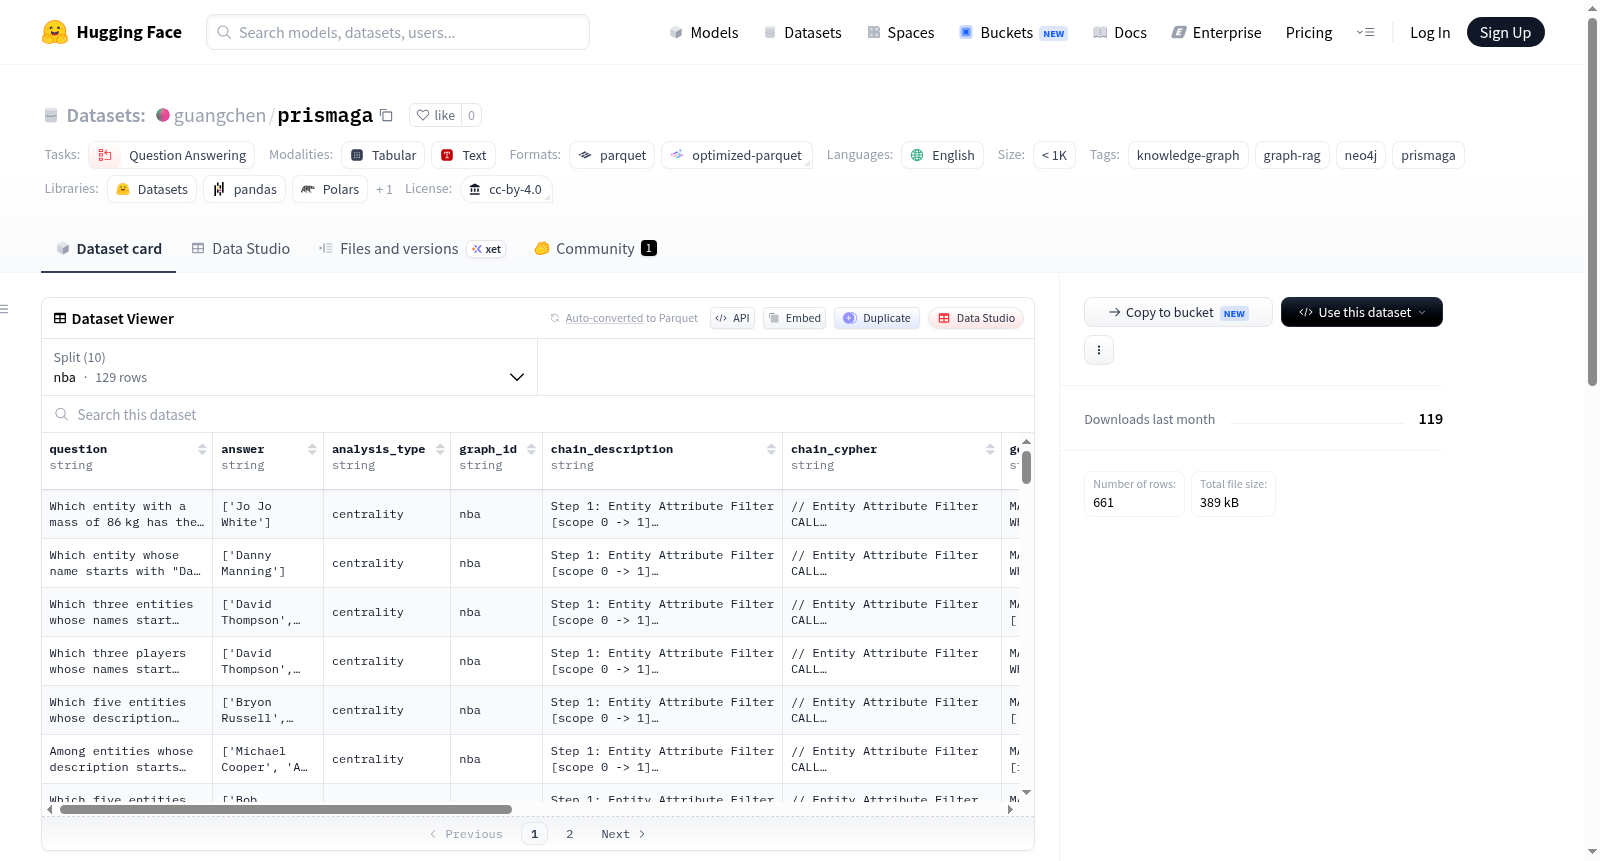
PrismaGA Graph-Analysis QA数据集是由PrismaGA生成的基于图的问答对。每一行包含一个自然语言问题、一个已验证答案,以及用于生成答案的溯源链(包括Cypher查询和子图统计)。每个源知识图谱(数据站点)作为一个独立的分割,所有分割共享相同的模式。
Graph-grounded QA pairs generated by PrismaGA. Each row contains a natural-language question, a verified answer, and the provenance chain (Cypher query + subgraph statistics) used to produce it.
提供机构:
guangchen搜集汇总
数据集介绍
构建方式
PrismaGA数据集由图谱问答对生成框架PrismaGA构建,每个样本均源自结构化知识图谱。数据集的构建过程首先对自然语言问题进行解析,随后通过作用域脚手架机制生成一条可执行的Cypher查询链,该链从图谱中检索出对应的答案子图。每条记录不仅包含原始自然语言问题与经过验证的答案,还保留了完整的溯源链条,包括简洁可读的Cypher查询、机械化的链式查询以及子图的统计特征。所有问答对均经过严格验证,确保答案与图谱检索结果完全一致。
特点
该数据集最显著的特征在于其多领域覆盖与结构化溯源能力。数据涵盖篮球、空难、足球、电影、政治、地理、公司、生物学、虚构人物及恐怖袭击等十个截然不同的知识领域,每个领域均作为独立的数据拆分存在。每条样本均提供多层次的Cypher查询表示,既有面向人类理解的自然语言描述,也有经过优化、可直接复现的标准查询。此外,数据集详细记录了答案子图的节点与关系数量、标签类型等信息,为评估图谱问答系统的推理深度与知识覆盖度提供了丰富维度。
使用方法
数据集通过HuggingFace Datasets库加载,使用者可根据研究需求选择特定领域的子集,例如加载篮球领域数据使用`load_dataset('guangchen/prismaga', split='nba')`。每条样本中的question字段可直接作为图谱问答模型的输入,answer字段作为标准答案用于评估。gold_cypher字段提供了可复现的Cypher查询,适合用于训练文本到Cypher查询的转换模型或验证检索逻辑的准确性。subgraph相关的统计字段则可用于分析问答任务的子图复杂度与知识图谱的覆盖特性。
背景与挑战
背景概述
PrismaGA数据集由Guangchen等人于近期构建,旨在弥补知识图谱问答领域中自然语言与图数据库查询之间语义鸿沟的挑战。该数据集涵盖了从NBA赛事、航空事故、足球比赛到生物、政治、地理等十个异构知识图谱域,每一组问答对均包含经过验证的自然语言问题、精确答案以及对应的Cypher查询链与子图统计信息。核心研究问题聚焦于如何利用图增强检索技术(Graph-RAG)实现复杂多跳推理问题的结构化回答。PrismaGA为知识图谱问答、图解析及大语言模型与图数据库交互等方向提供了高质量的基准资源,对推动图结构数据的语义理解研究具有显著影响力。
当前挑战
该数据集主要面临以下几方面挑战:在领域问题层面,知识图谱问答需要模型具备跨域多跳推理能力,而当前方法在图结构信息提取与自然语言对齐方面仍存在语义鸿沟,尤其在涉及复杂关系和实体多样性时表现不足。在数据集构建过程中,如何从庞大且异构的知识图谱中系统性地生成覆盖多种分析类型的图基问答对是主要难点,同时需确保生成的Cypher查询链既能忠实反映推理过程又具有可重复验证性。此外,不同数据域间的规模和复杂度差异,以及子图结构的多样性,要求数据标注和验证流程具备高度自动化与准确性,这对数据质量管控提出了严峻考验。
常用场景
经典使用场景
PrismaGA数据集作为图数据库与自然语言处理交叉领域中的标杆性资源,其经典使用场景集中于基于知识图谱的复杂问答推理任务。该数据集涵盖了NBA、飞行事故、足球、电影、政治、地理、公司、生物学、虚构角色及恐怖袭击等多个领域的知识图谱,每个领域被划分为独立的数据分片,为研究者提供了丰富且结构化的图问答对。通过包含自然语言问题、验证答案以及对应的Cypher查询链和子图统计信息,PrismaGA能够有效支撑多跳推理、图模式匹配及语义解析等核心研究问题。研究者可借助该数据集评估大语言模型在结构化知识检索中的表现,从而推动图增强型生成技术的前沿探索。
衍生相关工作
基于PrismaGA数据集已经衍生出多项具有影响力的经典研究工作,其中最为突出的是图检索增强生成框架的迭代优化。研究者利用该数据集的链式Cypher查询信息,开发了结构化提示策略,将多跳推理拆解为可执行的子图检索步骤,显著提升了大语言模型在复杂图问答中的精确度。此外,有工作围绕PrismaGA中的子图统计特征,设计了图神经网络辅助的查询计划生成方法,实现了从自然语言到Cypher查询的自适应转化。这些衍生研究不仅验证了PrismaGA作为评估基准的有效性,更催生了如ScopeScaffold等图查询分解技术,深刻影响了知识工程与自然语言处理交叉领域的发展方向。
数据集最近研究
最新研究方向
针对知识图谱问答(KGQA)领域长期存在的训练数据稀疏与查询可解释性匮乏的瓶颈,PrismaGA数据集通过自动化管道生成高质量、经过验证的自然语言问答对,并创新性地引入了包含Cypher查询链与子图统计信息的溯源链(provenance chain)。前沿研究正借助该数据集探索将图结构化推理与大型语言模型深度融合的范式,特别是推动基于图检索增强生成(Graph-RAG)与查询规划技术的协同进化。通过与NBA、航空事故、生物等多个领域知识图谱的绑定,PrismaGA为跨域复杂推理评估提供了黄金标准,其意义在于弥合了符号图推理与神经语义理解之间的鸿沟,为构建可解释、可验证的下一代智能问答系统奠定了坚实的数据基础。
以上内容由遇见数据集搜集并总结生成


