遇见数据集

legal_scrapers

收藏
Hugging Face2026-09-07 更新2026-09-08 收录
官方服务:

资源简介:

JusticeDAO Legal Scrapers 是一个用于收集官方立法来源的爬虫工具集合,旨在构建可复现的法律文本语料库,仅供研究使用。该集合包含针对多个国家/地区的爬虫脚本,目标来源包括官方公报和开放数据门户,涵盖欧盟及成员国(如奥地利、比利时、保加利亚、塞浦路斯、捷克、丹麦、爱沙尼亚、芬兰、希腊、克罗地亚、匈牙利、爱尔兰、意大利、立陶宛、卢森堡、拉脱维亚、马耳他、波兰、葡萄牙、罗马尼亚、瑞典、斯洛文尼亚、斯洛伐克)、德国、西班牙、荷兰、法国、瑞士、日本、加拿大、墨西哥、中国、印度、以色列、沙特阿拉伯、科威特、澳大利亚、新西兰、马来西亚、印度尼西亚、新加坡等。工具支持通过 Wayback Machine 和 Common Crawl 回退机制获取官方快照,以确保数据完整性。所有脚本遵循 AGPL-3.0 许可证,不提供法律建议,官方公报具有最终效力。

JusticeDAO Legal Scrapers is a collection of scrapers for collecting official legislative sources, aiming to build a reproducible legal text corpus for research purposes only. The collection includes scrapers for multiple countries/regions, targeting official gazettes and open data portals, covering the EU and its member states (e.g., Austria, Belgium, Bulgaria, Cyprus, Czech Republic, Denmark, Estonia, Finland, Greece, Croatia, Hungary, Ireland, Italy, Lithuania, Luxembourg, Latvia, Malta, Poland, Portugal, Romania, Sweden, Slovenia, Slovakia), as well as Germany, Spain, the Netherlands, France, Switzerland, Japan, Canada, Mexico, China, India, Israel, Saudi Arabia, Kuwait, Australia, New Zealand, Malaysia, Indonesia, Singapore, etc. The tools support fallback mechanisms via Wayback Machine and Common Crawl to obtain official snapshots, ensuring data integrity. All scripts are licensed under AGPL-3.0, do not provide legal advice, and official gazettes have final authority.

创建时间:
2026-09-03
原始信息汇总

JusticeDAO Legal Scrapers 数据集概述

此数据集是 JusticeDAO 项目的法律数据采集器集合,专门用于从官方立法来源下载数据,构建可复现的法律文本语料库,供研究使用。

基本信息

  • 许可协议:AGPL-3.0
  • 语言:英语
  • 任务类型:文本检索
  • 标签:法律、采集器、官方来源、研究、Wayback、Common Crawl
  • 数据来源限制:仅采集各国官方公报和官方开放数据门户,不包含非官方聚合网站(如 cylaw.org)

覆盖范围

采集器覆盖全球多个国家与地区的官方法律数据源,主要分为以下几类:

类别 涵盖地区/机构
欧盟及大型官方语料库 欧盟(EUR-Lex)、德国(Gesetze im Internet)、西班牙(BOE)、荷兰(Basiswettenbestand)、法国(Légifrance)、瑞士(Fedlex)
欧盟成员国采集器 奥地利、比利时、保加利亚、塞浦路斯、捷克、丹麦、爱沙尼亚、芬兰、希腊、克罗地亚、匈牙利、爱尔兰、意大利、立陶宛、卢森堡、拉脱维亚、马耳他、波兰、葡萄牙、罗马尼亚、瑞典、斯洛文尼亚、斯洛伐克
其他国家/地区 日本(e-Gov)、加拿大(Justice Laws)、墨西哥(Cámara de Diputados)、中国(NPC 权威发布)、马来西亚(AGC)、印度尼西亚(Peraturan)、新加坡(SSO/AGC)、印度(India Code)、以色列(Knesset)、沙特阿拉伯(BOE laws)、科威特(Kuwaitalyawm)、澳大利亚(Federal Register of Legislation)、新西兰(PCO/legislation.govt.nz)

功能设计

  • 共享辅助工具:包含通用采集器、归档回退、CDX 探测等辅助模块
  • 归档回退机制:当官方实时站点被屏蔽、数据不完整或仅支持 JS 渲染时,系统自动通过以下方式获取官方 URL 的存档快照:
    • Wayback Machine CDX/回放
    • Common Crawl CDX 索引
    • Playwright 对仅支持浏览器渲染的官方单页应用
  • 回退策略不改变数据源原则:所有回退方案仍只获取官方公报或官方门户的存档内容

使用声明

  • 脚本仅为研究工具,不生成官方整合版本
  • 不构成法律建议,各司法辖区的官方公报具有最终效力
搜集汇总
数据集介绍
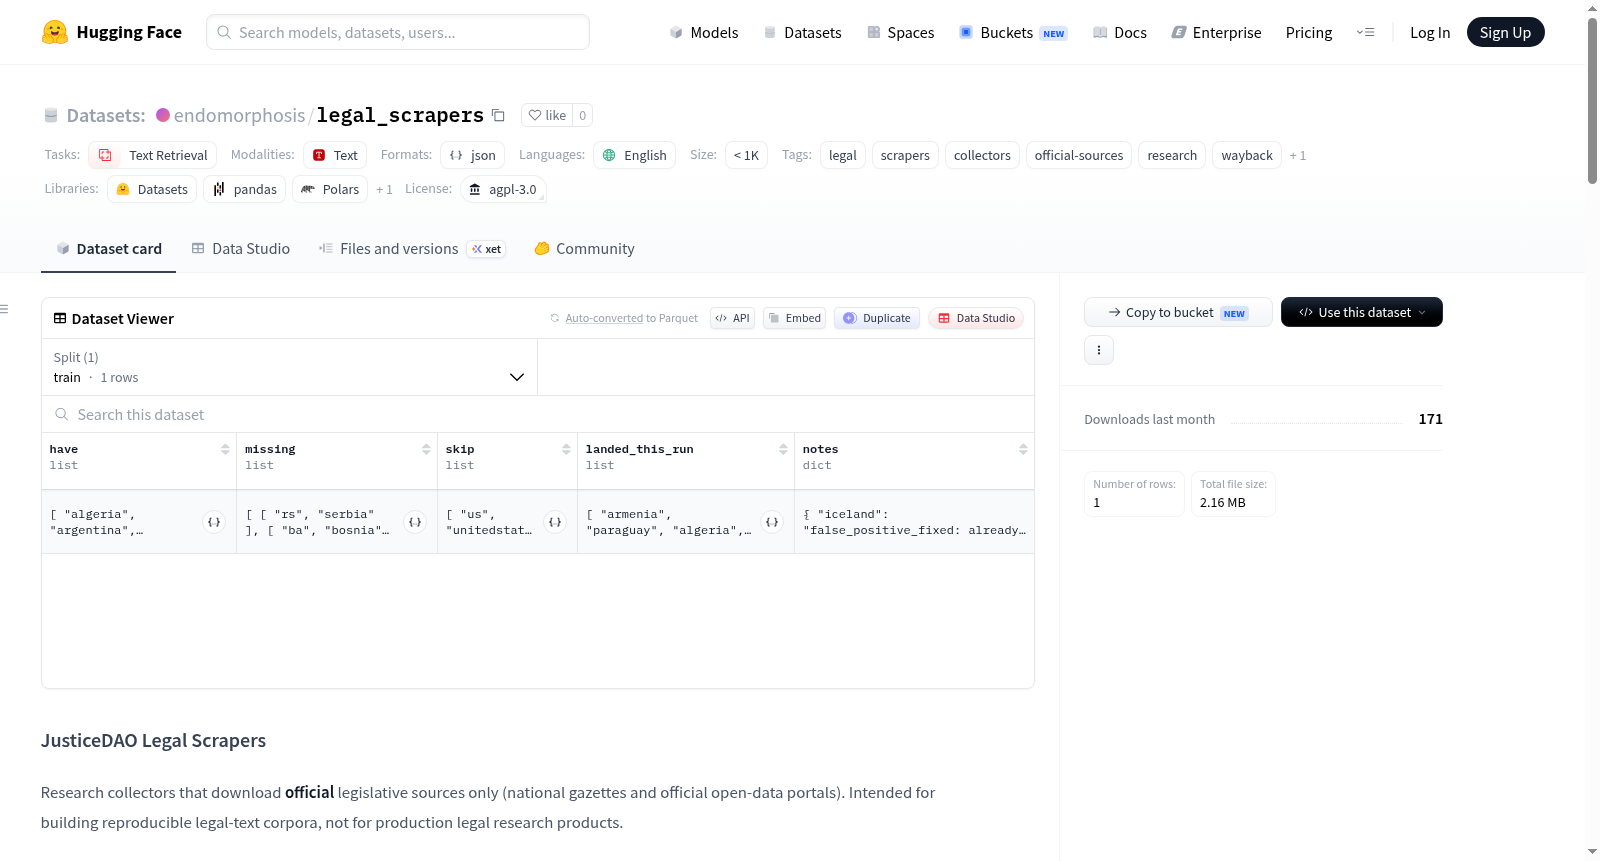
legal_scrapers 数据集图片
构建方式
JusticeDAO Legal Scrapers 数据集由一系列研究型采集脚本构成,旨在系统性地从各国官方公报与官方开放数据门户下载立法文本。其构建过程严格遵循官方来源优先原则,覆盖欧盟及成员国、中国、日本、加拿大、墨西哥、印度、以色列、沙特阿拉伯、科威特、澳大利亚、新西兰等 jurisdictions,每个国家或地区配备专属采集器,并辅以共享助手模块,实现统一调度。针对部分官方站点可能存在的访问受阻、内容不完整或依赖 JavaScript 渲染的情况,该数据集设计了基于 Wayback Machine 与 Common Crawl 的归档回退机制,以及 Playwright 单页应用渲染工具,确保能够获取官方快照,而非非官方聚合源的替代数据。所有采集器脚本均以 AGPL-3.0 许可发布,便于学术研究与司法数据建库的复现。
特点
该数据集的核心特征在于其高度的来源权威性与可复现性。采集目标仅限于官方公报与官方开放数据门户,并明确排除非官方平台(如塞浦路斯的 cylaw.org),从根本上保障了数据的法律效力与准确性。其架构具备良好的模块化与扩展性,既包含针对大型官方语料库(如欧盟 EUR-Lex、德国 Gesetze im Internet 等)的独立采集器,也提供了可供多国复用的共享工具,促进了跨司法管辖区数据采集的一致性。同时,数据集的构建充分考虑真实性环境中的技术挑战,引入三重归档回退策略(Wayback、Common Crawl、Playwright)应对官方站点封锁或技术限制,确保采集过程的鲁棒性与完整性。此外,数据集明确声明其研究属性,不构成法律意见,凸显了在学术研究与生产应用之间的边界意识。
使用方法
该数据集的主要使用方式是作为构建可复现法律文本语料库的科研基础设施,而非直接用于生成最终法律产品。研究者可通过运行各司法辖区的采集脚本,获取原始官方文本,进而进行法律文本分析、跨法域比较或自然语言处理研究。脚本预设了多种运行模式,支持增量采集(collect_remaining.py)以及面对受限主机时的自动归档回退(collect_blocked_archives.py),便于在大规模语料采集中灵活适配。用户需具备一定的命令行操作能力,并根据自身环境配置 Python 依赖及 Playwright 浏览器。由于版权协议为 AGPL-3.0,任何修改或分发均需开放源代码,这要求使用者在学术或商业应用中遵守相应许可义务。数据集自身不提供整合后的法律文本,需用户自行运行采集流程并尊重各官方来源的使用条款。
背景与挑战
背景概述
JusticeDAO Legal Scrapers 数据集由 JusticeDAO 研究团队于近年来开发,旨在构建可复现的法律文本语料库。该数据集聚焦于官方立法来源,涵盖欧盟及成员国、非欧盟国家(如日本、加拿大、墨西哥、中国等)的官方公报和开放数据门户。其核心研究问题在于如何高效、可靠地采集并整合全球分散的官方法律文本,以支持法律科技、计算法学及公共政策研究。该数据集强调仅使用官方来源,并提供存档回退机制以应对网站屏蔽或动态渲染,提升了法律数据获取的鲁棒性,对法律文本挖掘、跨法域比较研究及法律知识图谱构建等领域具有重要影响力。
当前挑战
该数据集面临的挑战首先是领域问题:法律文本具有高度权威性与时效性,且各法域官方发布格式多样(如 PDF、HTML、XML),语言差异大,非结构化特征明显,给文本清洗、标准化及跨语料库对齐带来困难。在构建过程中,挑战包括:部分官方主机屏蔽或限制访问,需借助 Wayback Machine 和 Common Crawl 等存档回退方案,但存档可能存在不完整或滞后;动态渲染的官方门户(如 JavaScript 驱动)需借助 Playwright 进行界面渲染,增加复杂性与资源消耗;不同管辖区数据格式差异大,需定制化采集脚本,且需严格遵守官方来源原则,避免使用非官方聚合器,确保数据合法性与公信力。
常用场景
经典使用场景
legal_scrapers数据集聚焦于法律文本的自动化采集,其核心场景在于构建可复现的法律语料库。研究者可利用这些脚本从官方公报和开放数据门户下载立法文本,用于训练法律领域的大型语言模型、构建法律信息检索系统或进行跨法域的比较法研究。该数据集提供了覆盖欧盟多国及全球主要法域的采集工具,支持通过Wayback Machine和Common Crawl进行回溯获取,特别适合需要长期存档和法律演化分析的研究。
解决学术问题
该数据集解决了法学与计算机科学交叉领域中的关键难题:法律数据源分散、格式异构且访问受限。传统上,研究者常依赖非官方聚合站,存在法律效力存疑和数据完整性问题。此数据集通过系统化采集官方来源,确保数据权威性和可溯源,支持法律文本的可重复性研究(如法律变迁追踪、立法者意图分析)。它还为计算法学中的语料构建提供了标准化流程,降低了跨语言、跨法域研究的数据获取门槛,促进了法律计量学与自然语言处理在司法领域的应用。
衍生相关工作
基于该数据集衍生的工作集中于增强法律自然语言处理工具链,例如开发多语种法律词向量、法律预训练模型(如Legal-BERT的扩展)以及立法文本分类器。部分工作利用其采集的语料构建法律知识图谱,支撑法规条款间的关联推理;另有研究将其与法院判决数据结合,用于执法一致性分析。该数据集的脚本框架也被复用至其他领域,如政府开放数据采集,推动了官方信息公开的自动化研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务