
遇见数据集

oliverkinch/da-instruct-dynaword-contemporary

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

da-instruct-dynaword-contemporary 是一个丹麦语指令微调数据集,通过反向翻译从 danish-dynaword 数据集生成,仅限于当代丹麦语子集,未进行基于注释的质量过滤。每行数据是一个 (prompt, target) 对,其中 target 是来自精选 DynaWord 子集的真实丹麦语文本段落,prompt 是一个现实的丹麦用户指令,可以合理地引出语言模型生成该文本。prompt 由 Qwen/Qwen3.5-397B-A17B 模型使用反向翻译方法生成:给定一个段落及其源上下文,模型被要求编写一个用户消息,该消息会导致聊天机器人产生类似的文本。特定领域的提示模板(政府、文学、学术、税务指导、新闻、演讲)确保生成的指令与源文本的语域和体裁匹配。数据集构建包括子集选择、段落提取、提示生成和结果统计,共从 32 个 dynaword 子集的 10,000 个随机采样源 ID 中生成了 8,271 个指令对。

da-instruct-dynaword-contemporary is a Danish instruction fine-tuning dataset generated via backtranslation from the danish-dynaword dataset, restricted to contemporary Danish subsets with no annotation-based quality filtering. Each row is a (prompt, target) pair where target is a passage of authentic Danish text drawn from a curated subset of DynaWord, and prompt is a realistic Danish user instruction that would plausibly elicit that text from a language model. Prompts were generated by Qwen/Qwen3.5-397B-A17B using a backtranslation approach: given a passage and its source context, the model is asked to write the user message that would cause a chatbot to produce a similar text. Domain-specific prompt templates (government, literary, academic, tax guidance, news, speech) ensure that the generated instructions match the register and genre of the source text. Dataset construction includes subset selection, passage extraction, prompt generation, and results, with 8,271 instruction pairs generated from 10,000 randomly sampled source IDs across 32 dynaword subsets.
提供机构:
oliverkinch
搜集汇总
数据集介绍
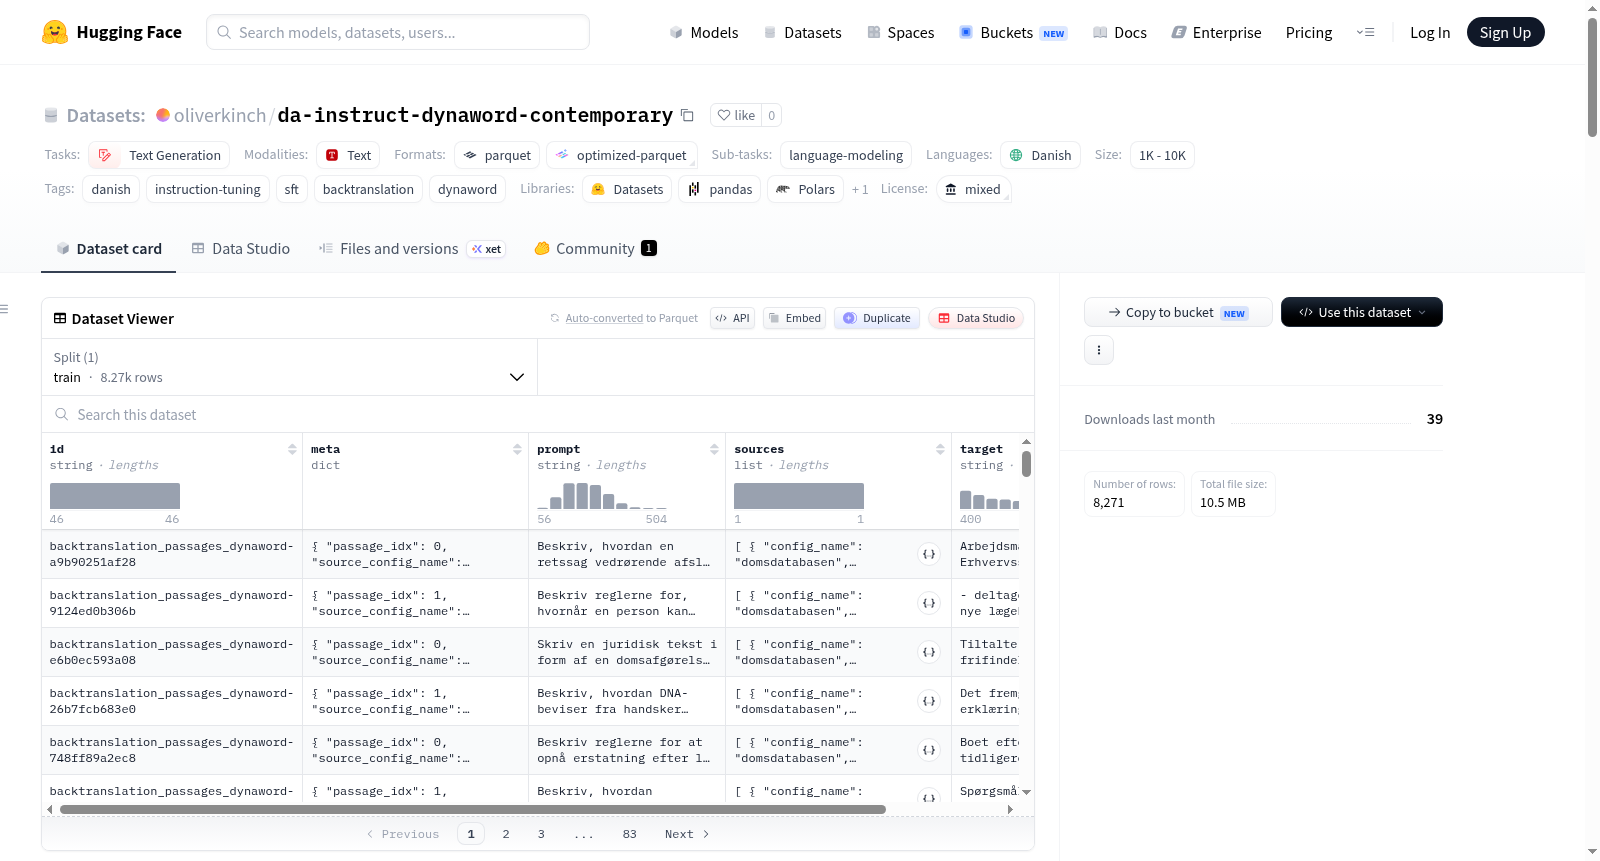
oliverkinch/da-instruct-dynaword-contemporary 数据集图片
构建方式
该数据集基于丹麦语DynaWord语料库构建,首先从32个当代丹麦语子集中随机无放回抽样10,000个文本标识。抽取的文本经过严格筛选:剔除短于400字符的文章,并将长文本按段落边界与质量评分划分为最长2,500字符的片段,每篇文章最多保留两段。OCR噪声、重复内容、文档题署及YAML前置元数据等低质量片段均被排除。随后,利用Qwen3.5-397B-A17B模型采用反向翻译方法,为每个文本片段及其来源语境生成符合丹麦语用户习惯的指令。针对政府、文学、学术、税务、新闻、演讲六类领域定制了不同的系统提示模板,确保生成的提示匹配源文本的语域与体裁。最后,通过语言检测、疑问句或祈使句验证、喊叫词过滤、角色扮演模式剔除及内容重叠检查等规则过滤,得到8,271对高质量的指令-应答对。
特点
该数据集的核心特点在于其精准的领域覆盖与语体适配性。数据来源涵盖百科全书、法律法规、政府文件、新闻报道、议会演讲、文学作品等多元类型,其中wiki百科、法律库及政府行政数据集贡献了超过六成的样本,赋予数据集丰富的当代丹麦语表达层次。每个样本包含由大型语言模型反向生成的用户指令与来自真实语料的目标文本,指令的自然度与语域匹配性通过六类领域特定的系统提示得到保障。此外,数据集中未应用基于标注的质量过滤,保留了原始语料的自然分布与多样性,使其既反映了当代丹麦语的日常使用状况,又避免了过度清洗导致的语体偏差。数据集的另一个亮点是提供了结构化的元信息,包括来源子集、指令模板类型及文本长度等,便于使用者进行细粒度的数据筛选与分析。
使用方法
该数据集专为丹麦语大语言模型的指令微调与监督式微调设计,可通过HuggingFace的datasets库便捷加载。使用者可按标准多轮对话格式组织数据:将prompt字段作为用户输入,target字段作为模型应答,构建包含role为'user'与'assistant'的消息列表,直接输入到支持聊天模板的语言模型训练框架中。值得注意的是,数据集提供丰富的元数据字段,如source_config_name、source_type与target_chars等,支持基于领域、文本类型或长度的子集筛选。对于需要更高数据质量的应用场景,建议使用经过dynaword-annotations标注过滤的版本;而本版本的当代性特征使其特别适合训练面向现代丹麦语使用场景的对话系统。模型训练时可结合丹麦语分词器,并参考原语料库的许可证信息进行合规使用。
背景与挑战
背景概述
随着大规模语言模型在自然语言处理领域取得突破性进展,高质量指令微调数据集的构建成为提升模型在特定语言上遵循指令能力的关键瓶颈。丹麦作为北欧小语种,其语言模型的发展长期受限于高质量、领域多样的指令数据的匮乏。在此背景下,da-instruct-dynaword-contemporary数据集应运而生,由研究者Oliver Kinch主导,依托丹麦基础模型项目,于2025年基于大规模丹麦语语料库DynaWord构建。该数据集聚焦当代丹麦语,通过反向翻译技术,从涵盖政府、法律、新闻、文学、学术、税收及议会演讲等32个子集的真实文本中生成指令对,旨在解决丹麦语大语言模型在指令微调阶段缺乏足够、专业且语义匹配的训练数据这一核心问题。其构建思路为小语种指令数据的高效生成提供了新范式,对推动北欧语言的自然语言处理研究具有重要参考价值。
当前挑战
该数据集面临的挑战体现在两个层面。在领域问题层面,丹麦语作为非英语语言,其自然语言处理研究长期受制于指令微调数据的稀缺性与领域覆盖不足,传统依赖人工标注或机器翻译的方法成本高昂且难以保证语义的自然性与文化适配性,限制了丹麦语大语言模型在多样化真实场景中的实际应用能力。在构建过程中,挑战主要来自三个方面:首先,需从DynaWord语料库的众多子集中手工筛选并排除历史性及古体丹麦语文本,确保数据源的当代性,这要求对语言演变阶段进行精准判别;其次,在段落提取阶段需设计复杂的混合评分机制以处理OCR噪声、重复内容及元数据干扰,在保留有效信息的同时控制数据质量;最后,反向翻译生成指令时,需要为六个不同领域定制系统提示模板,并通过语言检测、用户意图识别和内容重叠检查等多重规则过滤无效指令,整个流程在保证生成指令的真实性与领域匹配度方面存在显著的技术复杂性。
常用场景
经典使用场景
da-instruct-dynaword-contemporary 数据集专为丹麦语指令微调而生,其经典使用场景聚焦于提升生成式语言模型对当代丹麦语文本的理解与遵循指令能力。该数据集通过回译技术,将来自政府、法律、新闻、学术等多领域的真实丹麦语篇章转化为一对一的指令-回应样本,使得模型能够学习如何根据用户查询生成符合特定语域和体裁的流畅答复。这种设计尤其适用于需要处理丹麦语行政咨询、税务指导、议会演讲或新闻报道等多样化任务的对话系统训练,为低资源语言的指令微调树立了典范。
实际应用
在实际应用层面,该数据集为丹麦语智能助手和公共服务聊天机器人提供了核心训练资源。例如,在政府门户中,模型可依据数据集中的税务指南样本回答公民关于报税流程的精准提问;在新闻领域,它能辅助生成符合丹麦语新闻风格的摘要或答复。法律文本覆盖的丰富性还支持司法咨询场景下的工具开发,如自动解读法规条文或协助起草文件。这些场景充分展现了该数据集在弥合语言壁垒、提升北欧区域数字服务效率上的价值。
衍生相关工作
该数据集衍生了一系列高质量的变体工作,共同构成了丹麦语指令数据的生态体系。例如,oliverkinch/da-instruct-dynaword-contemporary-hq 在原始数据基础上增加了经 DynaWord 注释筛选的高质量版本,过滤了噪声样本。扩展至全部 40 个子集的 da-instruct-dynaword 系列则覆盖了古语与当代语的完整 spectrum,并提供了不同规模的数据集变体(如 10660 对的高质量版本与 39847 对的完整版),为研究人员根据资源约束选择适配数据提供了灵活性。这些衍生工作不仅验证了回译方法在丹麦语上的可扩展性,也推动了多语言指令微调数据生态的标准化。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

