
nbl-open-9076-2c50ec-supply-chain
收藏官方服务:
资源简介:
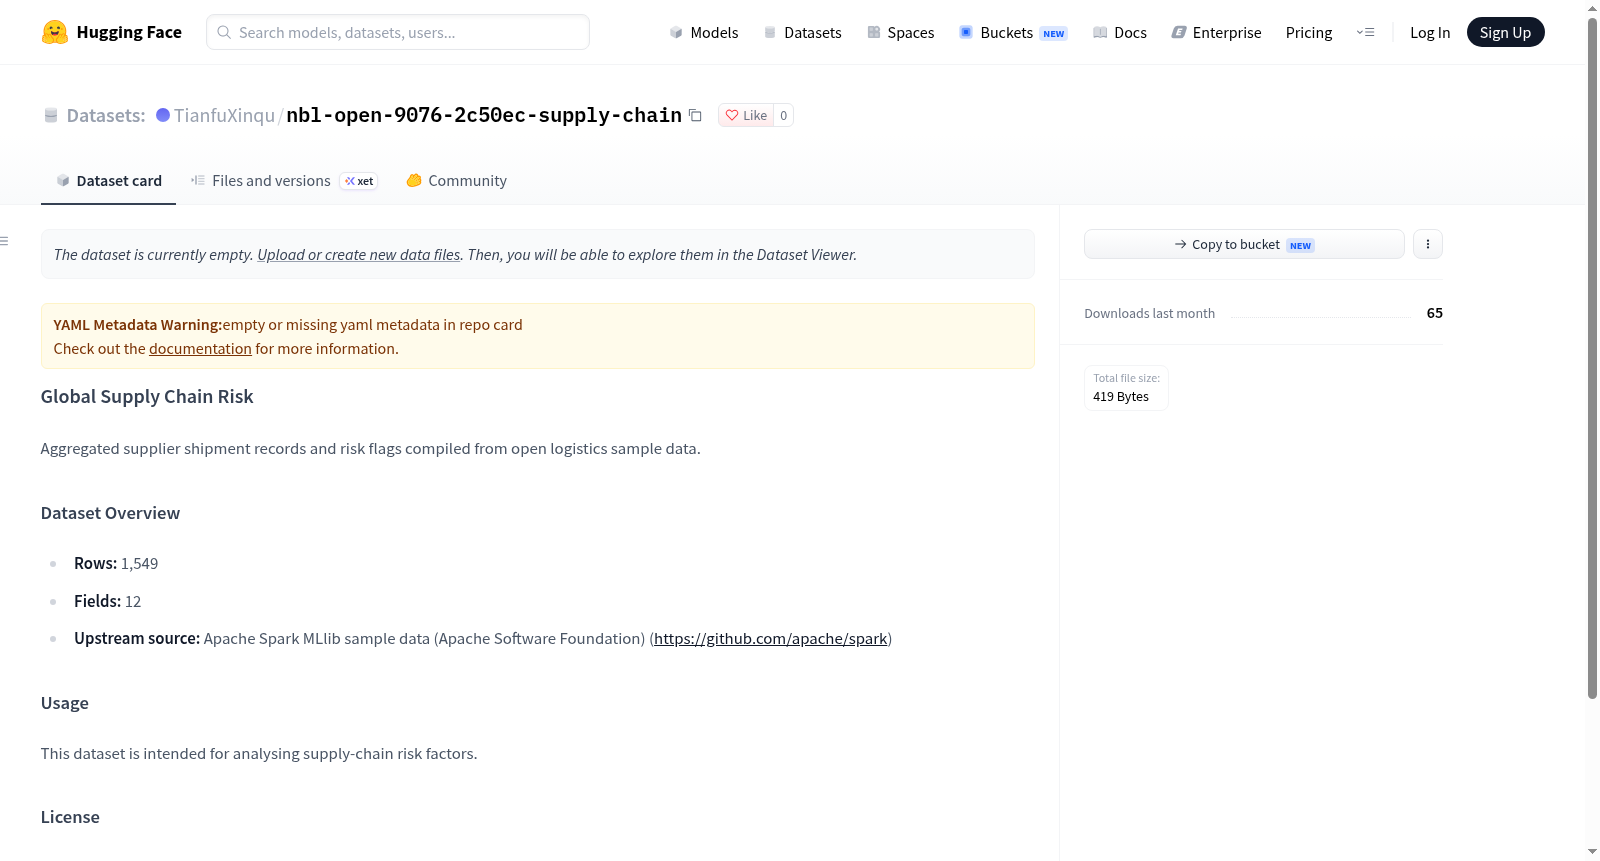
全球供应链风险数据集包含了从开源物流样本数据中聚合的供应商发货记录及其风险标志。该数据集共有1549行记录和12个字段,上游数据来源于Apache Spark MLlib的样本数据。该数据集主要用于分析供应链中的风险因素,帮助研究人员或从业者识别和评估供应链中的潜在风险。
The Global Supply Chain Risk dataset contains supplier shipment records and their risk flags aggregated from open-source logistics sample data. The dataset has 1549 rows and 12 fields, with upstream data sourced from Apache Spark MLlib sample data. It is primarily used for analyzing risk factors in supply chains, helping researchers or practitioners identify and assess potential risks in supply chains.
创建时间:
2026-08-22
原始信息汇总
数据集概述
数据集名称: Global Supply Chain Risk
数据集描述: 该数据集汇集了来自开放物流样本数据的供应商发货记录及风险标记,旨在支持供应链风险因素的分析。
基本信息
| 项目 | 内容 |
|---|---|
| 数据行数 | 1,549 |
| 字段数量 | 12 |
| 上游来源 | Apache Spark MLlib 示例数据(Apache Software Foundation) |
| 来源地址 | https://github.com/apache/spark |
用途说明
该数据集设计用于供应链风险因素的分析与研究,可帮助用户理解供应商发货模式及潜在风险。
许可证
- SPDX 许可证标识: unknown(未知)
搜集汇总
数据集介绍
构建方式
在全球供应链风险分析领域,高质量的基础数据对于揭示物流网络中的潜在脆弱性具有关键意义。该数据集通过整合Apache Spark MLlib示例数据中的供应商发货记录,并附加风险标记,构建了面向供应链风险研究的样本集合。原始数据取自Apache软件基金会提供的开源物流样本,经过去重、字段对齐与风险标签标注等处理,最终形成包含1549条记录、12个字段的结构化数据集,为后续建模与实证分析提供了可复用的数据基础。
特点
该数据集的核心特点在于其聚焦供应链风险维度,将供应商发货行为与风险标记相结合,形成兼具描述性与诊断性的数据资源。数据集规模适中,字段结构清晰,涵盖发货记录及风险标志等多类信息,便于开展多角度的风险因素识别与关联分析。数据源自Apache Spark官方示例,具备一定的透明性与可追溯性,适用于学术研究及教学演示场景,但需注意其许可协议状态尚未明确。
使用方法
使用该数据集时,研究者可借助Python、R或Spark等工具加载并解析结构化数据,围绕供应商发货记录与风险标记之间的关联展开统计分析或机器学习建模。典型应用包括风险因素重要性评估、异常发货模式检测以及供应链脆弱性预测等任务。建议在使用前核实字段含义与数据分布,确保分析逻辑与业务背景相匹配,并在成果中注明数据来源及许可限制。
背景与挑战
背景概述
全球供应链风险管理是运营管理与数据科学交叉的前沿议题。该数据集由研究人员基于Apache Spark MLlib样本数据构建,于2024年前后发布,旨在为供应链风险分析提供公开可用的实证基础。数据集汇聚了1549条供应商发货记录及风险标记,涵盖12个字段,其核心研究问题在于如何从结构化物流数据中识别和量化潜在风险因素。该数据集填补了开放供应链风险数据稀缺的空白,为学术研究与工业实践提供了可复现的基准,对推动供应链韧性研究和智能决策具有参考价值。
当前挑战
该数据集所面对的领域挑战在于供应链风险的多源异构性与动态耦合性,传统模型难以精准捕捉非线性交互效应。构建过程中的挑战则体现为:原始Spark MLlib样本数据以通用机器学习任务为导向,缺乏供应链语义标注,需进行领域适配与特征工程;同时,数据规模有限且许可协议不明,限制了其在不同场景下的泛化能力与合规使用。如何在有限样本下保证风险标记的可靠性与代表性,仍是该数据集应用中的关键难题。
常用场景
经典使用场景
在全球供应链风险管理的研究中,该数据集常被用于构建供应商风险预警模型。其汇集了1,549条供应商发货记录及风险标记,涵盖12个字段,使研究者能够基于实际运输数据识别潜在中断风险。运用该数据集,可实施分类任务以区分高风险与低风险供应商,或进行聚类分析以发现风险模式,从而为供应链韧性评估提供实证基础。
解决学术问题
该数据集有效回应了供应链研究中数据稀缺与碎片化的难题,为风险因素量化分析提供了标准化样本。它使得学者能够验证风险传播理论、评估供应商违约概率,并探究物流变量与中断事件之间的关联。其开源特性促进了方法比较与结果复现,推动了供应链风险管理从定性描述向数据驱动的转变,增强了研究的严谨性与可推广性。
衍生相关工作
围绕该数据集,研究者已开展多项延伸工作:开发基于机器学习的风险评分模型,如随机森林与梯度提升机;构建供应链知识图谱以关联供应商实体;以及探索时间序列异常检测方法。这些工作不仅提升了风险预测精度,还催生了针对多层级供应链的仿真工具,进一步丰富了开源供应链分析生态。
以上内容由遇见数据集搜集并总结生成


