
nphearum/Opus4.6x4.7-Family-50000x
收藏官方服务:
资源简介:
这是一个合并的对话数据集,由多个Claude Opus 4.x指令遵循/推理数据集组合而成。每个示例包含一个消息列表,其中每个消息是一个字典,包含以下字段:role(说话者角色,如user、assistant、system)、content(消息文本)、thinking(可选的助理思考或元数据)和name(可选的说话者名称)。该合并数据集设计用于指令调优和多轮对话建模。
A merged conversation dataset assembled from several Claude Opus 4.x instruction-following / reasoning datasets. Each example contains a list of messages, where each message is a dictionary with the following fields: role (speaker role, e.g. user, assistant, system), content (message text), thinking (optional assistant thinking or metadata), and name (optional speaker name). The merged dataset is designed for instruction tuning and multi-turn dialogue modeling.
提供机构:
nphearum搜集汇总
数据集介绍
构建方式
Opus4.6x4.7-Family-50000x数据集是基于多个源自Claude Opus 4.x系列的指令遵循与推理对话数据集整合而成。构建过程汇集了Jackrong、angrygiraffe和TeichAI等团队在Hugging Face平台上发布的四个子数据集,包括Claude-opus-4.7-TraceInversion-5000x、Claude-opus-4.6-TraceInversion-9000x、claude-opus-4.6-4.7-reasoning-8.7k以及Claude-Opus-4.6-Reasoning-887x。通过合并对话轨迹与推理样本,生成了一个统一的多轮对话数据集,每个样本均以标准化的消息列表形式呈现,包含角色、内容、思考过程及名称等字段。
特点
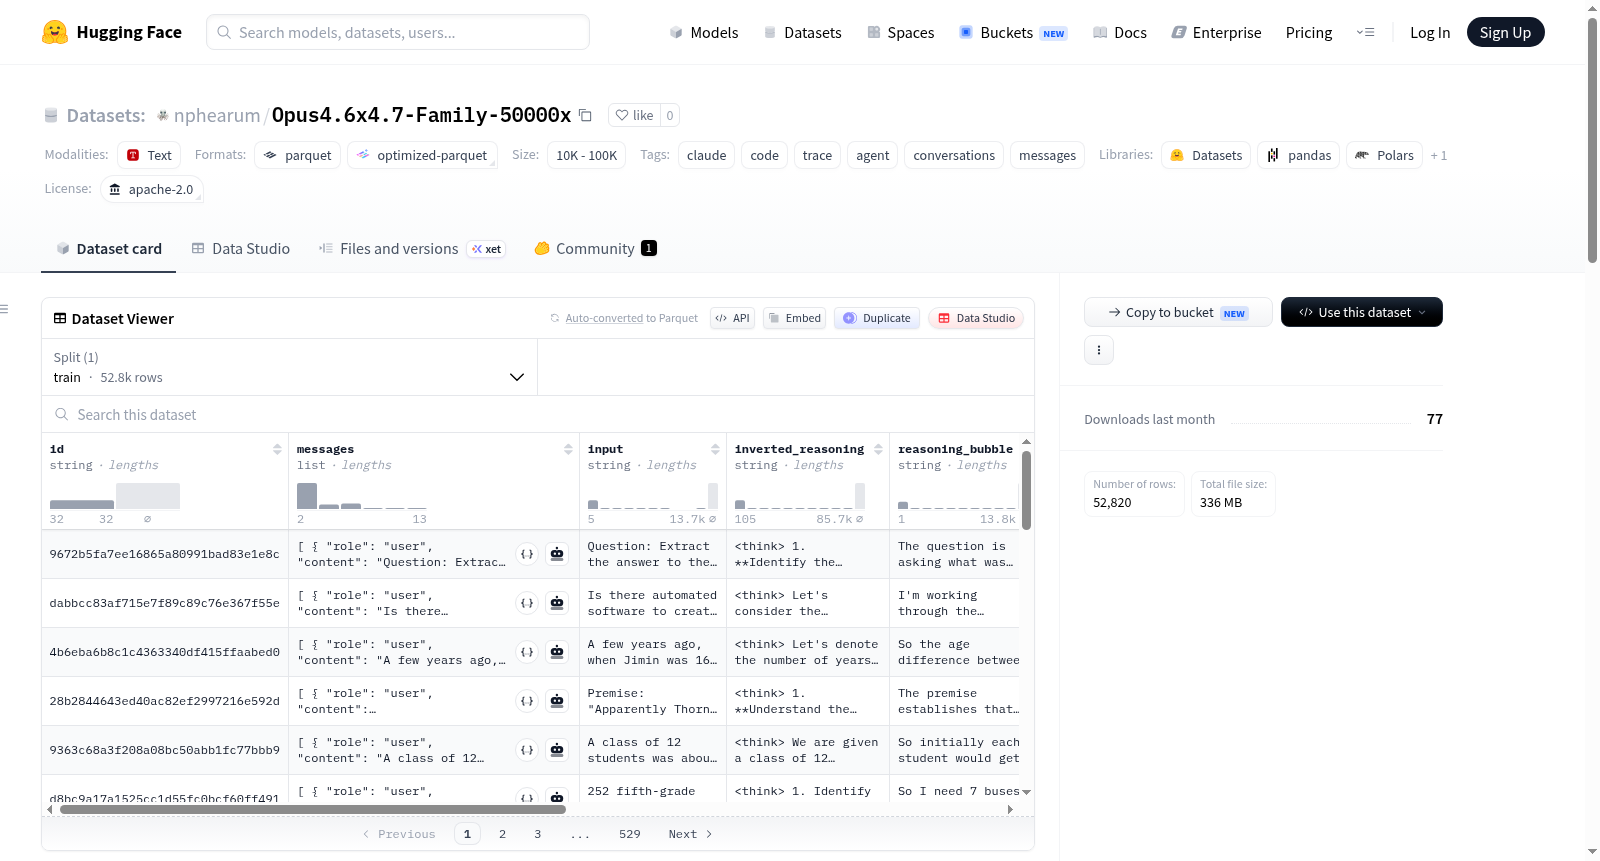
该数据集以统一的messages字段结构存储对话实例,每条消息包含role、content、thinking和name四个属性,充分保留了原始对话中的角色身份、文本内容、关联推理痕迹以及可选的说话者标识。数据集规模介于10K至100K之间,训练集包含52820个样本,覆盖了指令微调所需的多样化交互场景。其核心特色在于整合了多个高质量Claude模型输出,保留了助手的思考链信息,为模型训练提供了丰富的多轮对话与推理范例。
使用方法
用户可通过Hugging Face的datasets库便捷加载该数据集,使用load_dataset函数指定数据集标识符"nphearum/Opus4.6x4.7-Family-50000x"并选择train分割即可获取。加载后的每个样本可直接用于聊天模型的训练与评估,其结构兼容主流指令微调框架。推荐安装datasets、tokenizers及huggingface_hub等依赖库以优化数据加载与处理流程。使用时需注意遵守原始子数据集的许可条款,尤其是涉及推理轨迹和对话内容的版权归属。
背景与挑战
背景概述
Opus4.6x4.7-Family-50000x数据集是由研究机构或独立开发者于近期构建并发布在HuggingFace平台上的大规模对话语料库。该数据集以整合多源指令遵循与推理对话为核心目标,汇集了来自Jackrong、angrygiraffe、TeichAI等多个贡献者发布的Claude Opus 4.6与4.7版本对话跟踪与推理数据集,最终形成统一格式的多轮对话样本。数据集包含约5.2万条训练样本,每条记录涵盖消息角色、内容、思考过程及元信息等字段,旨在为指令微调与多轮对话建模提供高质量训练资源。该数据集在开源社区中具有较高影响力,尤其为基于Claude模型系列的对话能力迁移、推理链复现及智能体对话系统研究提供了坚实的实验基础,推动了对话式AI领域从封闭模型到开放研究的范式转变。
当前挑战
本数据集所解决的核心领域问题在于,当前大语言模型特别是闭源模型(如Claude Opus系列)的对话行为与推理能力难以被复现和系统研究,缺乏公开、标准化的高质量对话数据集供研究社区使用。构建过程中的主要挑战包括:首先,需要从多个异构数据源中提取并统一不同格式的对话记录,确保字段对齐与语义一致性;其次,原始数据中涉及Claude模型私有输出的授权与使用规范存在模糊性,需妥善处理版权与合规问题;此外,对话样本中隐含的推理链(如inverted_reasoning字段)往往长度较长、结构复杂,对数据清洗与质量保证提出较高要求;最后,数据集在保留原始对话完整性的同时,还需兼顾训练场景下对噪声控制、多样性覆盖与领域平衡性等实用需求。
常用场景
经典使用场景
在自然语言处理与对话式人工智能的浪潮中,Opus4.6x4.7-Family-50000x数据集以其丰富的多轮对话结构脱颖而出,成为指令微调与对话建模领域的经典资源。该数据集整合了源自Claude Opus 4.x系列的多个高质量对话语料,统一采用messages格式,每条记录包含角色、内容、思考过程及说话者名称等字段,为训练语言模型理解复杂指令、保持上下文连贯性以及生成精确回应提供了坚实的数据基础。研究者常将其作为基准数据集,用于评估模型在多轮交互中的推理能力与对话流畅度。
解决学术问题
在学术界,构建高质量对话数据集一直是制约指令微调模型性能提升的瓶颈。该数据集巧妙融合了多个来源的Claude Opus 4.x推理与追踪数据,有效解决了传统数据集规模有限、对话结构单一以及思考过程缺失等难题。通过引入thinking字段,数据集为研究模型内隐推理机制提供了独特的标注信息,推动了对大型语言模型“思考链”与“反向推理”过程的探索。其跨领域的多样性还助力学者深入分析模型在不同知识域中的泛化表现,为提升指令遵循准确性与逻辑一致性贡献了重要理论支持。
衍生相关工作
该数据集的诞生催生了一系列具有影响力的相关研究。基于其统一的messages格式与丰富的思考过程,研究者开发了TraceInversion系列方法,探索如何从模型输出中逆向还原推理路径,进而提升模型的可解释性。同时,该数据集还被用于训练专门针对复杂指令遵循的对话模型,推动了如Claude Opus系列Agent能力评估基准的建立。在领域适应方向上,相关工作者利用该数据集进行跨域迁移学习实验,验证了其在代码生成、逻辑推理等任务中的泛化潜力。此外,数据集的多源融合策略本身为构建大规模、高质量指令数据集提供了可复现的范式。
以上内容由遇见数据集搜集并总结生成


