
遇见数据集

alibayram/Bilge-Turkish-CoT-50K

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

Bilge Turkish CoT 50K 是一个包含50,000个样本的土耳其语链式思维推理微调数据集。该数据集旨在提升土耳其语大语言模型的逐步推理能力,每个样本设计为让模型先在<think>...</think>块内进行显式推理,然后提供结构化、详细的回答。数据集是bugrabilge/Omni-31B-Turkish-Reasoning-Model模型训练所用249K过滤数据集的50K子集,内容包含学术和解释性风格的长篇土耳其语回答,涵盖科学、历史、文学、哲学、医学等多个领域。数据格式遵循HuggingFace对话标准,为Messages JSONL,每个样本包含system、user、assistant三种角色的对话。数据集通过多阶段规则过滤流程从约30GB原始土耳其语CoT数据生成,具有领域多样性、目标受众多样性和多种解释方法。

Bilge Turkish CoT 50K is a Turkish Chain-of-Thought reasoning fine-tuning dataset containing 50,000 examples. It is designed to enhance the step-by-step reasoning capabilities of Turkish large language models. Each example is structured to encourage the model to first perform explicit reasoning within <think>...</think> blocks, then provide structured and detailed responses. This dataset is a 50K subset of the 249K filtered dataset used to train the bugrabilge/Omni-31B-Turkish-Reasoning-Model. It contains long-form Turkish answers in an academic and explanatory style, covering various fields such as science, history, literature, philosophy, medicine, and more. The data format follows the HuggingFace conversational standard as Messages JSONL, with each sample containing a three-role conversation (system, user, assistant). The dataset is generated through a multi-stage rule-based filtering pipeline from approximately 30GB of raw Turkish CoT data, featuring domain diversity, target audience diversity, and multiple explanation methods.
提供机构:
alibayram
搜集汇总
数据集介绍
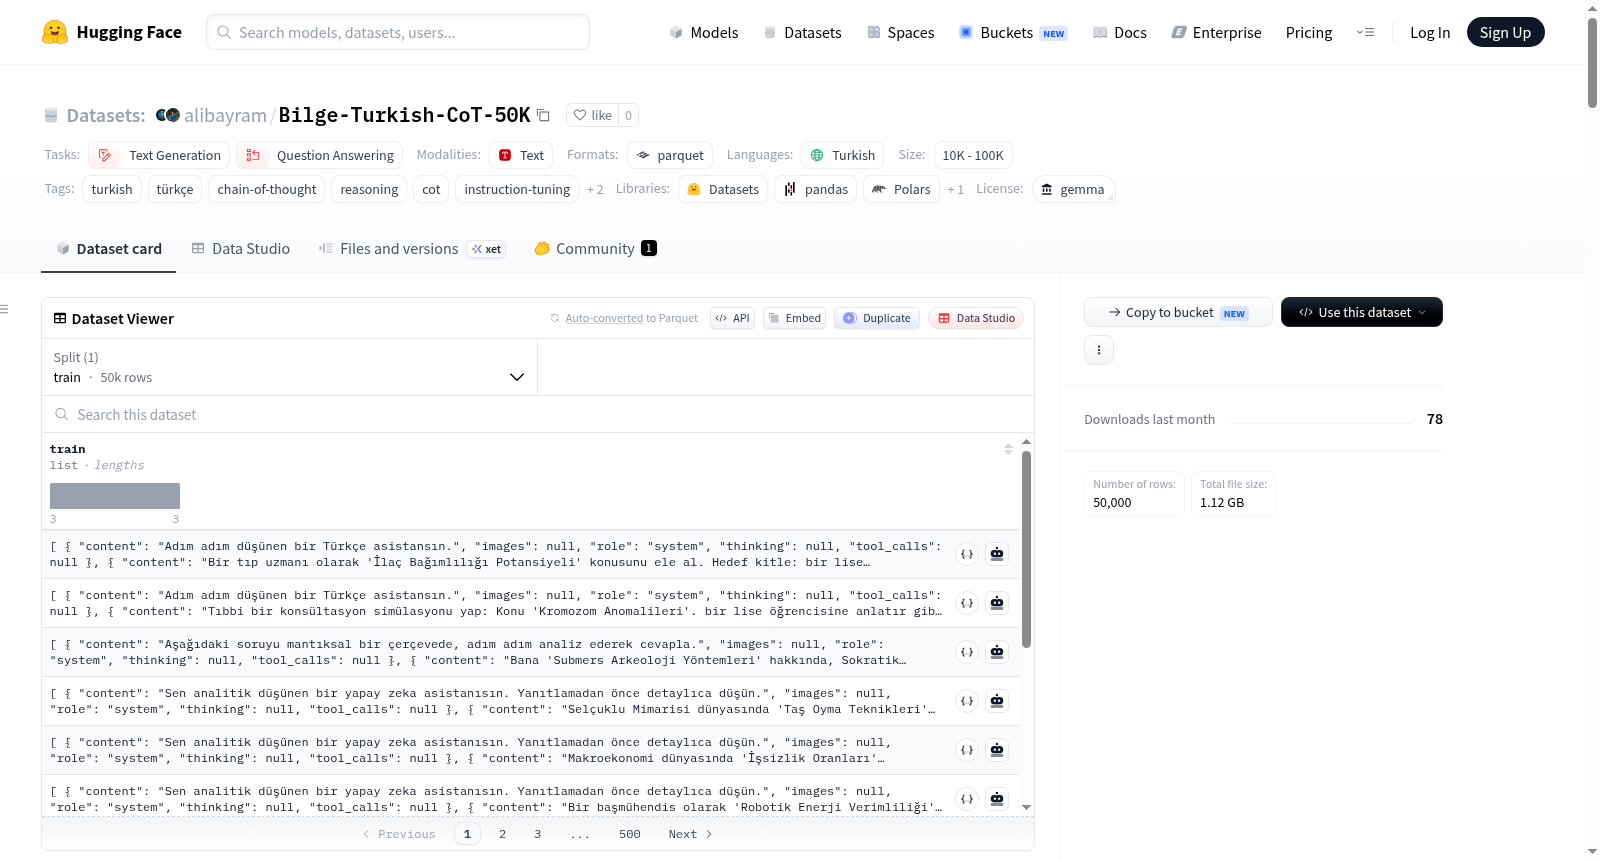
alibayram/Bilge-Turkish-CoT-50K 数据集图片
构建方式
Bilge-Turkish-CoT-50K数据集源自约30GB的原始土耳其语思维链(Chain-of-Thought)文本数据,经由一套包含11个阶段的规则型过滤流水线精炼而成。该流水线依次执行语言检测、长度控制、重复检测、拼写校验、思维链比例调节、矛盾识别、令牌数限制、局部敏感哈希去重、指令质量去重、格式验证及最终人工抽样复核,最终从249,292条高质量过滤结果中选取50,000条样本,形成兼具学术严谨性与推理引导性的子集。
特点
该数据集以三角色对话结构组织,每条样本包含系统提示、用户问题及助手回答。助手回答内嵌可见的思考过程,以<think>标签封装逐步推理,随后提供结构化的Markdown格式最终答案。内容横跨科学、历史、文学、哲学、医学等多个领域,采用悖论分析、苏格拉底对话、类比、案例研究等多种解释手法,兼顾中学生、大学生及专家等多层次受众,平均回答长度约5,000至7,000个令牌。
使用方法
用户可通过HuggingFace Datasets库直接加载数据集,执行`load_dataset("bugrabilge/Bilge-Turkish-CoT-50K", split="train")`获取全部50,000条训练样本,每条样本以messages JSON格式呈现,包含system、user、assistant三类角色。该数据集适用于土耳其语大语言模型的推理微调、结构化思维链训练、学术助手开发及土耳其语推理能力评估,亦支持手动加载JSONL文件进行定制化处理。
背景与挑战
背景概述
在自然语言处理领域,思维链(Chain-of-Thought)推理微调方法显著提升了大型语言模型的逻辑推理能力。然而,现有高质量CoT数据集主要集中在英语等资源丰富语言,对低资源语言的覆盖严重不足。为弥合这一鸿沟,土耳其研究员Buğra Bilge Çelik于2026年发布了Bilge-Turkish-CoT-50K数据集,该数据集由来自约30GB原始土耳其语CoT数据经11步规则筛选及去重后,从249,292条高质量样本中精选的50,000条实例构成。数据集采用HuggingFace对话格式,包含system、user、assistant三轮交互,助理回答内部嵌入显式推理标记,鼓励模型逐步思考后再生成多学科领域(科学、历史、文学、医学等)的长篇结构化解说性回复。该数据集旨在为土耳其语大模型推理微调与学术研究提供基础性资源,推动土耳其语人工智能生态在可解释推理领域的发展。
当前挑战
该数据集面临的核心挑战包括:第一,领域问题层面,土耳其语大模型缺乏标准的思维链推理训练数据,难以支撑复杂多步推理任务,同时现有模型在土耳其语上普遍存在推理过程不透明、易产生幻觉的不足,亟需结构化推理引导。第二,数据构建过程中,研究者面临多源异质数据整合的困难,需设计复杂过滤流水线(涉及语言检测、拼写校验、重复去除、矛盾检测等11道工序)才能保证约10%的样本通过率,同时需控制长回复偏置以确保学术风格与真实对话场景的平衡,并在跨学科覆盖(科学、历史、文学、哲学等)中维持领域分布均衡性。此外,事实性错误的潜在风险、对代码生成与工具调用等专业任务的支持不足,以及高比例的正式土耳其语偏向,都限制着该数据集在广泛下游场景中的直接泛化能力。
常用场景
经典使用场景
在自然语言处理领域,针对土耳其语的推理能力增强是当前研究的热点之一。Bilge-Turkish-CoT-50K 数据集专为土耳其语大语言模型的链式思维微调而设计,其经典使用场景聚焦于训练模型在 <think> 块内执行可见的逐步推理过程,并最终生成结构化的长篇幅回答。该数据集涵盖了科学、历史、文学、哲学、医学等多个学科,通过多样化的问答对,使模型掌握从问题分析、假设验证到结论推导的完整认知链路,是提升土耳其语模型逻辑推理与解释性能力的核心资源。
衍生相关工作
该数据集直接衍生自对 Omni-31B-Turkish-Reasoning-Model 训练所使用的 249K 过滤数据集的精炼抽取,因而与之构成了紧密的模型与数据共生关系。在此基础上,研究者可进一步开展基于该数据集的土耳其语推理基准测试集的构建工作,用于评估不同模型在逐步推理任务上的表现。此外,该数据集所采用的 11 阶段过滤管道——涵盖语言检测、重复消除、格式验证与事实一致性检查——本身可作为一套方法论,启发其他语言或领域在构建高质量推理数据集时的流程设计,推动链式思维数据生产范式的标准化演进。
数据集最近研究
最新研究方向
在自然语言处理领域,链式思维推理与多语言大模型的融合成为前沿热点。Bilge-Turkish-CoT-50K数据集的问世,恰逢全球对推理增强型语言模型需求激增之际,尤其填补了土耳其语在结构化推理训练数据上的空白。该数据集通过50,000例包含<think>块的对话样本,将显式推理过程与学术性长文本回答相结合,覆盖科学、历史、哲学等多学科领域,为土耳其语大模型注入可解释的逐步推理能力。其生成流程中采用11阶段规则过滤与LSH去重,确保数据质量,并直接支撑了Omni-31B-Turkish-Reasoning-Model的微调。这一资源不仅推动土耳其语AI生态向认知对话系统演进,也为低资源语言在推理导向的指令微调研究中树立了标杆,对提升多语言模型在复杂问答、教育辅助等场景中的鲁棒性具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

