
Balanced_Adult_Split_DS
收藏官方服务:
资源简介:
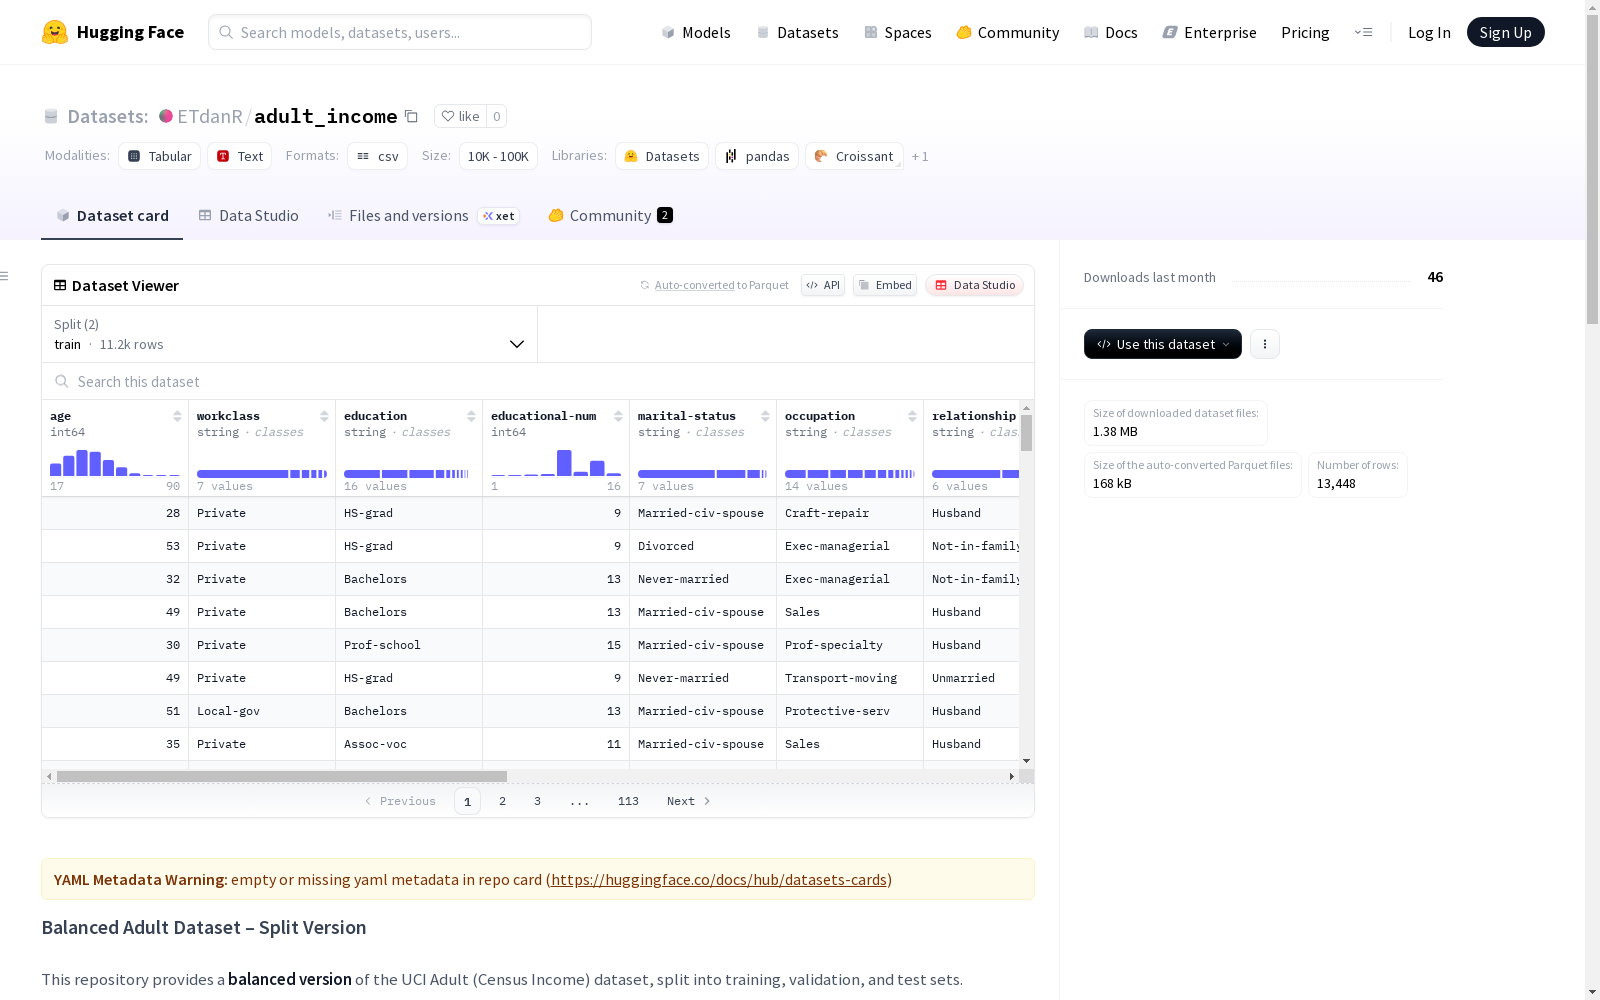
平衡版本的UCI Adult (Census Income)数据集,包含训练集、验证集和测试集。该数据集经过平衡处理,确保每个收入类别有相同数量的样本。数据集特征包括年龄、工作类别、教育、婚姻状况、职业、种族、性别、每周工作小时、原生国家和年收入是否超过50,000美元的分类标签。
The balanced version of the UCI Adult (Census Income) dataset includes training, validation, and test sets. This dataset has been balanced to ensure an equal number of samples for each income category. The features of the dataset cover age, work class, education, marital status, occupation, race, gender, weekly working hours, native country, and the classification label indicating whether an individual's annual income exceeds $50,000.
创建时间:
2025-05-31
原始信息汇总
Balanced Adult Dataset – Split Version 数据集概述
数据集描述
- 本数据集是UCI Adult(人口普查收入)数据集的平衡版本,专门为表格分类实验设计。
- 原始数据集用于二元分类,预测个人年收入是否超过5万美元。
- 本版本特点:
- 对收入类别(
>50K和<=50K)进行了平衡处理,确保两类样本数量相等。 - 数据已划分为:
- 训练集 (
train_data.csv) - 验证集 (
validation_data.csv) - 实验评估集 (
experiment_data.csv)
- 训练集 (
- 对收入类别(
数据特征
包含以下字段:
- 年龄 (Age)
- 工作类型 (Workclass)
- 教育程度 (Education)
- 婚姻状况 (Marital status)
- 职业 (Occupation)
- 种族 (Race)
- 性别 (Gender)
- 每周工作时间 (Hours per week)
- 原籍国家 (Native country)
- 收入 (Income,目标变量)
应用场景
-
梯度提升树 (GBT)
- 直接应用于预处理后的表格特征(如分类特征编码)
- 作为鲁棒性比较的基准模型
-
RoBERTa (基于Transformer的大语言模型)
- 将每行数据转换为伪句子格式,例如:
"age: 39, education: Bachelors, gender: male, ..., income: <mask> than 50,000" - 微调模型预测掩码词是
greater还是less
- 将每行数据转换为伪句子格式,例如:
文件说明
| 文件名 | 用途 |
|---|---|
train_data.csv |
平衡后的训练数据 |
validation_data.csv |
模型调优验证集 |
experiment_data.csv |
最终评估测试集 |
关联项目
支持以下研究项目:
Adversarial Attack on Tabular Classification
比较RoBERTa与GBT在对抗条件下的鲁棒性表现
作者
搜集汇总
数据集介绍
构建方式
在人口统计学与收入预测研究领域,Balanced_Adult_Split_DS数据集基于经典的UCI Adult数据集进行重构。通过精心设计的数据平衡策略,该数据集确保了高收入与低收入两类样本数量均等,有效缓解了类别不平衡问题。原始数据被划分为训练集、验证集和测试集,分别用于模型训练、超参数调优及最终性能评估,每个子集均保留了年龄、职业、教育程度等关键特征,并统一以CSV格式存储。
特点
该数据集的核心特点在于其均衡的类别分布与清晰的结构划分。所有样本均经过严格筛选,确保收入超过5万美元与低于5万美元的样本数量一致,为模型公平性评估提供了基础。特征维度涵盖人口统计与职业属性,如工作类型、婚姻状况、种族等,兼具连续与离散变量。数据集支持梯度提升树等传统分类方法,也可转换为伪文本序列供预训练语言模型微调,体现了跨模态应用的灵活性。
使用方法
使用本数据集时,研究者可依据任务需求选择不同的建模路径。对于传统表格分类,需对类别特征进行编码后输入梯度提升树等模型;若采用语言模型如RoBERTa,则需将特征值转换为自然语言序列,例如“年龄:39, 教育:学士, 收入:<掩码>5万美元”的形式进行掩码预测。训练阶段使用train_data.csv,验证集用于调参,最终性能需在experiment_data.csv上测试,确保结果可比性。
背景与挑战
背景概述
Balanced_Adult_Split_DS数据集源于UCI Adult数据集,该数据集自1996年由加州大学欧文分校发布以来,已成为收入预测研究的重要基准。作为二元分类任务的核心资源,它通过人口统计和职业特征预测个体年收入是否超过5万美元,广泛应用于社会经济分析和机器学习模型评估。本平衡版本由ETdanR和yuvalira等研究人员于近期构建,旨在解决原始数据类别不平衡问题,并划分为训练、验证和测试集,为表格分类领域的梯度提升树和Transformer模型提供标准化实验平台。
当前挑战
该数据集致力于应对收入预测中因样本分布不均导致的模型偏差挑战,通过平衡处理提升分类器对少数类的识别能力。在构建过程中,研究人员需克服原始数据缺失值处理、类别特征编码一致性以及跨文化收入标准归一化等难题。此外,将表格数据转化为自然语言序列以适配预训练语言模型时,需确保语义保留与结构对齐,这为对抗攻击研究中的模型鲁棒性评估设立了新的技术门槛。
常用场景
经典使用场景
在表格分类研究领域,Balanced_Adult_Split_DS数据集常被用于评估梯度提升树与预训练语言模型的性能对比。通过将人口普查特征转换为结构化表格或伪自然语言序列,研究者能够系统比较传统机器学习方法与前沿Transformer架构在收入预测任务上的表现差异。该数据集提供的平衡化处理确保了类别分布的均衡性,为模型评估提供了可靠基准。
解决学术问题
该数据集有效解决了表格数据分类中类别不平衡对模型评估造成的偏差问题。通过平衡化处理与标准划分,它为机器学习公平性研究、模型鲁棒性测试提供了基准平台。特别在探索语言模型处理结构化数据的可行性方面,推动了跨模态学习方法的发展,为表格数据与自然语言处理的融合研究奠定了数据基础。
衍生相关工作
该数据集催生了多项对抗攻击鲁棒性研究,如原项目中针对梯度提升树与RoBERTa的对抗样本比较实验。相关工作进一步拓展到表格数据隐私保护、联邦学习等方向,衍生出基于该数据集的模型解释性研究。这些探索为理解不同模型架构在结构化数据上的脆弱性提供了重要案例。
以上内容由遇见数据集搜集并总结生成


