RankJudge
收藏资源简介:
RankJudge是一个合成基准生成数据集,专门用于评估大型语言模型(LLM)在多轮对话中作为法官的能力。该数据集旨在解决现有LLM-as-a-Judge基准主要关注简单问答任务,无法匹配复杂多轮对话评估需求的问题。其核心内容基于参考文档(包括计算机科学论文、医学论文和10-K财务报告)构建对话对,每个对话对包含一个好的对话和一个在某一轮次注入了单一特定缺陷(如逃避回答、捏造答案等)的坏的对话,从而能够明确标记优劣并隔离失败类别,为法官评估提供严格的联合正确性标准。数据集包含两个主要配置:pairs(包含652个对话对及其真实标签、领域、元数据、缺陷轮次和源文档上下文)和matches(包含13,692条记录,对应21个前沿LLM法官对对话对的预测结果,包括优劣判断、缺陷预测、与真实标签的对比、原始响应文本和API使用统计)。该数据集适用于文本分类、问答等任务,主要用于LLM评估、基准测试和多轮对话系统性能研究,数据规模在1万到10万之间,语言为英语,采用CC BY 4.0许可证发布。
RankJudge is a synthetic benchmark generation dataset for evaluating large language models (LLMs) as judges in multi-turn dialogues. It aims to address the limitation of existing LLM-as-a-Judge benchmarks that primarily focus on simple QA tasks and cannot meet the needs of complex multi-turn dialogue evaluation. The core content is based on reference documents (computer science papers, medical papers, or 10-K financial reports) to construct dialogue pairs. Each pair includes a good dialogue and a bad dialogue with a single specific defect (such as evasion or fabrication) injected into one turn. This construction allows for clear labeling of better or worse dialogues and isolates failure categories to individual turns, providing a strict joint correctness standard for judge evaluation. The dataset consists of two main configurations: 1) pairs containing 652 dialogue pairs with ground truth labels, including dialogue content, domain (machine learning, biomedical, finance), true superiority judgment, generation plan, user/assistant behavior type metadata, defect turn, and source document context; and 2) matches containing 13,692 records corresponding to predictions from 21 state-of-the-art LLM judges on the 652 dialogue pairs, including model information, predictions on superiority, defect turn and type, comparison with ground truth (including strict joint correctness judgment), original response text, and API usage and cost statistics. It is suitable for tasks like text classification and QA, primarily used for LLM evaluation, benchmarking, and multi-turn dialogue system performance research. The data scale ranges from 10,000 to 100,000, the language is English, and it is released under the CC BY 4.0 license.
数据集概述
RankJudge 是一个用于评估 LLM 在多轮对话中作为评判者(LLM-as-a-judge)能力的合成基准生成器。
核心任务
- 文本分类 与 问答。
- 专注于多轮对话场景,每对对话中一个为优质对话,另一个被注入了单一弱点。
数据规模
- 总样本数:10,000 到 100,000 之间。
- 已发布评估切片:
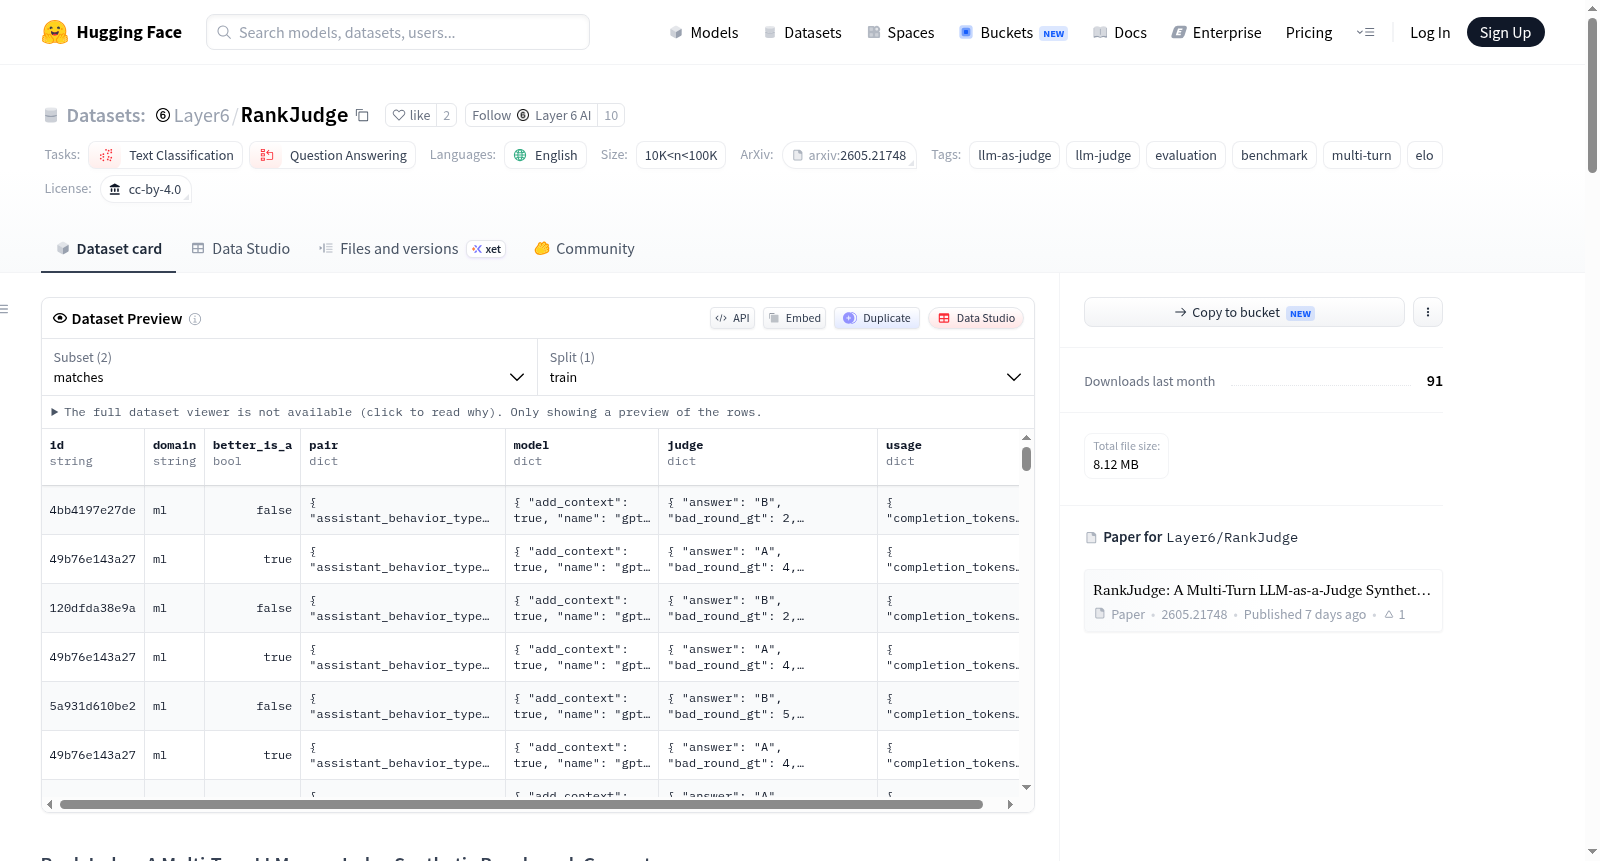
- pairs 配置:652 对对话(优质与劣质对话配对),包含真实标签。
- matches 配置:13,692 条预测记录,每个(对话对,评判模型)组合对应一行。
语言
- 英语(en)。
领域
- 机器学习(ml)、生物医学(med)、金融(fin)。
数据内容
-
pairs 数据集字段:
字段 描述 id对话对唯一标识,可与 matches 连接 domain领域(ml / med / fin) convo_a/convo_b对话 A 与对话 B(角色与内容列表) better_is_a真实标签:A 是否优质对话 plan对话生成方案(优质/劣质) metadata.user_behavior_type7 种用户行为之一(如 focused, skeptical) metadata.assistant_behavior_type7 种助手弱点之一(如 evasion, fabricated_answer) metadata.n_rounds对话轮次数 metadata.bad_round_index弱点所在轮次(从 1 开始) metadata.context源文档上下文(标题、摘要、参考问答对) -
matches 数据集字段(部分关键字段):
字段 描述 id对话对标识 model.name评判模型名称 judge.answer评判模型预测的优质对话(A 或 B) judge.correct_verdict预测结果是否正确 judge.correct_bad_round弱点轮次预测是否正确 judge.correct_behavior_type弱点类型预测是否正确 judge.correct三项全部正确(严格正确性标准)
数据来源与构建
- 基于源文档(计算机科学论文、医学论文或 10-K 文件)生成。
- 通过注入单一弱点构造对话对,确保优劣标签明确,并能将失败类别精确归因到特定轮次。
许可协议
- CC BY 4.0(源文档保留其原始许可)。
引用
- 如需引用,请参考论文:
arXiv:2605.21748。