general_english_pashto
收藏资源简介:
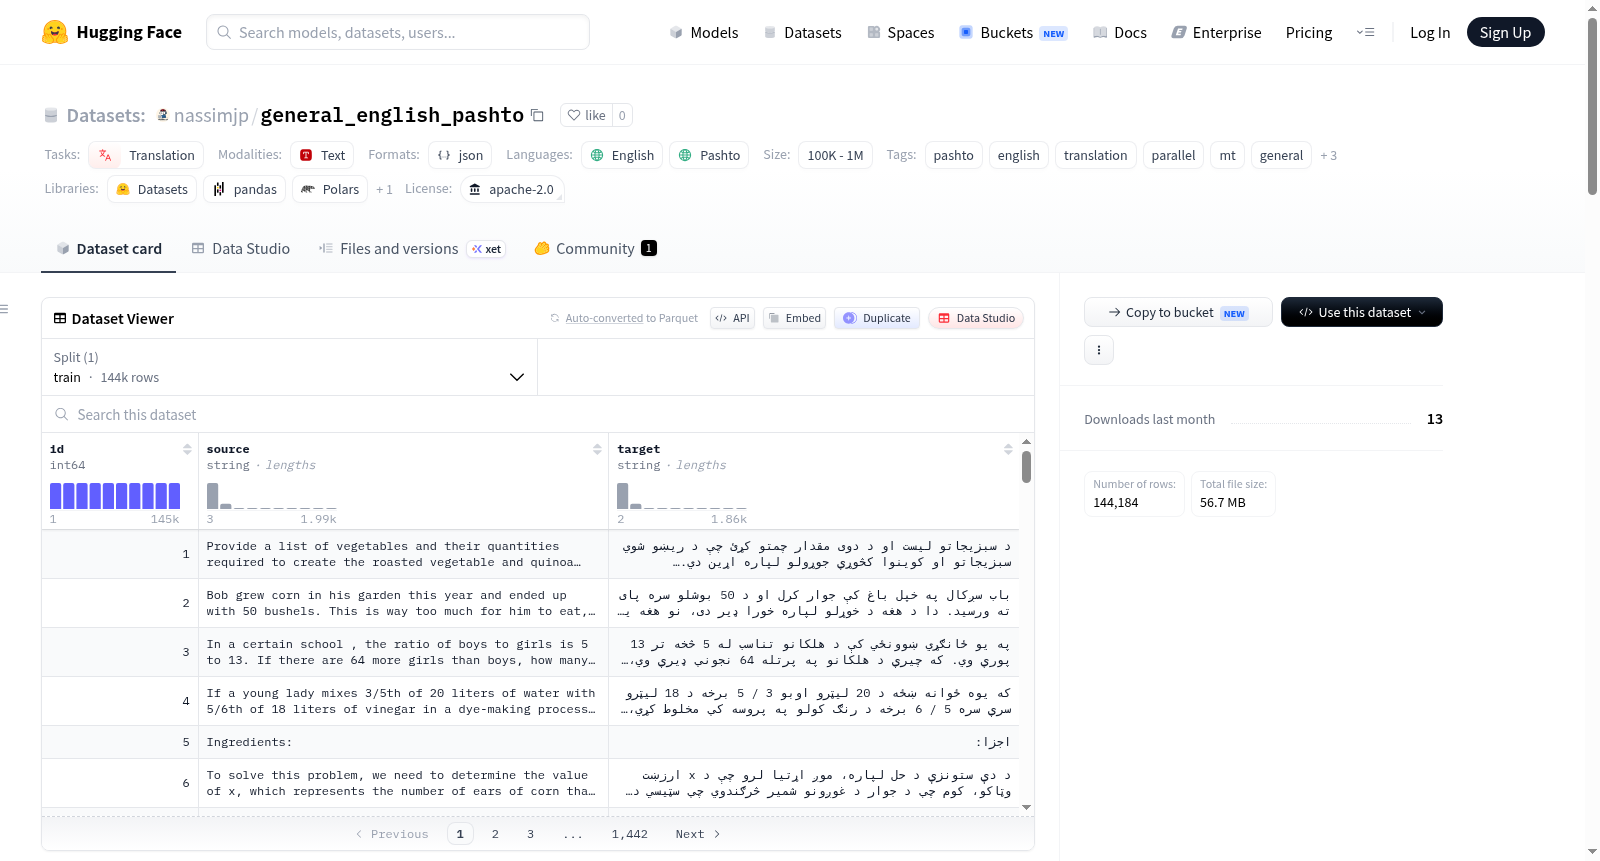
General English Pashto 是一个大规模、高质量、标准化的英语到普什图语平行语料库。该数据集专门收集了通用日常英语文本的普什图语翻译,旨在为普什图语大语言模型、机器翻译系统、双语嵌入模型以及通用翻译模型的开发提供基础资源。数据集经过严格的预处理流程,包括Unicode清理、文本标准化、去重、句子对齐、质量评分和领域过滤,确保了数据的洁净度与一致性。数据以JSONL格式存储,每条记录包含一个平行的句子对,分别存储在english和pashto字段中,采用UTF-8编码。其内容覆盖广泛的通用领域,如日常对话、常识、信息性文本和解释性段落,译文风格中性。该数据集主要适用于英语→普什图语机器翻译、普什图语LLM预训练、双语词向量对齐、通用领域翻译模型构建,以及为指令微调创建平行语料。数据集采用Apache License 2.0许可协议发布。
General English Pashto is a large-scale, high-quality, standardized English-to-Pashto parallel corpus. This dataset specifically collects Pashto translations of general daily English texts, aiming to provide foundational resources for the development of Pashto large language models, machine translation systems, bilingual embedding models, and general translation models. The dataset undergoes rigorous preprocessing steps, including Unicode cleaning, text normalization, deduplication, sentence alignment, quality scoring, and domain filtering, ensuring data cleanliness and consistency. Data is stored in JSONL format, with each record containing a parallel sentence pair stored in the english and pashto fields, using UTF-8 encoding. Its content covers a wide range of general domains, such as daily conversations, common sense, informative texts, and explanatory passages, with a neutral translation style. The dataset is primarily suitable for English→Pashto machine translation, Pashto LLM pre-training, bilingual word vector alignment, general-domain translation model construction, and creating parallel corpora for instruction fine-tuning. The dataset is released under the Apache License 2.0.
数据集概述:General English Pashto
- 名称: General English Pashto
- 许可证: Apache License 2.0
- 语言: 英语 (en)、普什图语 (ps)
- 任务: 翻译 (translation)
- 规模: 100K < 样本数 < 500K
- 格式: JSONL,每行包含一个平行句对,字段包括:
english: 原始英语文本pashto: 对应的普什图语翻译- 编码为 UTF-8,经过清洗、规范化和去重
数据集用途
- 英语 → 普什图语机器翻译
- 普什图语大语言模型 (LLM) 预训练
- 双语嵌入对齐
- 通用领域翻译模型
- 构建指令微调的平行语料
领域覆盖
数据集涵盖广泛的通用主题,包括:
- 日常对话
- 通用知识
- 信息性文本
- 说明性段落
- 中性语气翻译
数据质量处理
数据集经过以下流程处理:
- Unicode 清理
- 文本规范化
- 去重
- 句子对齐
- 质量评分
- 领域过滤
作者与引用
-
作者: Nassim JP(Spinzar Enterprises Inc. 创始人,日本)
-
引用格式:
@misc{general_english_pashto_2026, author = {Nsibullah Nassim}, title = {General English Pashto}, year = {2026}, publisher = {HuggingFace Datasets}, howpublished = {https://huggingface.co/datasets/nassimjp/general_english_pashto} }
更多详情请访问:https://huggingface.co/datasets/nassimjp/general_english_pashto