Agent-Trace Corpus (ATC)
收藏资源简介:
Agent-Trace Corpus (ATC)是由帕绍大学团队基于AgentSim平台构建的大规模可验证推理轨迹数据集,涵盖MS MARCO、Quasar-T和CausalQA三大信息检索基准。该数据集包含103,567条细粒度推理步骤,每条轨迹均关联具体检索文档,实现100%实质性答案的 grounding验证。通过嵌入聚类和主动验证机制,确保数据覆盖广泛主题且质量可靠,适用于RAG智能体的训练与行为分析,推动可信赖AI代理的发展。
Agent-Trace Corpus (ATC) is a large-scale verifiable reasoning trace dataset constructed by the team from the University of Passau based on the AgentSim platform. It covers three information retrieval benchmarks: MS MARCO, Quasar-T and CausalQA. This dataset contains 103,567 fine-grained reasoning steps, with each trace linked to specific retrieved documents, enabling 100% grounding verification for substantive answers. Through embedding clustering and active validation mechanisms, the dataset ensures wide topical coverage and reliable quality, which is applicable to the training and behavior analysis of RAG AI Agents, and promotes the development of trustworthy AI agents.
AgentSim Agent-Trace Corpus (ATC) 数据集概述
基本信息
- 数据集名称:AgentSim Agent-Trace Corpus (ATC)
- 数据集地址:https://huggingface.co/datasets/searchsim/agentsim-atc
- 许可证:MIT License(但上游源数据集保留各自原有许可证)
- 语言:英文
- 数据集大小:100K < n < 1M
数据集构成
核心规模
| 指标 | 数量 |
|---|---|
| 推理步骤(reasoning steps) | 103,567 |
| 监督三元组(query-document-answer) | 20,548 |
| 唯一检索文档 | 199,968 |
数据来源
数据集基于三个信息检索基准构建:
- Quasar-T:38,915 步
- CausalQA:36,192 步
- MSMARCO:28,460 步
数据文件结构
traces/<dataset>.jsonl.gz # 步骤级推理轨迹(共103,567条) trajectories/<dataset>.jsonl.gz # 状态-动作-奖励元组(共103,564条) supervised/<dataset>.jsonl.gz # 查询-文档-答案三元组(共20,548条) queries/ # 所有26,176个生成的查询 retrievals/ # 199,968个唯一检索文档 corpus_stats.json # 语料库级元数据
数据模式(Schema)
traces/(步骤级推理)
字段包括:step_id, goal, action, rationale_tag, operator_intent, stop_condition, timestamp, private_reasoning, llm_input, llm_output, tool_input, tool_output, evidence_retrieved, evidence_count, execution_time_ms, error, _source, source_dataset, source_license
trajectories/(状态-动作元组)
字段包括:state, action, reward, next_state, done, _source, source_dataset, source_license
supervised/(监督三元组)
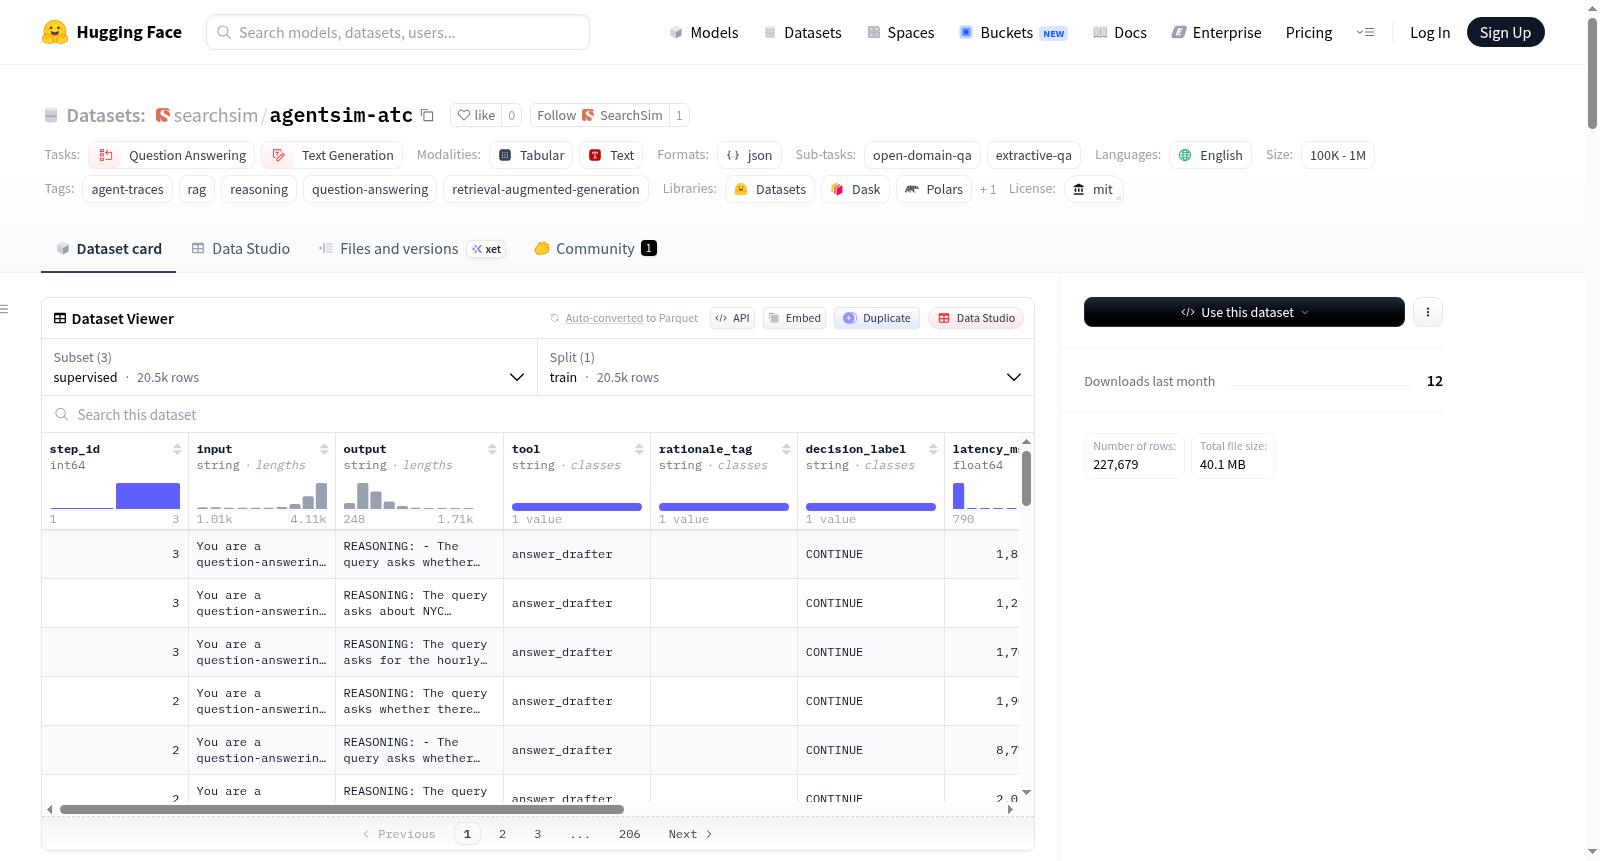
字段包括:step_id, input, output, tool, rationale_tag, decision_label, latency_ms, tokens, _source, source_dataset, source_license
许可证与使用限制
| 源数据集 | 许可证 | 允许用途 |
|---|---|---|
| MSMARCO | MS Research | 仅限研究用途,非商业 |
| Quasar-T | BSD-3-Clause | 允许商业使用 |
| CausalQA | Research use | 需检查上游使用条款 |
重要提示:每行数据都带有 source_license 字段,用户可根据许可证进行过滤。AgentSim生成的包装数据使用MIT许可证,但不覆盖上游源数据的原有限制。
预期用途
- 基础模型信息搜索行为分析
- 基于接地监督的思维链微调
- 查询重构策略的模仿学习
- 从大模型到小模型的知识蒸馏
- 基于每步分歧分数的过程奖励建模
超出范围的使用
- 训练与OpenAI服务竞争的模型(如果训练集中包含GPT-4o衍生的轨迹)
- 对MSMARCO衍生数据的商业再分发
生成流程
由 AgentSim 平台生成,采用两个关键机制:
- 语料感知种子选择:使用K-Means聚类、MMR选择和检索新颖性过滤
- 主动验证:分析师-评论者-评审者流水线,对分歧分数高于0.4的步骤进行人工审核
局限性
- 继承了源IR基准的偏差(MSMARCO的网页段落偏差、Quasar-T的冷知识偏差)
- 论文中报告的行为发现(GPT-4o vs Mistral-Large vs DeepSeek-V3的重构模式)特定于被评估的基础模型
关联数据集
agentsim-atc(本数据集):面向单跳/浅层QA的103,567步轨迹agentsim-atc-multihop:面向多跳QA的1,490条SFT轨迹 + 2,980条DPO偏好对
加载方式
python from datasets import load_dataset traces = load_dataset("searchsim/agentsim-atc", "traces", split="train") trajs = load_dataset("searchsim/agentsim-atc", "trajectories", split="train") sup = load_dataset("searchsim/agentsim-atc", "supervised", split="train")