
DCAgent2/bfcl_parity_Qwen3_235B_A22B_Instruct_2507_tput_20260430_052739
收藏数据链接:
官方服务:
资源简介:
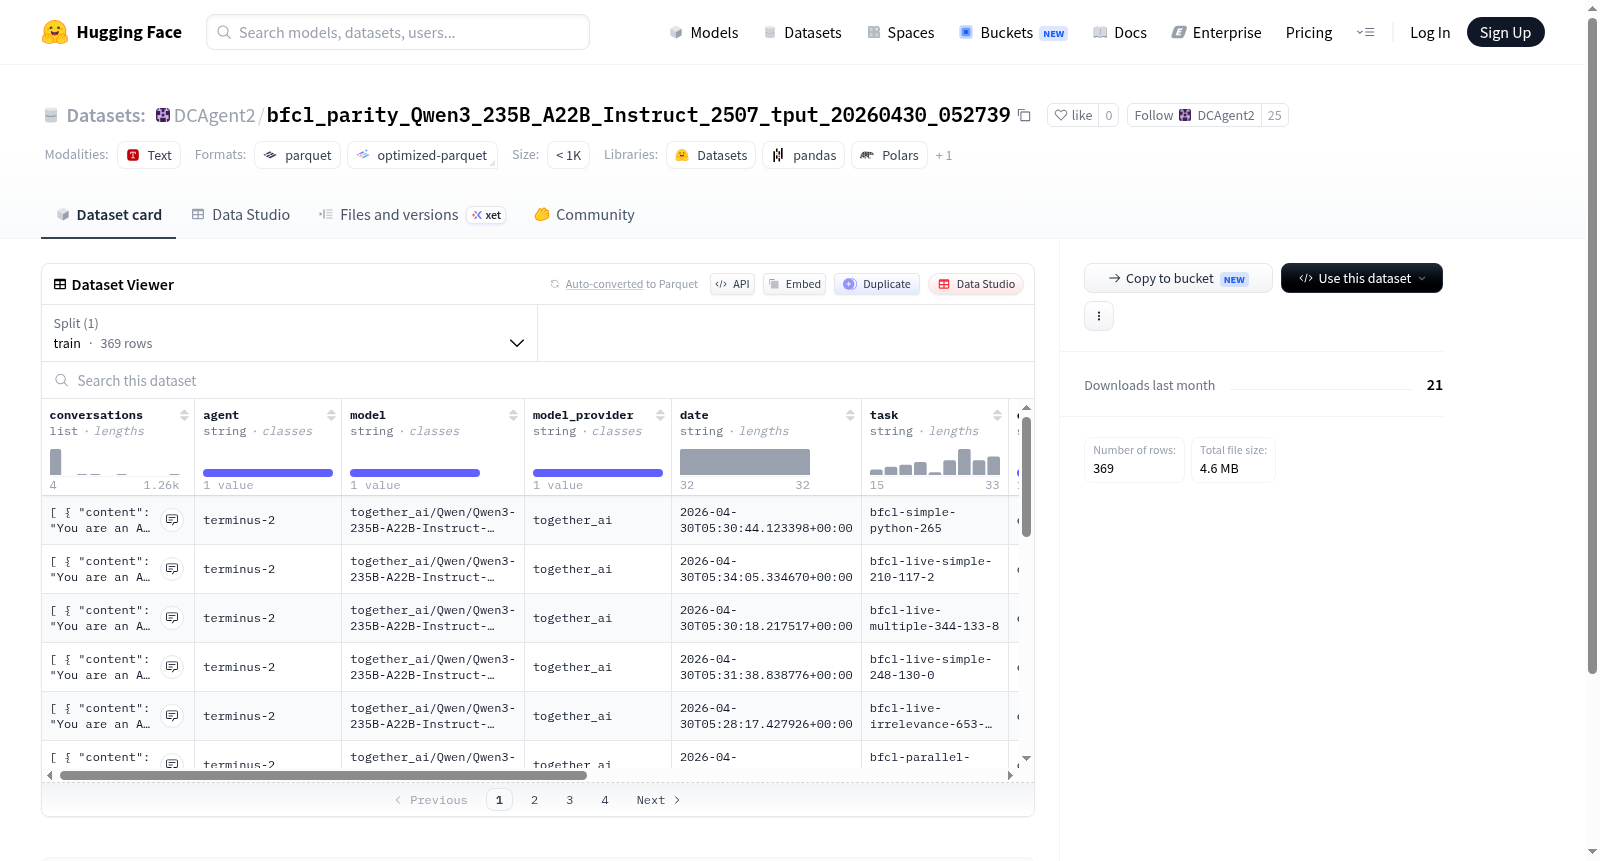
该数据集包含多个智能体与用户的对话记录,涉及不同模型、任务和试验回合。每条记录包括对话内容(角色和文本)、智能体名称、模型及提供商、日期、任务类型、回合编号、运行ID、试验名称、最终结果和验证器输出。数据用于评估或分析智能体在特定任务中的对话表现。
This dataset contains conversation records between multiple agents and users, involving different models, tasks, and episodes. Each record includes conversation content (role and text), agent name, model and provider, date, task type, episode number, run ID, trial name, final result, and verifier output. The data is used to evaluate or analyze agent dialogue performance in specific tasks.
提供机构:
DCAgent2搜集汇总
数据集介绍
构建方式
本数据集源自BFCL(Berkeley Function Calling Leaderboard)基准测试,旨在评估大语言模型在函数调用任务上的表现。构建过程中,以Qwen3-235B-A22B-Instruct模型为评测对象,于2025年4月30日生成运行实例。数据涵盖多轮对话记录,每条样本包含用户与模型的交互内容、模型标识、提供方、日期、具体任务类型、运行批次(episode)及唯一运行ID。此外,还存储了模型生成的调用结果(result)与验证器输出(verifier_output),从而构成结构化的评测数据集合。
特点
该数据集的核心特点在于其专注于函数调用场景下的模型性能追踪。每条数据均带有细粒度的元信息,包括agent类型、模型版本、任务名称及时间戳,便于进行多维度分析。对话字段(conversations)以列表形式存储角色与内容对,清晰呈现了交互流程。数据集仅含训练集,共计369条样本,规模精简但针对性强,尤其适合用于比较不同模型在相同任务上的调用准确率与逻辑一致性。
使用方法
使用时,可直接加载HuggingFace Datasets库读取该数据集。由于数据已按标准格式组织,用户可通过拆分键'train'获取全部样本。每条数据中的'conversations'字段可用于提取对话历史,配合'result'与'verifier_output'字段进行模型输出质量评估。建议结合BFCL的官方评估脚本,对模型在不同函数调用任务上的表现进行量化分析,或将其作为强化学习微调中的参考范例。
背景与挑战
背景概述
在大型语言模型(LLM)能力快速迭代的背景下,面向智能体(Agent)任务的行为评估与对齐成为模型优化的重要方向。该数据集bfcl_parity_Qwen3_235B_A22B_Instruct_2507_tput_20260430_052739由相关研究团队构建,旨在量化分析通义千问Qwen3-235B-A22B-Instruct模型在特定智能体基准任务上的输出行为一致性。数据集创建于2025年4月30日,收录了369条对话样本,每条包含完整的对话记录及模型输出、验证结果等结构化信息,核心研究问题聚焦于评估模型在工具调用、任务规划等场景下的行为稳定性与可靠性。该数据集通过精细化的任务切片与验证机制,为LLM的智能体能力评测提供了高质量的行为参考基线,对推动模型在复杂交互任务中的对齐研究具有重要参考价值。
当前挑战
该数据集所解决的领域问题主要来自两方面。其一,在智能体任务中,大型语言模型常面临输出行为不稳定、与预设规范偏离的挑战,例如模型在工具调用时出现参数错误或逻辑冲突,导致任务执行失败。该数据集通过收集多轮对话行为数据并搭配验证器输出,为识别此类偏差提供了标准化测试样本。其二,构建过程中面临的核心挑战在于行为数据的高质量获取与标注一致性:由于智能体任务涉及复杂工具链与多步推理,人工标注极易引入主观误差;同时,模型输出的多样性使得自动验证器设计需兼顾通用性与精确性,确保每个样本的“结果”字段能准确反映行为是否符合预期规范,从而支撑后续的模型行为对齐与偏差分析。
常用场景
经典使用场景
在大型语言模型(LLM)与人工智能代理(Agent)交叉研究的蓬勃发展中,bfcl_parity_Qwen3_235B_A22B_Instruct_2507_tput_20260430_052739数据集以其对模型推理效率与任务执行稳定性兼具的追踪优势,成为评估Agent系统行为模式的经典基石。该数据集尤其适用于对Qwen3系列模型的行为鲁棒性、多轮对话中的工具调用能力以及动作链完整性进行系统性校验,研究者常借助其结构化的conversations字段与verifier_output,探讨模型在复杂代理任务中对指令遵循的精准度与响应一致性。其经典的学术用途在于为不同规模的模型提供在统一评估框架下的性能对照基准,从而揭示规模扩大与行为可预测性之间的微妙关联。
衍生相关工作
围绕该数据集已衍生出一系列富有奠基意义的研究工作。其中最具代表性的是将数据集内模型运行时的对话记录与verifier_output结合,用于构建针对Agent行为的自动缺陷检测工具,这种工具能够精确标记出模型在复杂任务中产生的虚假状态更新或工具调用错误。另一项重要延展是将其作为训练数据以蒸馏更小模型的代理能力,研究者利用该数据集中的高成功率轨迹构建监督信号,成功使参数规模远小于Qwen3_235B的模型在同类代理任务上达到可观表现。此外,该数据集还催生了以任务成功率为核心指标的模型对比排行榜,推动了代理系统评估范式的标准化演进。
数据集最近研究
最新研究方向
该数据集聚焦于大规模语言模型在智能体(Agent)任务中的推理与执行能力评估,尤其是针对Qwen3-235B-A22B-Instruct这类混合专家(MoE)架构模型在复杂指令遵循与多轮对话场景下的吞吐量(throughput)和精准度(parity)对比研究。当前前沿方向集中于借助结构化对话日志与验证器反馈,量化模型在真实环境中的行为一致性与任务完成度,为构建更可靠的自主智能体系统提供基准支持。
以上内容由遇见数据集搜集并总结生成


