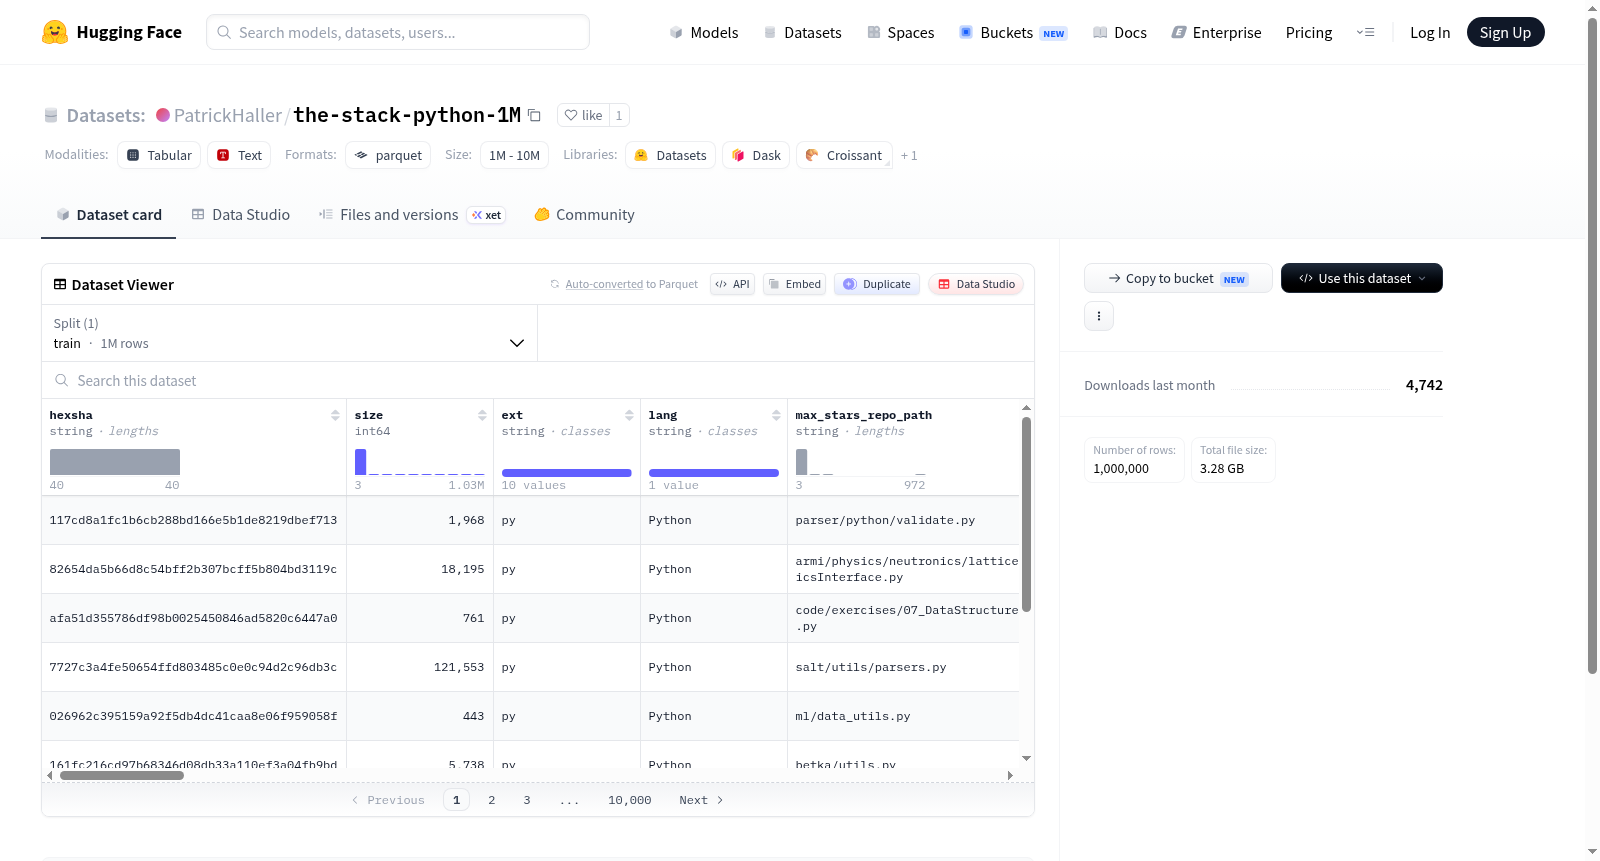
PatrickHaller/the-stack-python-1M
收藏资源简介:
--- dataset_info: features: - name: hexsha dtype: string - name: size dtype: int64 - name: ext dtype: string - name: lang dtype: string - name: max_stars_repo_path dtype: string - name: max_stars_repo_name dtype: string - name: max_stars_repo_head_hexsha dtype: string - name: max_stars_repo_licenses sequence: string - name: max_stars_count dtype: int64 - name: max_stars_repo_stars_event_min_datetime dtype: string - name: max_stars_repo_stars_event_max_datetime dtype: string - name: max_issues_repo_path dtype: string - name: max_issues_repo_name dtype: string - name: max_issues_repo_head_hexsha dtype: string - name: max_issues_repo_licenses sequence: string - name: max_issues_count dtype: int64 - name: max_issues_repo_issues_event_min_datetime dtype: string - name: max_issues_repo_issues_event_max_datetime dtype: string - name: max_forks_repo_path dtype: string - name: max_forks_repo_name dtype: string - name: max_forks_repo_head_hexsha dtype: string - name: max_forks_repo_licenses sequence: string - name: max_forks_count dtype: int64 - name: max_forks_repo_forks_event_min_datetime dtype: string - name: max_forks_repo_forks_event_max_datetime dtype: string - name: content dtype: string - name: avg_line_length dtype: float64 - name: max_line_length dtype: int64 - name: alphanum_fraction dtype: float64 splits: - name: train num_bytes: 8897154920 num_examples: 1000000 download_size: 3281518568 dataset_size: 8897154920 configs: - config_name: default data_files: - split: train path: data/train-* ---
This dataset includes various features related to code files and GitHub repositories, such as file hash, size, extension, programming language, and information about the repositories with the highest stars, issues, and forks, including their event timestamps. The dataset also contains file content, average and maximum line lengths, and alphanumeric fraction. The dataset is split into a training set with 1 million examples, totaling 8.9GB in size.
数据集概述
数据集特征
- hexsha: 字符串类型
- size: 整数类型
- ext: 字符串类型
- lang: 字符串类型
- max_stars_repo_path: 字符串类型
- max_stars_repo_name: 字符串类型
- max_stars_repo_head_hexsha: 字符串类型
- max_stars_repo_licenses: 字符串序列类型
- max_stars_count: 整数类型
- max_stars_repo_stars_event_min_datetime: 字符串类型
- max_stars_repo_stars_event_max_datetime: 字符串类型
- max_issues_repo_path: 字符串类型
- max_issues_repo_name: 字符串类型
- max_issues_repo_head_hexsha: 字符串类型
- max_issues_repo_licenses: 字符串序列类型
- max_issues_count: 整数类型
- max_issues_repo_issues_event_min_datetime: 字符串类型
- max_issues_repo_issues_event_max_datetime: 字符串类型
- max_forks_repo_path: 字符串类型
- max_forks_repo_name: 字符串类型
- max_forks_repo_head_hexsha: 字符串类型
- max_forks_repo_licenses: 字符串序列类型
- max_forks_count: 整数类型
- max_forks_repo_forks_event_min_datetime: 字符串类型
- max_forks_repo_forks_event_max_datetime: 字符串类型
- content: 字符串类型
- avg_line_length: 浮点数类型
- max_line_length: 整数类型
- alphanum_fraction: 浮点数类型
数据集分割
- train:
- 字节数: 8897154920
- 示例数: 1000000
数据集大小
- 下载大小: 3281518568
- 数据集大小: 8897154920
配置
- config_name: default
- data_files:
- split: train
- path: data/train-*
- split: train
- data_files: