
遇见数据集

dh-unibe/towerbooks-line-test-test-with-inference

收藏
Hugging Face2026-06-11 更新2026-06-14 收录
官方服务:

资源简介:

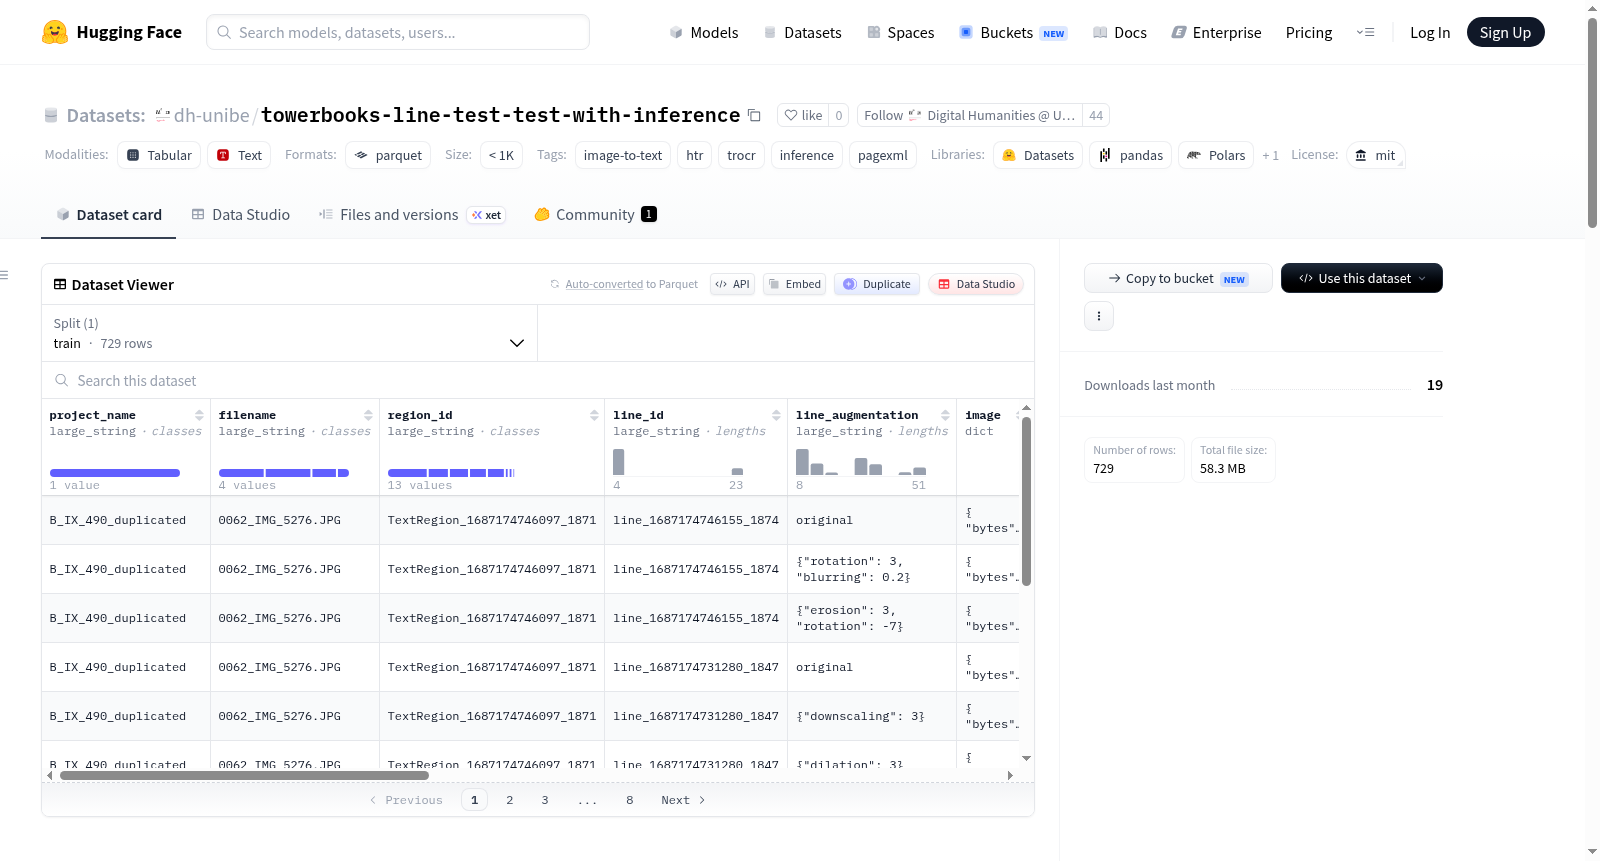
该数据集源自dh-unibe/towerbooks-line-test-test-with-inference,并已通过推理结果进行丰富。它包含729个样本,分布在1个分割(train)中,涉及项目B_IX_490_duplicated。数据集包括图像到文本的转换功能,用于手写文本识别(HTR)和TrOCR模型推理,特征包括项目名称、文件名、区域ID、行ID、图像数据、文本内容、行和区域的坐标、阅读顺序以及推理输出(如inference_20260611_163016_468653_model_dh-unibe_trocr-towerbooks)。评估结果显示字符错误率(CER)为0.1696,基于237行数据。数据以parquet分片格式组织,便于通过HuggingFace Hub加载。

This dataset is derived from dh-unibe/towerbooks-line-test-test-with-inference and has been enriched with inference results. It contains 729 samples across 1 split (train), with the included project B_IX_490_duplicated. The dataset supports image-to-text tasks for handwritten text recognition (HTR) and TrOCR model inference, featuring attributes such as project name, filename, region ID, line ID, image data, text content, line and region coordinates, reading order, and inference outputs (e.g., inference_20260611_163016_468653_model_dh-unibe_trocr-towerbooks). Evaluation results show a character error rate (CER) of 0.1696 based on 237 rows. Data is organized in parquet shards for easy loading via the HuggingFace Hub.
提供机构:
dh-unibe
搜集汇总
数据集介绍
dh-unibe/towerbooks-line-test-test-with-inference 数据集图片
构建方式
该数据集源自dh-unibe团队构建的towerbooks文献行级图像数据集,并在此基础上融入了基于TrOCR模型的手写文本识别推理结果。原始数据来源于历史文献项目B_IX_490_duplicated,经过PageXML格式标注,提取出文本行区域、基线坐标、阅读顺序等结构化信息。数据集以Parquet分片形式存储,按项目名称与数据分割组织在目录中,便于高效加载与管理。同时,数据集附带了完整的评估文件,包括真实文本、推理假设及评估报告,为后续性能分析提供了标准化参照。
特点
数据集共包含729个样本,所有样本均位于训练集中,总数据量约55.61 MB。每个样本保留了丰富的结构信息,如项目名、文件名、区域与行标识符、行增强方式、图像二进制数据、原始文本及行与区域的阅读顺序坐标等。特别地,数据集新增了一个推理结果列,记录基于dh-unibe/trocr-towerbooks模型在特定时间戳下的输出,且已计算字符错误率(CER)为0.1696,评估行数为237行,为研究者提供了可直接用于比较的基准性能指标。
使用方法
用户可通过HuggingFace的datasets库轻松加载该数据集,代码示例为`load_dataset("dh-unibe/towerbooks-line-test-test-with-inference")`,并可选择指定加载训练集分割。加载后,每个样本包含图像、文本标注与推理结果等多个字段,适用于图像到文本识别模型的训练、验证或推理分析。由于数据为Parquet格式,HuggingFace Hub会自动合并所有分片,用户无需额外处理即可获得完整数据集,便于快速开展手写文本识别或文档分析相关实验。
背景与挑战
背景概述
在手写文字识别(Handwritten Text Recognition, HTR)领域,历史文档的数字化与自动转录一直是学术界与文化遗产机构共同关注的焦点。塔楼图书(Tower Books)作为一类珍贵的历史手稿,其复杂的版面布局、多样的书写风格以及图像退化问题,对现有识别模型构成了严峻考验。由伯尔尼大学数字人文研究组(dh-unibe)创建的towerbooks-line-test-test-with-inference数据集,于2026年6月发布,专门针对塔楼图书中的行级文字识别任务。该数据集包含729个样本,来源于单一项目B_IX_490_duplicated,并集成了TrOCR模型的推理结果与字符错误率(CER)评估,旨在为历史手稿的行级转录提供标准化的测试基准,推动HTR技术在特定文献类型中的精细化发展。
当前挑战
该数据集所解决的领域问题集中体现在行级手写文字识别的精度提升上,特别是面对塔楼图书中非标准化的手写体、凌乱的基线及倾斜文本时,模型常因版面结构复杂而出现误识。当前挑战来自两个方面:一是领域问题层面,历史手稿的退化墨水、透印痕迹以及不规则的区域布局,导致现有OCR模型在缺乏足够上下文的情况下识别率低下,CER高达0.17;二是构建过程中,数据集的标注需从高分辨率PageXML格式图像中精确提取行坐标、基线与阅读顺序,工作繁琐且需领域专家反复校验,以确保text特征与视觉特征的严格对齐,同时推理结果需动态更新以追踪模型改进效果。
常用场景
经典使用场景
作为文档分析与识别领域的一项标杆性资源,该数据集聚焦于历史手写文本行级别的识别任务,其核心价值在于为光学字符识别(OCR)与手写文本识别(HTR)模型提供经过精细标注的文本行图像及对应的转录文本。每一份样本均包含来自塔楼图书项目的完整元数据,包括行坐标、区域类型及基线信息,使得研究者能够精准定位并切割出高保真度的文本行单元。经典使用场景涵盖基于TrOCR等端到端模型的训练与评估,通过比对模型推理输出与人工标注,系统性地衡量字符错误率(CER)等关键指标,从而推动历史文档数字化中文字转录精度的持续提升。
衍生相关工作
围绕这一数据集的衍生工作已在多个维度展开,形成了一条富有生命力的研究脉络。其一,基于其提供的推理结果与基线标注,研究者开发了针对历史文档的文本行对齐与验证工具,有效解决了多视图条件下转录一致性不足的顽疾。其二,该数据集作为TrOCR模型在古籍领域迁移学习的策源地,催生了多个面向特定字体库或语言变体的微调检查点,显著降低了在小型语料上从头训练所需的数据成本。其三,以本数据集为基础发布的评估报告格式与CER计算流程,已被后续诸多历史文档识别工作采纳为评测模板,从而促成了标准化比较体系在学术社区内的共识与推广。
数据集最近研究
最新研究方向
该数据集聚焦于历史手写文本识别(HTR)的前沿验证,通过将TrOCR模型推理结果纳入标注体系,探究端到端图像到文本转换在古籍数字化中的效能。其核心研究方向在于评估大规模预训练视觉-语言模型在特定领域(如塔楼书籍)手写行级转录的泛化能力,特别是通过CER指标量化推理误差,并结合PageXML结构化标注分析空间布局与文本内容的关联性。此外,数据集中纳入的推理时间戳与结果比对,为模型迭代与基准测试提供了动态演进的参照系,呼应了当前数字人文学科中持续集成与增量学习的趋势。这一工作对文化遗产保护中高效、可复现的自动化转录流程具有推动作用,亦为跨语种、多样式历史文献的智能处理奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

