WavCaps, LibriTTS-R, AudioSet-speech
收藏资源简介:
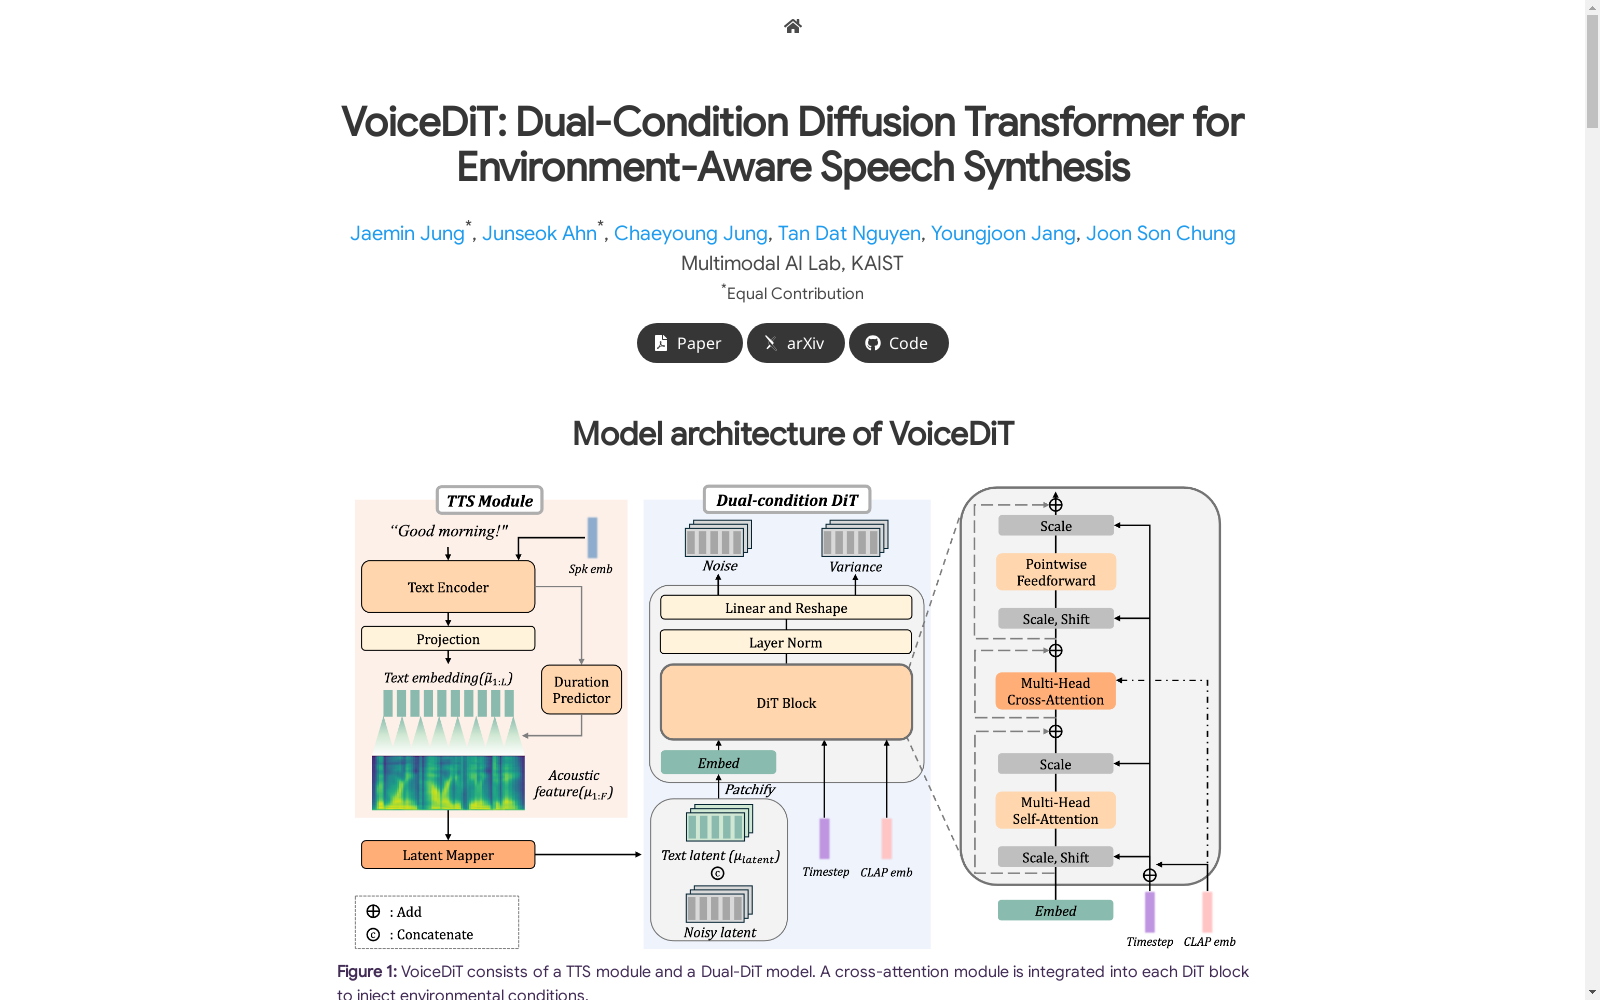
VoiceDiT研究团队构建了一个多模态生成模型,用于从文本和视觉提示中生成环境感知的语音和音频。数据集包括WavCaps、LibriTTS-R和AudioSet-speech,分别用于预训练和微调。WavCaps包含340K条非语音数据,LibriTTS-R是一个多说话者语料库,AudioSet-speech是一个真实世界的语音数据集,经过处理后包含400K条数据。数据集的创建过程包括将干净语音与噪声数据混合,并应用房间脉冲响应滤波器以模拟各种环境条件。该数据集的应用领域主要集中在文本到语音和文本到音频的生成,旨在解决在嘈杂条件下生成环境感知语音的挑战。
The VoiceDiT research team developed a multimodal generative model for generating environment-aware speech and audio from text and visual prompts. The dataset comprises WavCaps, LibriTTS-R, and AudioSet-speech, which are respectively used for pre-training and fine-tuning. WavCaps contains 340K non-speech samples; LibriTTS-R is a multi-speaker corpus, and AudioSet-speech is a real-world speech dataset processed to include 400K samples. The dataset creation process involves mixing clean speech with noise data and applying room impulse response filters to simulate various environmental conditions. The application scenarios of this dataset mainly focus on text-to-speech and text-to-audio generation, aiming to address the challenge of generating environment-aware speech under noisy conditions.