
DeepPavlov/coqa_abg_fr
收藏官方服务:
资源简介:
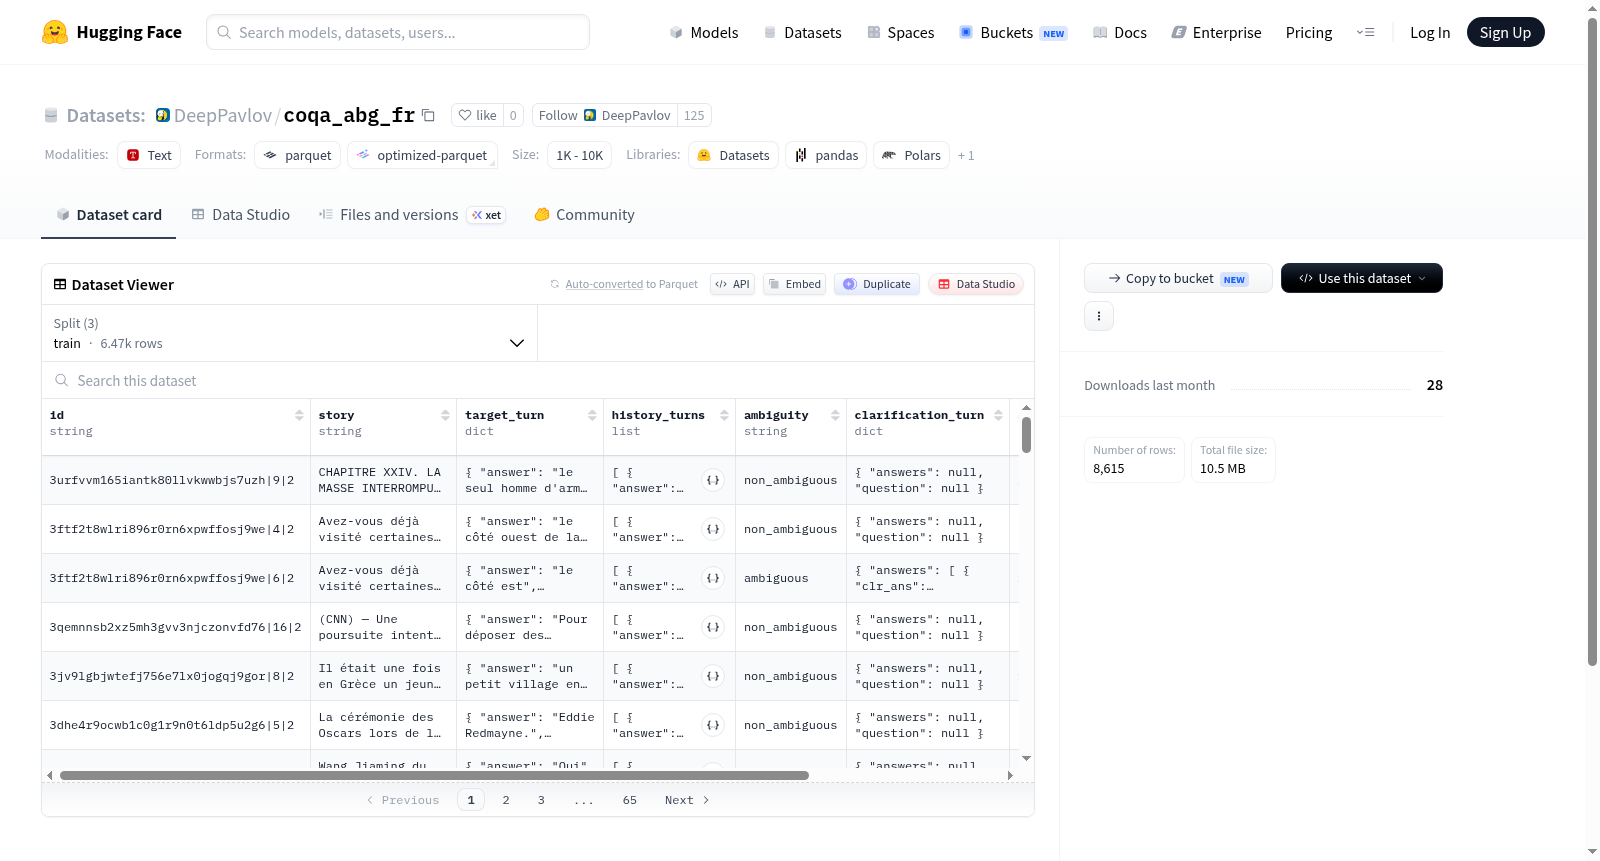
这是一个法语翻译的数据集,由`data-translate upload-datasets`工具导出。数据集名称coqa_abg_fr表明它可能源自CoQA(对话式问答)数据集,并经过翻译处理,适用于法语自然语言处理任务。
French translated dataset exported by `data-translate upload-datasets`.
提供机构:
DeepPavlov搜集汇总
数据集介绍
构建方式
该数据集源自英文版CoQA(Conversational Question Answering)的精心翻译与本地化处理。具体而言,它由DeepPavlov团队借助自动化翻译工具与人工校验流程,将原始CoQA语料库中的对话式问答对系统性地转换为法语,从而构建起一个面向法语场景的高质量问答数据集。构建过程中,数据被划分为训练、验证与测试三个标准子集,分别存储于`data/train-*`、`data/val-*`与`data/test-*`路径下,以便于后续的模型训练与评估。
特点
coqa_abg_fr数据集继承了CoQA的对话式问答架构,包含多轮交互中的问题、答案及其上下文段落,特别强调对话的连贯性与推理能力。其核心特色在于法语本地化,为多语言自然语言处理研究提供了稀缺的对话型问答资源。此外,数据集规模适中且划分明确,既可用于微调法语对话系统,也可作为评估模型跨语言迁移表现的基准,兼具学术价值与应用潜力。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库进行加载,指定配置名为`default`并访问相应的数据分片。训练阶段可利用`train`分片进行模型微调,而`val`与`test`分片分别用于超参数调优与性能评估。建议将数据预处理器适配为法语文本处理流程,并采用序列化对话历史作为输入,以保留多轮交互的上下文信息,从而充分发挥该数据集在对话问答任务中的效能。
背景与挑战
背景概述
CoQA(Conversational Question Answering)数据集是对话式问答领域的重要基准,由斯坦福大学等机构于2018年创建,旨在推动机器理解多轮对话中的上下文推理能力。其核心研究问题聚焦于如何让模型在自然对话中连贯地回答问题,而非孤立的单轮交互。coqa_abg_fr作为其法语翻译版本,由DeepPavlov团队通过自动化翻译流水线导出,填补了非英语对话问答数据的空白,促进了多语言对话系统的发展。该数据集在跨语言自然语言处理领域具有显著影响力,为评估模型在法语语境下的对话理解与生成能力提供了标准化测试平台。
当前挑战
coqa_abg_fr所解决的领域挑战主要在于跨语言对话式问答的迁移学习,即如何将英语对话数据的推理模式有效适配到法语中,克服语言差异导致的语义偏移。构建过程中,机器翻译的准确性成为核心难题,自动翻译可能引入语法错误、习语误解或上下文连贯性丢失,需通过后处理校正以确保问答对的合理性。此外,法语的文化特定表达和语用习惯(如敬语使用)增加了对齐难度,需平衡忠实翻译与自然对话流畅性,避免数据噪声对模型训练的负面影响。
常用场景
经典使用场景
coqa_abg_fr数据集作为CoQA(对话问答)数据集的法语翻译版本,经典使用场景集中于跨语言对话式阅读理解任务。研究者可借助该数据集,在法语语境下训练和评估模型对多轮对话中上下文依赖问题的理解能力,尤其适用于检测模型在非英语环境下的语义连贯性和指代消解能力。通过该数据集,可以探索对话历史与当前问题的交互逻辑,推动多语言对话系统的鲁棒性发展。
解决学术问题
该数据集有效解决了法语对话问答领域标注资源匮乏的学术难题。传统的CoQA数据集仅覆盖英语,限制了多语言自然语言处理研究的广度。coqa_abg_fr通过高质量翻译,填补了法语对话理解基准的空白,使研究者能够系统评估模型在语法结构差异、文化特定表达及代词回指等法语语言现象上的表现。这一贡献提升了对话系统在多语言场景下的迁移学习效果,并为跨语言知识蒸馏方法提供了可信的验证基础。
衍生相关工作
coqa_abg_fr的推出衍生了一系列跨语言对话理解的前沿工作。基于该数据集,研究者提出了法语专用的预训练语言模型微调策略,如CamemBERT与FlauBERT在对话问答任务上的适配方法。同时,该数据集推动了多任务联合训练框架的研究,例如将法语对话QA与翻译任务结合,提升模型在低资源语言上的泛化能力。此外,部分工作利用该数据集的对话结构特性,探索了图神经网络在长程依赖建模中的应用,进一步丰富了对话系统领域的技术生态。
以上内容由遇见数据集搜集并总结生成


