
ivanleomk/rag-eval-ms-marco
收藏官方服务:
资源简介:
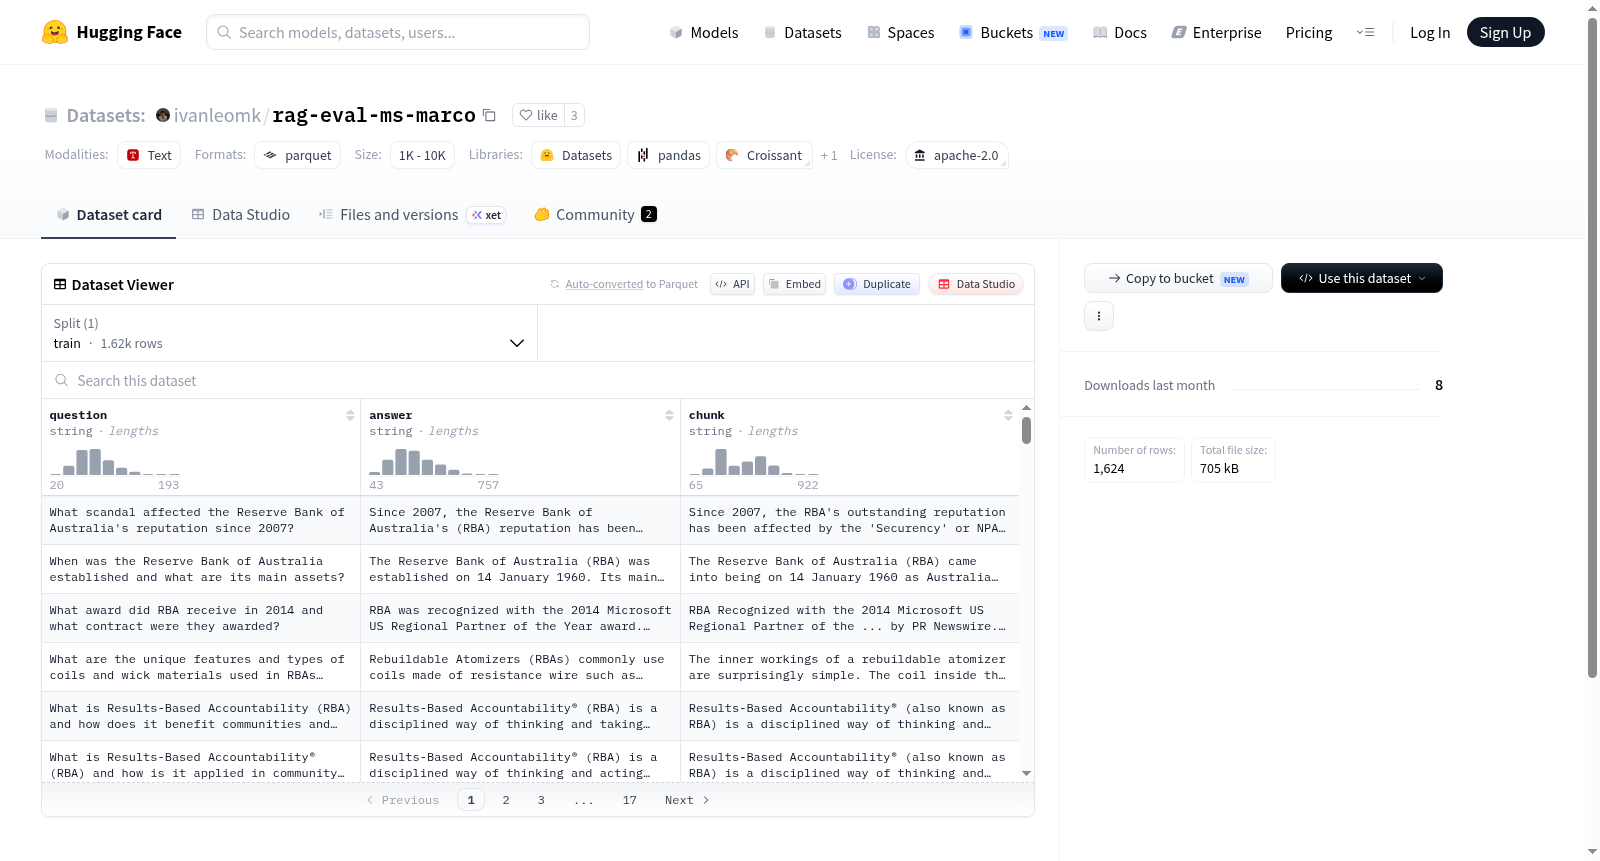
这个数据集包含约1600个简单查询,这些查询是从ms-marco数据集的前100多个问题生成的。它适用于RAG评估时比较不同实现。
This is a dataset containing ~1600 simple queries that were generated from the first 100+ questions in the ms-marco dataset. Its useful for some RAG evaluations when youd like to compare between different implementations.
提供机构:
ivanleomk原始信息汇总
数据集概述
数据集信息
- 许可证: Apache 2.0
- 特征:
question: 类型为字符串answer: 类型为字符串chunk: 类型为字符串
- 分割:
train: 包含1624个样本,占用1302205字节
- 下载大小: 701995字节
- 数据集大小: 1302205字节
配置
- 配置名称: default
- 数据文件:
train: 路径为data/train-*
数据集描述
- 包含约1600个简单查询,源自ms-marco数据集的前100多个问题。
- 适用于RAG评估,用于比较不同实现的效果。
搜集汇总
数据集介绍
构建方式
该数据集源自MS MARCO语料库中前100余个问题,通过选取其中的简单查询进行构建,最终生成了约1600条样本。每条样本包含三个核心字段:用户提出的原始问题(question)、对应的标准答案(answer)以及相关的文本片段(chunk)。数据以单一训练集(train)形式组织,采用Apache-2.0开源协议发布,便于研究社区直接使用。
使用方法
用户可直接通过HuggingFace Datasets库加载该数据集,指定配置名为'default'并读取训练集。在RAG评估流程中,可将question字段作为检索输入,利用chunk字段验证检索模块的召回质量,并以answer字段作为生成答案的参照标准。数据集支持与主流框架(如LangChain、Haystack)集成,便于开展模块化对比实验。
背景与挑战
背景概述
在信息检索与自然语言处理领域,检索增强生成(RAG)技术已成为提升大语言模型回答准确性与时效性的关键范式。该数据集由研究者ivanleomk于近期创建,基于经典的MS MARCO数据集,从其中前100余个问题中精心提取并生成了约1600条简洁查询。核心研究问题聚焦于如何构建一个适用于RAG系统评估的高质量基准,以衡量不同检索与生成实现方案之间的性能差异。通过对原始MS MARCO数据进行针对性的筛选与重构,该数据集为RAG领域提供了一个轻量级但具有代表性的评测工具,有助于推动相关技术在实际应用中的比较与优化。
当前挑战
当前数据集面临的核心挑战首先体现在领域问题层面:RAG系统的评估需要同时兼顾检索模块的相关性与生成模块的准确性,而现有数据集往往仅关注单一维度,难以全面反映端到端系统的真实表现。其次,在构建过程中,从MS MARCO原始数据中提取并生成简洁查询时,如何确保问题覆盖的多样性、避免语义偏差、以及保持与原始语料的一致性,均为技术难点。此外,数据集规模较小(仅约1600条样本),可能不足以支撑对复杂RAG系统的鲁棒性评估,存在过拟合风险。最后,缺乏多语言、多领域扩展,限制了其在更广泛场景下的适用性。
常用场景
经典使用场景
在检索增强生成(Retrieval-Augmented Generation, RAG)领域,该数据集作为一项精巧的评估基准,被广泛用于对比不同RAG实现方案在信息检索与答案生成上的协同表现。其核心价值在于,通过对MS MARCO数据集前100余条原始问题进行精细化的查询衍生,生成了约1600条简单查询,从而为研究者提供了一个高度可控且可复现的测试平台。经典使用场景聚焦于评估检索器(retriever)与生成器(generator)之间的耦合效率,例如衡量检索模块召回的相关文本块是否能够有效支撑生成模块输出精准、连贯的答案,进而揭示不同架构或超参数配置下的性能差异。
解决学术问题
该数据集直击RAG系统评估中的核心学术难题:缺乏标准化的、规模适中的评测基准来统一衡量检索与生成两个环节的联合效果。传统评估往往割裂地处理检索精度(如MRR、NDCG)或生成质量(如BLEU、ROUGE),却难以反映两者在端到端流水线中的交互影响。该数据集通过提供结构化的三元组(问题、答案、文本块),使得研究者能够系统地探究检索噪声对生成忠实性的干扰、查询改写策略对检索召回率的提升,以及不同分块粒度对最终答案准确度的调节作用。其意义在于推动了RAG评估从碎片化走向统一化,为后续更复杂的多跳推理或知识密集型任务评估奠定了方法论基础。
实际应用
在实际工业场景中,该数据集常被用于快速迭代和验证RAG系统的工程化实现,例如在智能客服、企业知识库问答或文档辅助写作等应用中,开发者可借助该数据集对比不同向量数据库(如FAISS、Pinecone)与语言模型(如GPT系列、LLaMA)组合下的响应延迟与准确率。此外,它还可作为A/B测试的基准,帮助团队在部署前评估分块策略(如固定长度分块与语义分块)对用户体验的实际影响,从而在成本与性能之间找到最优平衡点。其轻量级特性(仅约1600条样本)使得模型调优和配置探索能够高效完成,显著缩短了从研究到落地的周期。
数据集最近研究
最新研究方向
该数据集基于MS MARCO语料库的前100余个问题,通过自动生成约1600条简洁查询,构建了一个轻量级的检索增强生成(RAG)评估基准。当前研究前沿聚焦于利用此类精炼数据集对比不同RAG实现方案在信息检索与答案生成阶段的性能差异,例如评估嵌入模型、检索策略及生成模块的协同效果。该数据集的出现呼应了RAG技术在实际应用中对高效、可复现评估工具的需求,尤其在问答系统、智能客服等场景中,为优化信息整合与响应质量提供了标准化测试平台。其影响在于推动RAG领域从理论验证向工程实践过渡,加速了模块化评估流程的建立,对提升大语言模型在知识密集型任务中的可靠性具有显著意义。
以上内容由遇见数据集搜集并总结生成


