
遇见数据集

saraNour/retailer-market-intelligence

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

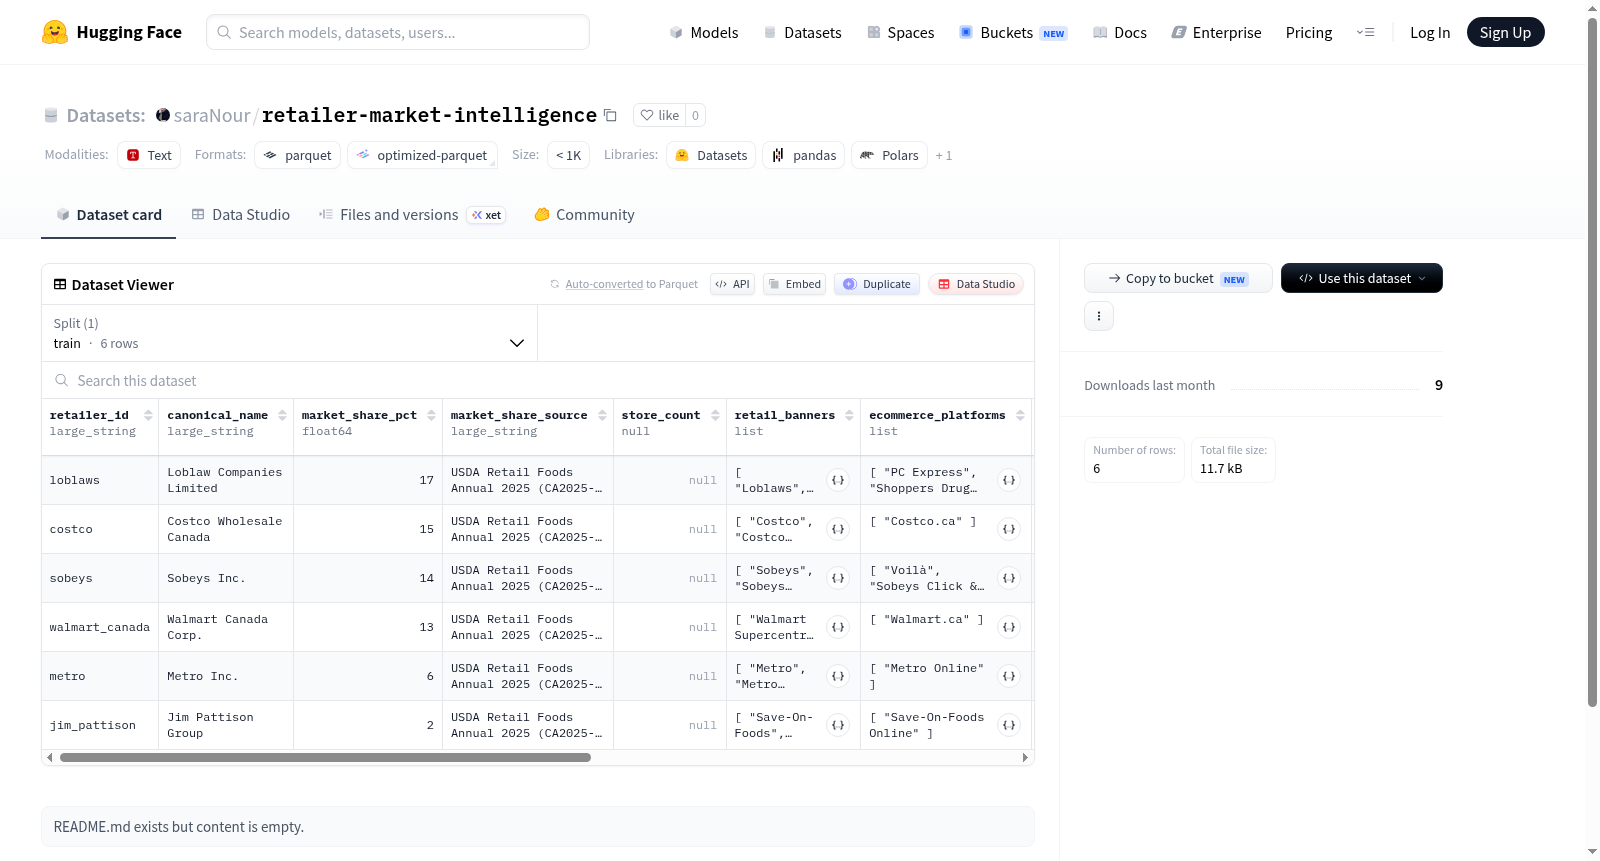
该数据集包含零售市场相关信息,涵盖6个示例,每个示例包含以下特征:零售商ID(唯一标识符)、规范名称(零售商标准名称)、市场份额百分比(浮点数表示)、市场份额来源(字符串描述)、店铺数量(当前为null值)、零售横幅(字符串列表)、电商平台(字符串列表)、地区(字符串列表)、自有品牌(字符串列表)、来源URL(数据提取网页链接)和提取日期(字符串格式)。数据集用于分析零售市场结构、竞争格局和区域分布,适用于市场研究、商业智能和数据分析应用。

This dataset contains retail market-related information, comprising 6 examples, each with the following features: retailer_id (unique identifier), canonical_name (standard retailer name), market_share_pct (float representation), market_share_source (string description), store_count (currently null), retail_banners (list of strings), ecommerce_platforms (list of strings), regions (list of strings), private_labels (list of strings), source_url (web link for data extraction), and extraction_date (string format). The dataset is designed for analyzing retail market structure, competitive landscape, and regional distribution, suitable for market research, business intelligence, and data analytics applications.
提供机构:
saraNour
搜集汇总
数据集介绍
saraNour/retailer-market-intelligence 数据集图片
构建方式
零售市场情报数据集(retailer-market-intelligence)聚焦于零售商在市场中竞争地位的量化表征。该数据集通过系统化的信息采集与整合流程构建,从多元公开来源抓取零售商的核心经营指标,涵盖市场占有率、店铺数量、零售品牌矩阵、电商平台布局、区域覆盖网络及自有品牌组合等维度。每条记录均标注数据来源与提取时间,确保信息的可追溯性与时效性。数据集以结构化表格形式存储,包含6个训练样本,字段类型兼顾字符串与浮点数,其中零售品牌与电商平台等复杂属性以列表形式呈现,便于多维分析。
使用方法
研究者可直接通过HuggingFace数据集加载工具调用该资源,使用`load_dataset`函数指定数据集名称即可获取默认配置下的训练分割数据。加载后的数据以Pandas兼容的DataFrame格式呈现,所有字段均可直接索引访问。针对列表型字段(如零售品牌、电商平台),可借助Python的列表操作或Pandas的`explode`方法进行展开分析。建议结合市场占有率数据与区域信息,进行地理维度下的竞争强度量化分析,或利用零售品牌矩阵进行零售商战略聚类。数据量轻量(约3KB),适合快速原型开发与教学演示。
背景与挑战
背景概述
在零售行业数字化转型的浪潮中,市场情报的精准获取与分析成为企业制定战略的关键。该数据集名为retailer-market-intelligence,由研究人员或机构于近期构建,旨在系统性地整合零售商的多元属性信息。其核心研究问题在于如何通过结构化的数据描述零售商的竞争格局,涵盖市场份额、门店数量、品牌矩阵、电商平台布局及区域分布等维度。尽管数据集规模较小(仅包含6个样本),但它为零售市场深度分析提供了标准化框架,尤其对中小型市场洞察和竞品研究具有参考价值。该数据集的发布有望填补零售智能领域公开结构化数据的空白,推动相关实证研究的开展。
当前挑战
数据集所解决的领域问题在于零售市场情报的碎片化与非标准化挑战。当前零售数据分散于不同来源(如财报、行业报告),缺乏统一标识与可比性,该数据集通过定义零售商唯一标识、市场份额来源及品牌层级等字段,尝试构建统一的数据模型。然而,构建过程中面临多重挑战:首先,市场份额数据来源多样(如财报、第三方调研),其准确性与时效性难以保证;其次,零售商的门店数量字段存在空值,反映出数据收集的完整性不足;再者,零售品牌、电商平台与区域信息的标准化处理需要耗费大量人力校验。此外,数据集当前仅有6个样本,代表性有限,难以支撑大规模统计推断,未来需扩展样本量与数据来源以提升泛化能力。
常用场景
经典使用场景
在零售市场分析的学术疆域中,retailer-market-intelligence数据集犹如一柄精巧的解剖刀,为研究者揭示零售商市场份额、门店网络、电商布局及自有品牌矩阵的立体图景。其经典使用场景聚焦于零售竞争格局的量化建模,通过整合多源零售数据,精准刻画零售商的市场势力分配与扩张策略。研究者可借此构建跨区域市场集中度指标,剖析零售业态演化中的霸权更迭,或量化线上线下渠道对冲的商务逻辑。该数据集以结构化字段串联零售商的实体触角与数字踪迹,成为解构新零售时代商业生态的基准工具。
解决学术问题
此数据集解决了零售管理领域长期悬而未决的数据碎片化难题——以往市场份额、门店分布与电商渗透率等关键变量散落于不同信源,难以实现跨维度的系统化比较。它驱动学者深入探究零售商的规模经济阈值与市场支配力传导机制,揭示区域异质性如何调节零售扩张的边际收益。通过解析自有品牌占比与电商平台选择之间的隐性关联,数据集为零售组织的纵向整合策略提供了实证锚点。其意义在于消弭了产业组织理论与营销科学之间的数据鸿沟,使学派纷争归于量化验证的澄明之境。
实际应用
在商业智能的实战场域,该数据集可赋能零售企业进行竞争态势的动态监测与战略对标。零售经理可用其绘制市场份额的迭代曲线,识别业态创新与门店效能衰减的临界点;投资机构依托多期数据构建零售商价值评估模型,精准预判并购目标的市场协同潜力。电商平台亦可借力此数据优化商户生态治理,通过解析头部零售商的渠道迁徙轨迹,调整持仓策略与招商倾斜度。从品类目录优化到仓储网络选址,该数据集为零售决策提供了从宏观格局到微观博弈的多层指引。
数据集最近研究
最新研究方向
零售业市场情报数据集正成为商业智能与竞争分析领域的研究热点,其核心价值在于系统整合零售商的市场份额、门店网络、电商布局及自有品牌等多元异构信息。当前前沿研究方向聚焦于利用此类结构化数据构建动态竞争图谱,结合自然语言处理技术从非结构化来源中挖掘零售商战略动向,并通过时序分析揭示市场格局演变规律。此外,该数据集在反垄断监管背景下的应用备受关注,为量化评估零售巨头市场势力、识别隐形市场集中度提供了数据根基,推动着从理论建模到政策制定的知识迁移。其多维度、跨区域的特性也为零售业态演化与消费行为的基础研究注入了实证活力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

