
遇见数据集

JingweiNi/ocr2_k2_medium_sample500_qwen35_fp8_step1k_seed20260527

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

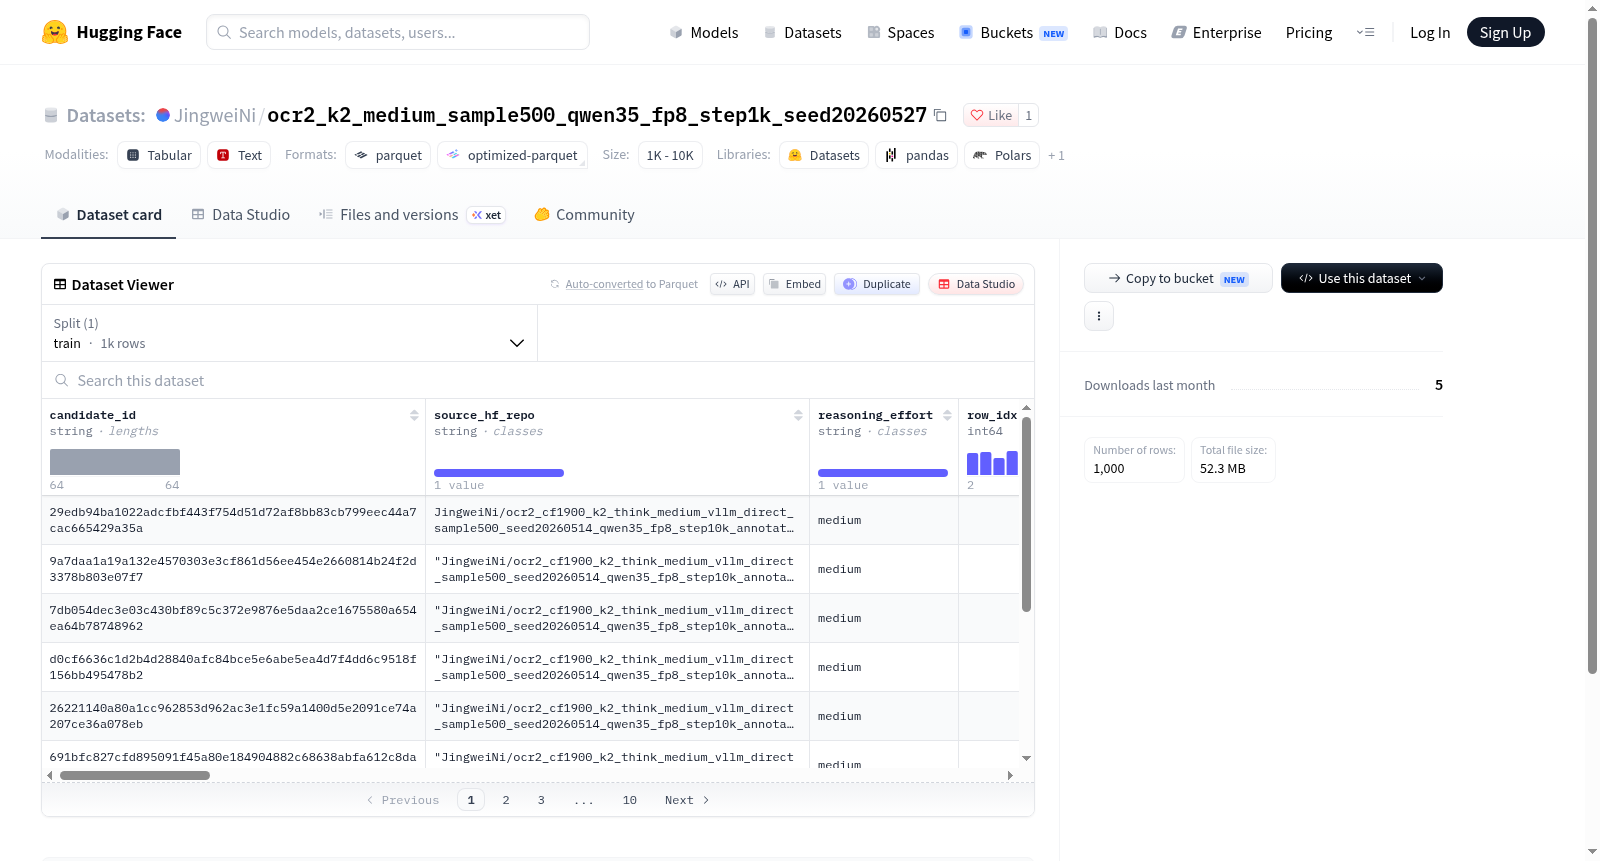
该数据集是一个包含多步骤推理和验证任务的数据集,主要用于问题回答和推理过程分析。它包含1000个训练示例,每个示例具有多个特征字段,如候选ID、问题、答案、回复、推理努力程度、验证状态、错误标识、步骤位置信息等。数据来源于多个平台和数据集,支持多语言分割,并可能用于评估模型在复杂推理任务中的性能。特征如prior_steps、steps_so_far、latest_step表明涉及序列推理步骤,而claim_sentence、claim_text、aligned_token_ids可能用于文本对齐或验证。

This dataset is a multi-step reasoning and verification task dataset, primarily used for question answering and reasoning process analysis. It contains 1000 training examples, each with multiple feature fields such as candidate_id, question, answer, reply, reasoning_effort, verified, is_error, step position information, etc. The data is sourced from multiple platforms and datasets, supports multilingual splits, and may be used to evaluate model performance in complex reasoning tasks. Features like prior_steps, steps_so_far, latest_step indicate sequential reasoning steps, while claim_sentence, claim_text, aligned_token_ids may be used for text alignment or verification.
提供机构:
JingweiNi
搜集汇总
数据集介绍
JingweiNi/ocr2_k2_medium_sample500_qwen35_fp8_step1k_seed20260527 数据集图片
构建方式
该数据集面向光学字符识别与多步推理的交叉场景,以OCR2基准为基础进行结构化采样与扩增。构建流程从筛选真实视觉文档问答样本出发,借助Qwen系列模型以FP8精度执行千步推理轨迹生成,并采用固定随机种子控制采样过程。每条样本被切分为步骤单元,保留候选标识、来源仓库、推理努力程度及逐步累积的文本上下文,同时记录对齐的token标识、验证分数与错误标记。借助步骤位置与分位信息,样本能够在不同推理阶段被精确定位,从而形成兼具轨迹连续性与阶段可比性的中等规模评测集合。
特点
该数据集的核心特质在于对推理步骤的细粒度追踪与多维标注。字段涵盖问题、答案、回复、先验步骤、最新步骤及声明文本,可支持对推理链中局部断言与全局结论之间关系的考察。验证分数与错误标志提供质量信号,步骤相对位置、有效步骤计数与分位划分则赋予样本阶段感知能力。来源平台、难度、判定结果与通过率等元信息进一步扩展了分析维度,使其既能服务于步骤级错误诊断,也可用于模型推理稳健性评估。数据规模为千条训练样本,兼顾了可操作性与多样性。
使用方法
使用时可依据候选标识或问题标识检索单条轨迹,并利用步骤索引重建完整推理链。研究者可将prior_steps与latest_step拼接作为条件输入,以answer或reply作为监督目标开展步骤级训练;也可借助verified与is_error字段筛选高质量或含错样本,用于对比分析。aligned_token_ids支持与分词器对齐后的细粒度建模,而step_relative_position与step_position_decile适合划分推理前期、中期与后期阶段。该数据集可直接通过HuggingFace数据集接口加载,按默认配置读取train划分,并依据语言、平台与难度等字段进行分层实验设计。
背景与挑战
背景概述
面向开放域复杂推理的评测需求催生了OCR2系列数据集,该数据集由研究团队于2026年构建,包含500个问题、1000条逐步推理样本,字段涵盖问题、答案、推理步骤、对齐token及人工验证标签。核心研究问题在于检验大语言模型在光学字符识别与多步推理耦合场景下的忠实性与错误传播机制,通过细粒度步骤级标注和验证分数,为推理链可靠性评估提供了可复用的基准资源,对多模态推理与可信AI领域具有方法学参考价值。
当前挑战
该数据集所应对的领域问题在于:如何在缺乏显式符号监督的情况下,判定模型推理链中每一步的忠实性并定位错误步骤,这与图像分类等单步判别任务存在本质差异。构建过程中面临的挑战包括:从原始OCR2语料中筛选高质量问题、对齐模型生成token与人工标注的推理步骤、设计可复现的验证阈值以区分合理推理与事后合理化,以及控制语言与难度分布以避免评测偏差,这些因素共同影响了数据集的覆盖范围与标注一致性。
常用场景
经典使用场景
在大型语言模型推理链的细粒度可信度评估领域,该数据集构成了一类典型的逐步验证资源。其经典使用场景集中于对模型生成的多步推理轨迹进行中间步骤级别的标注与校验,通过question、answer、reply及prior_steps、steps_so_far、latest_step等字段的协同组织,研究者能够以claim_sentence与claim_text为锚点,定位推理链中具体声明的对齐token,并借助verified与is_error标签判定每一步的可靠程度。此类场景常见于过程奖励建模与推理链错误溯源研究,为逐步级监督信号的提取提供了标准化结构。
实际应用
在需要高可信推理输出的现实系统中,该数据集展现出明确的应用价值。智能问答、教育辅导、代码生成与科学推理助手等场景,均要求模型不仅给出答案,还需保证中间推导的可验证性。该数据集通过judgement、pass_rate、difficulty与source_platform等元信息,支持对模型在不同难度与平台来源问题上的逐步表现进行分层评估,亦可服务于拒绝采样、步骤级重排序与推理链过滤等工程环节,从而在部署阶段降低错误推理被采纳的风险,提升系统输出的整体可靠性。
衍生相关工作
围绕该数据集,已衍生出一系列与过程监督及推理验证相关的研究工作。其逐步标注结构可支撑过程奖励模型与验证器训练,催生了面向推理链的步骤级分类与错误检测方法;aligned_token_ids与claim_text等字段则便于开展声明与模型内部表征的对齐分析,推动可解释性研究;而problem_source_dataset、question_id、ocr2_id与sample_seed等溯源标识,使得跨数据集、跨模型的对比实验与可复现评测成为可能。这些衍生工作共同拓展了推理链可信度评估的方法论边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

