
遇见数据集

electricsheepeurope/europe-ilo-emp-2emp-sex-age-nb-employment-by-sex-and-age-ilo-modelled-estimates-n

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

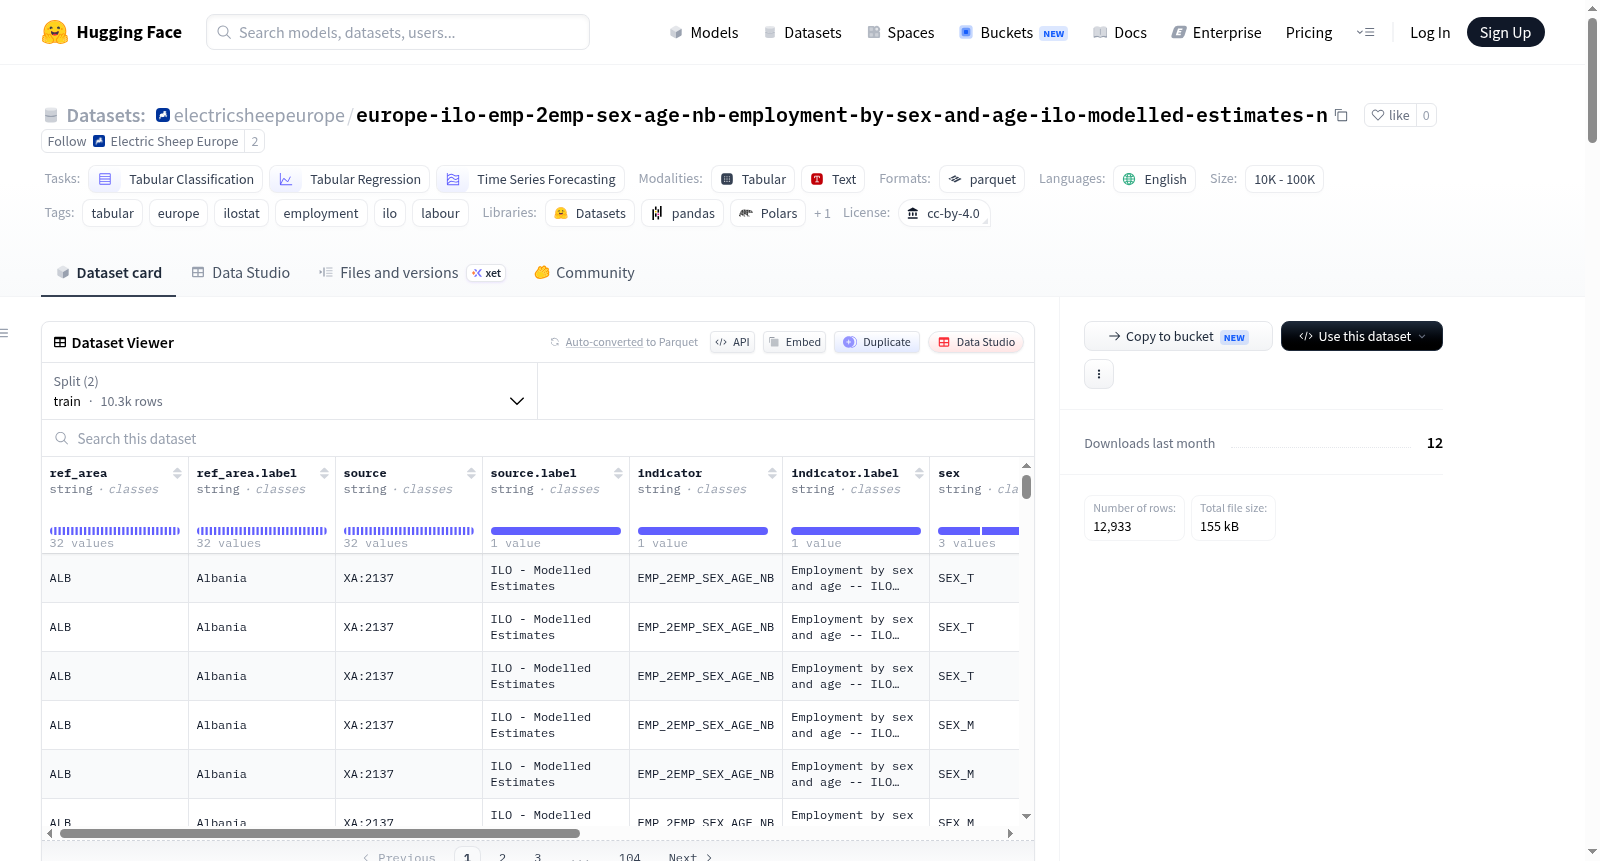
这是一个欧洲就业数据集,包含按性别和年龄划分的就业估计数据,由国际劳工组织(ILO)建模,数据单位为千。数据集涵盖39个欧洲国家,时间跨度为1991年至2027年,包含12,933个观测值和1个主要指标(EMP_2EMP_SEX_AGE_NB)。数据来源于ILOSTAT数据库,经过标准化处理,适用于表格分类、回归和时间序列预测等任务。字段包括国家代码、指标、性别分类、年龄分类、年份和观测值等。

This is a European employment dataset containing modeled estimates of employment by sex and age, produced by the International Labour Organization (ILO), with data in thousands. It covers 39 European countries from 1991 to 2027, with 12,933 observations and one main indicator (EMP_2EMP_SEX_AGE_NB). The data is sourced from the ILOSTAT database, harmonized for consistency, and suitable for tabular classification, regression, and time-series forecasting tasks. Fields include country codes, indicators, sex and age classifications, year, and observed values.
提供机构:
electricsheepeurope
搜集汇总
数据集介绍
electricsheepeurope/europe-ilo-emp-2emp-sex-age-nb-employment-by-sex-and-age-ilo-modelled-estimates-n 数据集图片
构建方式
本数据集源自国际劳工组织(ILO)的ILOSTAT核心统计数据库,通过REST API接口直接抽取原始指标数据,并依据欧洲ISO3国家代码进行过滤筛选。ILOSTAT依据国际劳工统计学家会议(ICLS)定义对原始调查微观数据进行标准化处理,确保数据的一致性与可比性。随后由Electric Sheep Europe团队将数据重新整理并封装为Parquet格式,以HuggingFace数据集形式发布,从而为欧洲劳动就业研究提供可直接调用的机器学习就绪数据层。
特点
该数据集汇集了1991年至2027年间39个欧洲国家的12,933条就业观测记录,覆盖唯一指标——按性别与年龄分层的就业人数(ILO模型估计值,单位:千人)。数据维度丰富,包含国家代码、数据来源、指标编码、性别分层(总数、男性、女性)及年龄分类等多重属性列,便于用户进行多维度交叉分析。数据集采用CC-BY-4.0许可协议发布,兼具权威性与开放性,是欧洲劳动力市场时间序列分析的宝贵资源。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,使用`load_dataset('electricsheepeurope/europe-ilo-emp-2emp-sex-age-nb-employment-by-sex-and-age-ilo-modelled-estimates-n')`命令快速获取数据并转换为Pandas DataFrame。后续可依据国家代码过滤特定国家数据,按时间序列绘制就业变化趋势图,或进行国家×年份的数据透视表分析,从而灵活支持分类、回归及时序预测等机器学习任务。
背景与挑战
背景概述
该数据集由国际劳工组织(ILO)统计部门于2025年11月发布,并由Electric Sheep Europe团队重新整理封装,涵盖1991年至2027年间39个欧洲国家的就业数据,包含12,933条观测记录。作为ILOSTAT全球劳动力统计数据库的核心组成部分,该数据集聚焦于按性别和年龄分层的就业人口估算,旨在为欧洲地区的劳动力市场分析、政策评估及跨国比较研究提供标准化、高质量的数据基础。凭借其官方权威来源、长时间跨度和统一的分层维度,该数据集在劳动经济学、人口统计学及可持续发展目标监测等领域具有广泛的应用价值,尤其为时间序列预测、分类和回归等机器学习任务提供了可靠的数据支撑。
当前挑战
该数据集面临的核心挑战首先在于劳动力统计领域的固有复杂性,包括各国调查定义、抽样方法和数据收集周期的差异,ILO虽通过国际劳工统计学家会议(ICLS)标准进行统一协调,但模型估算本身不可避免地引入不确定性和误差。其次,数据集构建过程中面临多重技术挑战:需从ILOSTAT REST API中高效提取并过滤欧洲国家数据,处理多源数据融合时的指标一致性问题,以及在年频数据基础上处理缺失值、多重来源竞争和分层变量的非完整性问题。此外,数据覆盖时间跨度长达37年,其中包含未来预测值(至2027年),模型预测的准确性和外推的可靠性构成持续挑战。
常用场景
经典使用场景
该数据集汇集了国际劳工组织(ILO)对欧洲39个国家1991年至2027年间按性别和年龄分层的就业人数建模估计值,总计包含12,933条观测记录,覆盖了一个核心指标。作为劳动力统计领域的高质量数据资源,它常被用于跨国家、跨时间维度的就业趋势分析,以及性别与年龄结构对劳动力市场影响的定量研究。研究人员通过加载该数据集,能够迅速构建包含国家、年份、性别和年龄组的结构化面板数据,进而开展回归分析、时序建模或分类任务。其标准化格式与元数据设计,使得与国家统计局的官方数据、经济合作与发展组织(OECD)的劳动力指标、世界银行的就业率数据等进行无缝对接成为可能,为跨国比较研究提供了坚实的数据基础。
实际应用
在实际应用层面,该数据集为政策制定者、国际组织和研究机构提供了关键的决策支持工具。欧盟委员会、国家劳动部门以及国际劳工组织自身可借助这些估计值,监测各国就业目标的实现进展,评估就业促进政策的有效性,并制定针对弱势群体(如青年、女性、高龄劳动者)的精准干预措施。例如,通过分析按性别和年龄分列的数据,政策制定者能够识别就业参与率偏低的特定人群,并据此设计定制化的职业培训和就业服务方案。金融机构与经济智库也可利用该数据集构建宏观经济预测模型,评估劳动力供给变化对经济增长、社会保障体系可持续性的潜在影响。此外,数据集的开放许可(CC-BY 4.0)和便捷的编程接口,进一步降低了其在实际业务中的应用门槛。
衍生相关工作
该数据集推动了多个相关领域的经典工作,其影响力涵盖统计建模、机器学习与跨学科研究。基于此数据,研究者发展了多种时间序列预测方法,如基于LSTM的就业人数预测模型和动态面板数据回归框架,用于捕捉就业率的非线性变化趋势。它还被用作性别薪酬差距研究中的关键协变量,支持了因果推断方法的创新应用。在数据科学社区中,该数据集作为基准案例,促进了针对层次化面板数据的分层建模、缺失值插补以及多源数据融合技术的对比研究。此外,与欧洲统计局(Eurostat)数据和世界银行劳动力指标的结合分析,催生了一系列关于欧洲一体化进程中劳动力市场趋同性的高引用论文。这些衍生工作不仅验证了数据集的质量,也拓展了其在更广泛社会科学问题中的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

