
遇见数据集

media-metadata-openlibrary-books

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

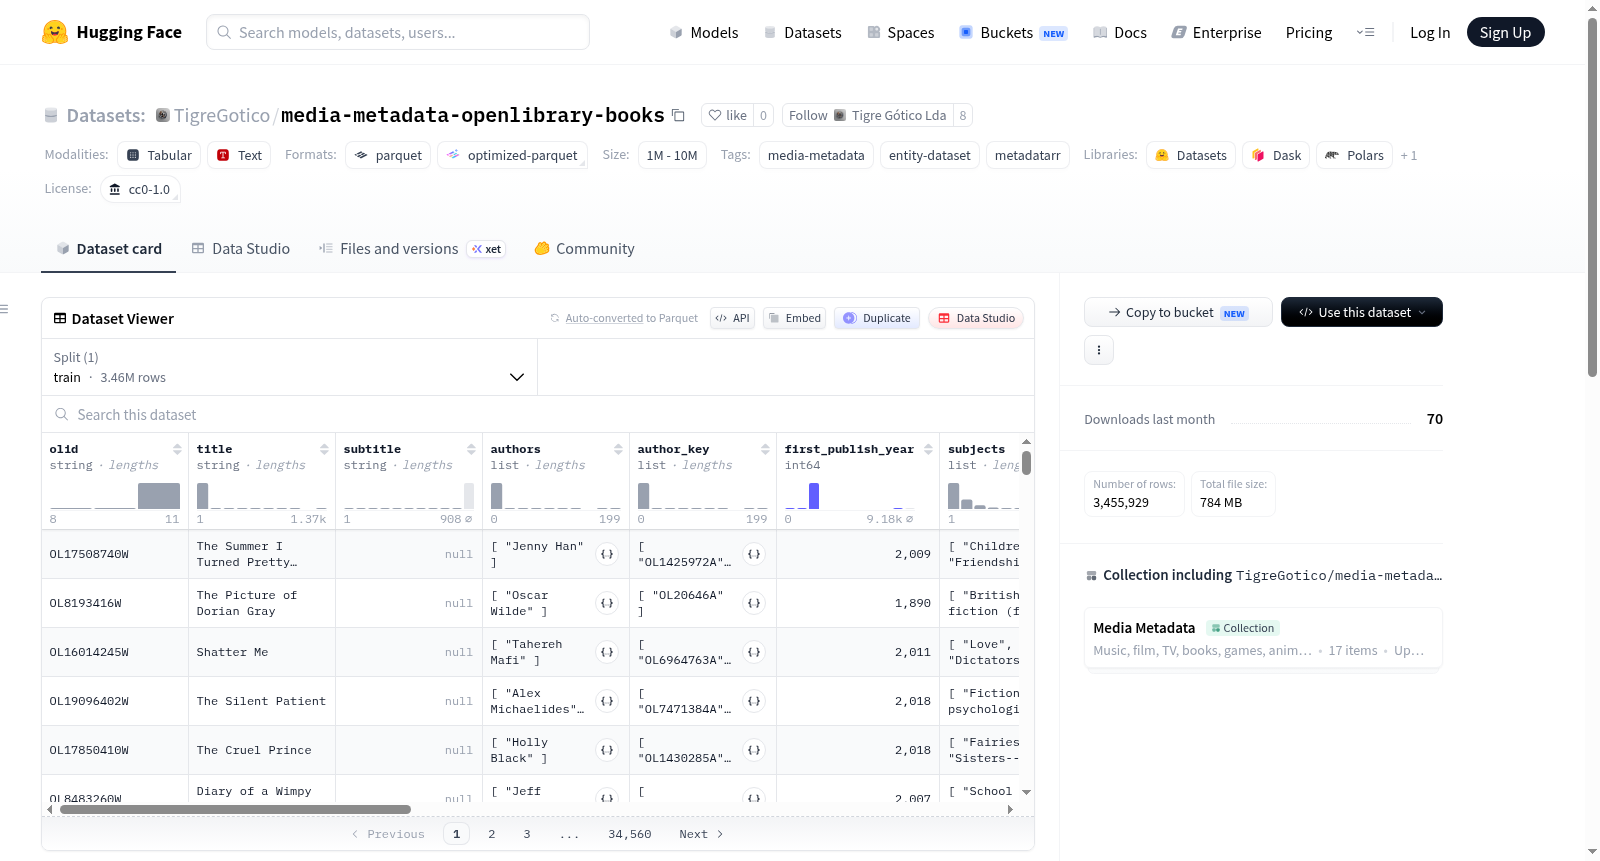
TigreGotico/media-metadata-openlibrary-books 是一个由 metadatarr 爬虫工具从 OpenLibrary 抓取并构建的丰富实体数据集。数据集包含约 299 万条图书元数据记录,旨在提供结构化的图书信息用于媒体元数据相关的分析与应用。数据内容涵盖广泛的图书属性,具体包括:图书唯一标识符 (olid)、标题、副标题、作者列表、作者标识符 (author_key)、首次出版年份、主题分类、ISBN-10 与 ISBN-13 编码、出版社、语言、页数中位数、电子书访问权限状态 (ebook_access)、是否拥有全文 (has_fulltext)、版本数量 (edition_count) 以及封面图片标识符 (cover_i)。该数据集适用于多种下游任务,例如图书信息检索、知识图谱实体填充、推荐系统特征工程、出版趋势分析以及数字图书馆资源编目。

TigreGotico/media-metadata-openlibrary-books is a rich entity dataset built by the metadatarr crawler tool, scraped from OpenLibrary. It contains approximately 2.99 million book metadata records, aiming to provide structured book information for media metadata-related analysis and applications. The data covers a wide range of book attributes, including: book unique identifier (olid), title, subtitle, author list, author identifier (author_key), first publication year, subject classifications, ISBN-10 and ISBN-13 codes, publisher, language, median page count, ebook access status (ebook_access), full-text availability (has_fulltext), edition count (edition_count), and cover image identifier (cover_i). This dataset is suitable for various downstream tasks, such as book information retrieval, knowledge graph entity population, feature engineering for recommendation systems, publishing trend analysis, and digital library resource cataloging.
创建时间:
2026-06-26
搜集汇总
数据集介绍
media-metadata-openlibrary-books 数据集图片
构建方式
该数据集源自Open Library的丰富藏书数据,经由metadatarr工具中的openlibrary_books爬虫程序系统化采集与清洗而成。构建流程从Open Library公开API中抽取书籍元信息,涵盖逾三百四十五万条记录,每条记录包含唯一标识符、书目详情、作者信息等十六个核心字段,确保了数据的全面性与结构化。处理过程遵循自动化流水线,保证了数据的高效产出与一致性。
使用方法
本数据集适用于多种自然语言处理与信息检索场景,如图书推荐系统、作者影响力分析或出版趋势研究。用户可直接从HuggingFace平台加载数据,使用Python的pandas库处理结构化字段,或配合元数据管理工具进行筛选与建模。例如,可利用isbn字段进行跨数据库链接,或基于first_publish_year分析时间序列特征,构建知识图谱或预训练语料库。
背景与挑战
背景概述
在数字图书馆与知识图谱领域,实体元数据的丰富性与结构化程度直接决定了信息检索与语义理解的效能。该数据集由TigreGotico团队于近期通过metadatarr工具从OpenLibrary平台抓取并构建,旨在提供涵盖超345万条图书记录的详尽元数据集合,核心字段包括国际标准书号(ISBN)、作者、出版年份、主题、封面标识符等,为书籍实体识别与文学信息整合研究奠定了坚实的数据基础。其开源特性与CC0协议授权进一步推动了跨机构协作与学术传播,在文献计量学、推荐系统及数字人文研究中展现出显著影响力。
当前挑战
数据集所解决的核心挑战在于缓解传统书籍元数据分散、格式不一及缺失率高的问题,通过系统化抓取与归一化处理,实现对图书出版信息、作者关联及主题分类的高效整合。然而,构建过程中面临多重困难,包括OpenLibrary平台数据源的质量波动,不同版本间ISBN、出版者等字段的冲突,以及多语种、多文化背景下主题标签的语义对齐难题。此外,大规模爬取时的速率控制与合规性要求,以及去重、缺失值填补等数据清洗步骤的自动化精度,亦对维护数据的完整性与可靠性提出了严峻考验。
常用场景
经典使用场景
该数据集汇聚了来自Open Library平台的逾345万册图书的元数据,涵盖标题、作者、ISBN、出版社、语言、页数等丰富字段,为图书信息检索与推荐系统提供了坚实的数据基础。在数字图书馆与知识管理领域,研究者常将其作为图书实体链接与消歧的基准资源,助力实现跨平台书目信息的精准匹配与聚合。此外,数据集中的主题标签与出版年份信息,使其成为文献计量分析与出版趋势挖掘的理想素材,支持学者揭示不同学科领域的知识演化脉络。
解决学术问题
在学术研究中,该数据集有效缓解了图书元数据碎片化与标准化不足的难题,为构建统一的图书知识图谱提供了关键支撑。它解决了多源异构图书数据整合时的实体对齐挑战,推动了对图书作者合作网络、主题共现关系等深层知识结构的量化分析。通过提供规模庞大的结构化元数据,该数据集促进了机器学习方法在自动编目、书籍分类和版本比对等任务中的应用,显著提升了图书馆自动化与智慧化服务的理论深度。
实际应用
在实际应用中,该数据集可赋能公共图书馆与学术机构的馆藏管理系统,优化图书检索的召回率与排序效果,提升用户获取资源的效率。基于ISBN与封面图片字段,它可支撑二手书交易平台与在线书店的商品信息补全与重复检测。同时,出版业从业者能够借助出版年份、出版社等维度分析市场动态,制定精准的选题策划与发行策略。电子书平台亦可利用有声读物与全文访问信息,完善内容推荐算法。
数据集最近研究
最新研究方向
在大规模语义理解与图书信息挖掘的前沿领域,media-metadata-openlibrary-books数据集以其涵盖超345万条丰富的实体描述记录,成为推动多维度图书知识图谱构建、跨语言元数据对齐以及基于开放图书馆数据的文本语义检索研究的重要基石。该数据集通过系统化爬取Open Library平台,聚合了包括标题、作者、ISBN、出版信息、主题标签及封面标识等关键字段,为探索图书出版趋势、分析作者合作网络、实现跨域实体链接以及训练面向图书领域的大规模语言模型提供了高质量、结构化且遵循CC0-1.0许可的开放资源。近期研究热点集中在该数据集与新兴的大语言模型协同,用于增强图书推荐系统、自动化元数据补全以及融合多模态信息的知识推理任务,其开放性与丰富性对推动数字人文与智能信息服务领域的范式变革具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

