electricsheepasia/asia-ilo-eip-rcar-sex-edu-rt-share-of-persons-outside-the-labour-force-due-to-c
收藏资源简介:
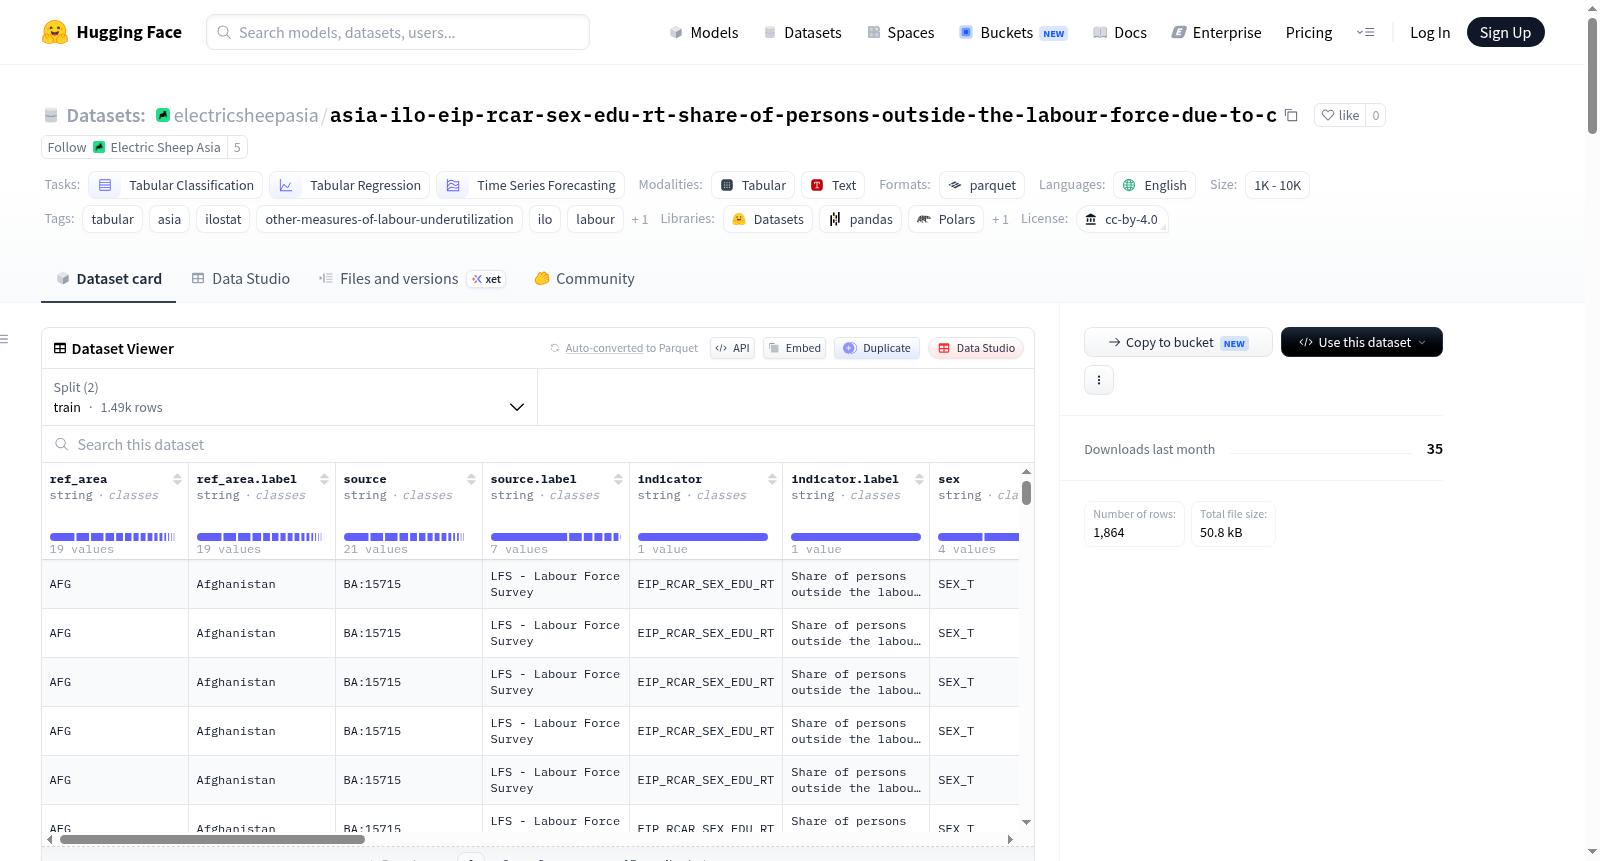
该数据集名为因照顾责任而退出劳动力市场的人口比例(按性别和教育程度划分)| 亚洲(ILOSTAT),包含了关于其他劳动力未充分利用指标的数据。数据集共有1,864个观测值,覆盖24个亚洲国家,时间跨度为2000年至2025年,涉及1个独特指标。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,该数据库是全球劳动力统计的主要来源,整合了就业、失业、工资、工作时间、童工、非正规经济、社会保护、职业伤害和可持续发展目标体面工作目标等多个领域的指标。数据通过ILOSTAT REST API直接获取,并过滤为亚洲国家代码。数据集包含以下列:国家代码(ref_area)、国家名称(ref_area.label)、来源代码(source)、来源名称(source.label)、指标代码(indicator)、指标名称(indicator.label)、性别(sex)、性别标签(sex.label)、第一分类变量(classif1)、第一分类变量标签(classif1.label)、时间(time)、观测值(obs_value)、观测状态(obs_status)、观测状态标签(obs_status.label)等。具体指标为EIP_RCAR_SEX_EDU_RT,表示因照顾责任而退出劳动力市场的人口比例(按性别和教育程度划分)(%)。数据按年度频率发布,并提供了性别分解维度(包括总计、男性、女性和其他)。数据质量方面,当同一国家×年份有多个来源时,使用ILO选择的最佳来源。数据集适用于表格分类、表格回归和时间序列预测等任务,使用CC-BY-4.0许可证发布。
The dataset is titled Share of persons outside the labour force due to care responsibilities by sex and educatio | Asia (ILOSTAT) and contains data on Other measures of labour underutilization. It includes 1,864 observations across 24 Asia countries, spanning the years 2000 to 2025, covering 1 distinct indicator. The data is sourced from ILOSTAT, the International Labour Organizations central statistics database, which is a leading global source for labour statistics, compiling indicators across employment, unemployment, wages, working time, child labour, informal economy, social protection, occupational injuries, and SDG decent work targets. Data is pulled directly from the ILOSTAT REST API and filtered to Asia ISO3 country codes. The dataset schema includes columns such as ref_area (ISO country code), ref_area.label (country name), source (ILOSTAT source code), source.label (source name), indicator (ILOSTAT indicator code), indicator.label (indicator name), sex (disaggregation by sex), sex.label (sex label), classif1 (first classification variable), classif1.label (classification label), time (observation year), obs_value (observed indicator value), obs_status (observation status flag), obs_status.label (status label), among others. The specific indicator is EIP_RCAR_SEX_EDU_RT, which represents Share of persons outside the labour force due to care responsibilities by sex and education (%). Data is annual in frequency, with disaggregation dimensions including sex (with 4 unique values: SEX_T, SEX_M, SEX_F, SEX_O). For data quality, when multiple sources exist for the same country×year, the ILO-selected best source is used. The dataset is suitable for tabular classification, tabular regression, and time-series forecasting tasks, and is released under the CC-BY-4.0 license.