
Kaikaku/epicure-corpus-resources
收藏官方服务:
资源简介:
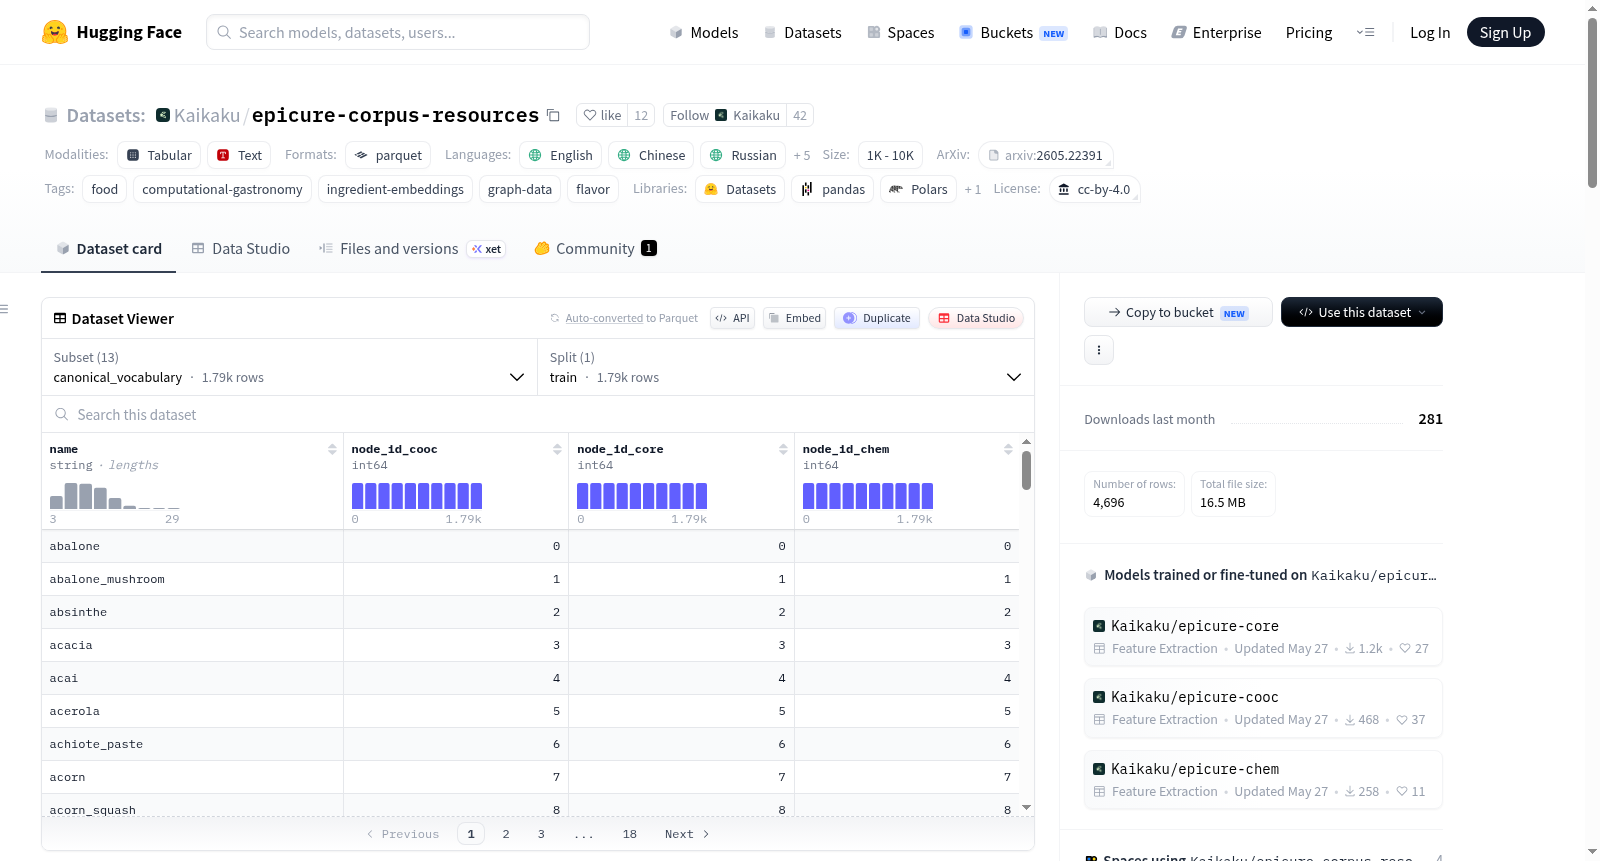
这是三个Epicure成分嵌入模型仓库的配套数据集。包含规范词汇表、每个模型的GMM模式图谱、有监督方向质量结果、无监督因子对齐表、WEAT和Procrustes鲁棒性检查、针对外部USDA和FlavorDB标签的跨模态验证、完整的SLERP方向算术结果表以及补充PDF附录。数据集用于食品成分嵌入的几何分析,支持多语言,涉及食品、计算美食学、成分嵌入、图数据和风味等主题。
Companion dataset for the three Epicure ingredient-embedding model repos. Contains the canonical vocabulary, the per-model GMM mode atlases, the supervised direction-quality results, the unsupervised factor-alignment tables, the WEAT and Procrustes robustness checks, the cross-modal validation against external USDA and FlavorDB labels, the full SLERP direction-arithmetic result table, and the supplementary PDF appendix.
提供机构:
Kaikaku搜集汇总
数据集介绍
构建方式
Epicure-corpus-resources数据集是Epicure系列食材嵌入模型的配套资源,其构建基于对4.14百万条多语种食谱文本的深度挖掘与结构化处理。研究团队从11个第三方数据源中聚合烹饪数据,通过规范化处理形成涵盖1790个食材的标准词汇表,并以此为基础训练三种不同模态的嵌入模型(基于共现、核心成分与化学结构的Cooc、Core与Chem变体)。数据集的构建过程融合了高斯混合模型(GMM)对嵌入空间的模式分解、独立成分分析(ICA)对潜在维度的因子抽取,以及针对食材方向算术的球面线性插值(SLERP)计算,系统性地将原始食谱文本转化为结构化的语义知识图谱。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集的各个配置项,例如使用`load_dataset('Kaikaku/epicure-corpus-resources', 'canonical_vocabulary')`获取标准词汇表,或通过`mode_atlas_cooc`等配置访问特定模型的模式图集。对于工程部署,建议从对应模型仓库加载safetensors格式的嵌入向量以实现高效推理;而CSV格式的`epicure_{cooc,core,chem}.csv`文件则保留了与arXiv原始压缩包的向后兼容性,适用于快速原型开发。研究用途上,`direction_arithmetic_full.parquet`提供了完整的48个测试案例在四个角度与三个模型下的定向算术结果,可直接复现论文第4.2节的分析实验。需注意,原始食谱文本与成分-化合物边列表因许可证限制未包含在该数据集中,研究人员应依据各源数据的独立条款另行获取。
背景与挑战
背景概述
Epicure语料库资源数据集诞生于计算美食学这一新兴交叉领域,由Jakub Radzikowski与Josef Chen于2026年创建,旨在探索食材嵌入向量的几何结构。该数据集作为Epicure系列模型(Epicure-cooc、Epicure-core、Epicure-chem)的配套资源,核心研究问题聚焦于如何通过无监督与监督方法,从海量食谱文本中学习食材的语义表示,并揭示其背后的风味与文化关联。数据集包含了规范词汇表、GMM模式图谱、方向算术结果表及跨模态验证数据等丰富组件,为食材嵌入研究提供了标准化基准。其发布不仅推动了计算美食学领域的发展,也为自然语言处理、图神经网络与食品科学交叉研究提供了重要数据支撑,在短短时间内已展现出对食品计算社区的显著影响力。
当前挑战
Epicure数据集所面临的挑战体现在领域问题与构建过程两个层面。领域层面,食材嵌入研究需解决多语言、多文化背景下的语义对齐难题,以及如何从异构食谱文本中提取可迁移的风味表示,这远超传统图像分类等任务。构建过程中,数据集面临多重困难:首先,近415万条食谱源自11个第三方来源,许可协议各异,导致原始文本与关键图结构数据(如共现图、成分-化合物图)因版权审查未能直接包含,限制了其可复现性。其次,每类食材的8区域烹饪标签尚未完全纳入,需依赖启发式方法重建方向向量,增加了不确定性。此外,跨模态验证虽引入USDA与FlavorDB外部标签,但外部数据自身也存在覆盖范围与时效性的局限。这些挑战共同构成了该领域研究进展中需持续克服的瓶颈。
常用场景
经典使用场景
在计算美食学这一交叉学科中,Epicure语料资源集为探索食材嵌入向量的几何结构提供了标准化基准。该数据集最经典的使用场景是作为食材嵌入模型的配套验证平台,研究人员可利用其包含的规范词汇表、高斯混合模型模式图谱以及方向算术结果表,系统性地评估不同嵌入策略(如共现统计、核心语义、化学属性)在食材语义空间中的表征差异。通过加载模式图谱中的因子极点和连续属性列,用户可以复现论文中关于食材概念方向一致性的分析,例如通过SLERP方向算术测试来检验“甜味→咸味”等风味转换路径的线性保持能力。该资源集还特别设计了交叉验证配置,使研究者能够直接对比嵌入投影与外部USDA营养成分标签及FlavorDB分子数据的相关性,从而验证向量空间是否真正编码了可感知的理化属性。
解决学术问题
该数据集核心解决了食材嵌入领域长期存在的三大方法论困境:评价基准碎片化、可解释性缺失以及跨模态验证困难。通过提供统一的规范词汇表(1790个标准食材条目)和多维度对齐表,Epicure资源集首次实现了对三种不同语义来源(食谱共现、核心网络结构、化学成分)嵌入模型的直接比较与排序。其搭载的线性探测配置能够量化每维向量对食品分类体系(如NOVA加工等级、食物组别)的编码强度,从而揭示稀疏嵌入空间中语义维度的分布规律。更为关键的是,WEAT效应量和Procrustes感官分析表为检测嵌入中的文化偏好偏差(如西式vs亚洲烹饪倾向)提供了统计手段,推动了计算美食学从单纯的特征工程向公平性与普适性研究的范式转变。这项工作的意义在于它为食材表示学习建立了一个可复现、可扩展的评估生态系统,使后续研究得以摆脱对特定食谱语料库的依赖。
实际应用
在实际应用中,Epicure资源集为智能食谱推荐系统和个性化饮食规划工具提供了底层语义支撑。食品科技公司可借助其跨模态验证数据,训练出能够根据用户偏好(如低糖、地中海风格)进行食材替代推荐的嵌入模型——例如利用方向算术结果中保存的“健康油类→橄榄油”的线性变换向量,在保持风味相似度的前提下调整营养成分。国际连锁餐饮品牌也能利用其包含的八大菜系宏观区域分类与厨师感性指标进行跨文化菜单适配,通过分析菜系方向向量与感官属性(如辣度、鲜味)之间的几何关系,量化不同地区口味偏好的语义距离。此外,营养学研究机构可以利用线性探测连续目标表,快速评估食材嵌入对宏观营养素(蛋白质、脂肪、碳水化合物)的预测能力,从而在无需营养数据库的情况下,从食谱文本直接估算膳食成分。
数据集最近研究
最新研究方向
Epicure语料库资源集聚焦于计算美食学前沿,通过食材嵌入的几何空间探索风味与文化的深层关联。该数据集融合了多模态图谱(共现、核心、化学)、方向算术与因子对齐技术,系统性解析食材间的语义与化学结构。其核心创新在于利用SLERP方向算术与GMM模式图谱,量化烹饪文化差异与感官属性,并借助WEAT测试与Procrustes分析评估模型鲁棒性。这一资源为跨文化风味预测、个性化营养推荐及食品科学中的智能计算打开了新维度,标志着食材嵌入研究从静态列表走向动态几何推理,推动了人工智能与美食学的深度融合。
以上内容由遇见数据集搜集并总结生成


