
maidalun1020/CrosslingualRetrievalWikiEn2Zh
收藏官方服务:
资源简介:
--- license: apache-2.0 configs: - config_name: default data_files: - split: queries path: data/queries-* - split: corpus path: data/corpus-* dataset_info: features: - name: id dtype: string - name: text dtype: string splits: - name: queries num_bytes: 7637627 num_examples: 34060 - name: corpus num_bytes: 6808639 num_examples: 6506 download_size: 10298082 dataset_size: 14446266 ---
提供机构:
maidalun1020原始信息汇总
数据集概述
许可证
- Apache 2.0
配置
- 默认配置 (
default)- 数据文件路径:
queries分割:data/queries-*corpus分割:data/corpus-*
- 数据文件路径:
数据集信息
-
特征:
id:数据类型为stringtext:数据类型为string
-
分割:
queries:- 字节数:7637627
- 样本数:34060
corpus:- 字节数:6808639
- 样本数:6506
-
下载大小:10298082 字节
-
数据集大小:14446266 字节
搜集汇总
数据集介绍
构建方式
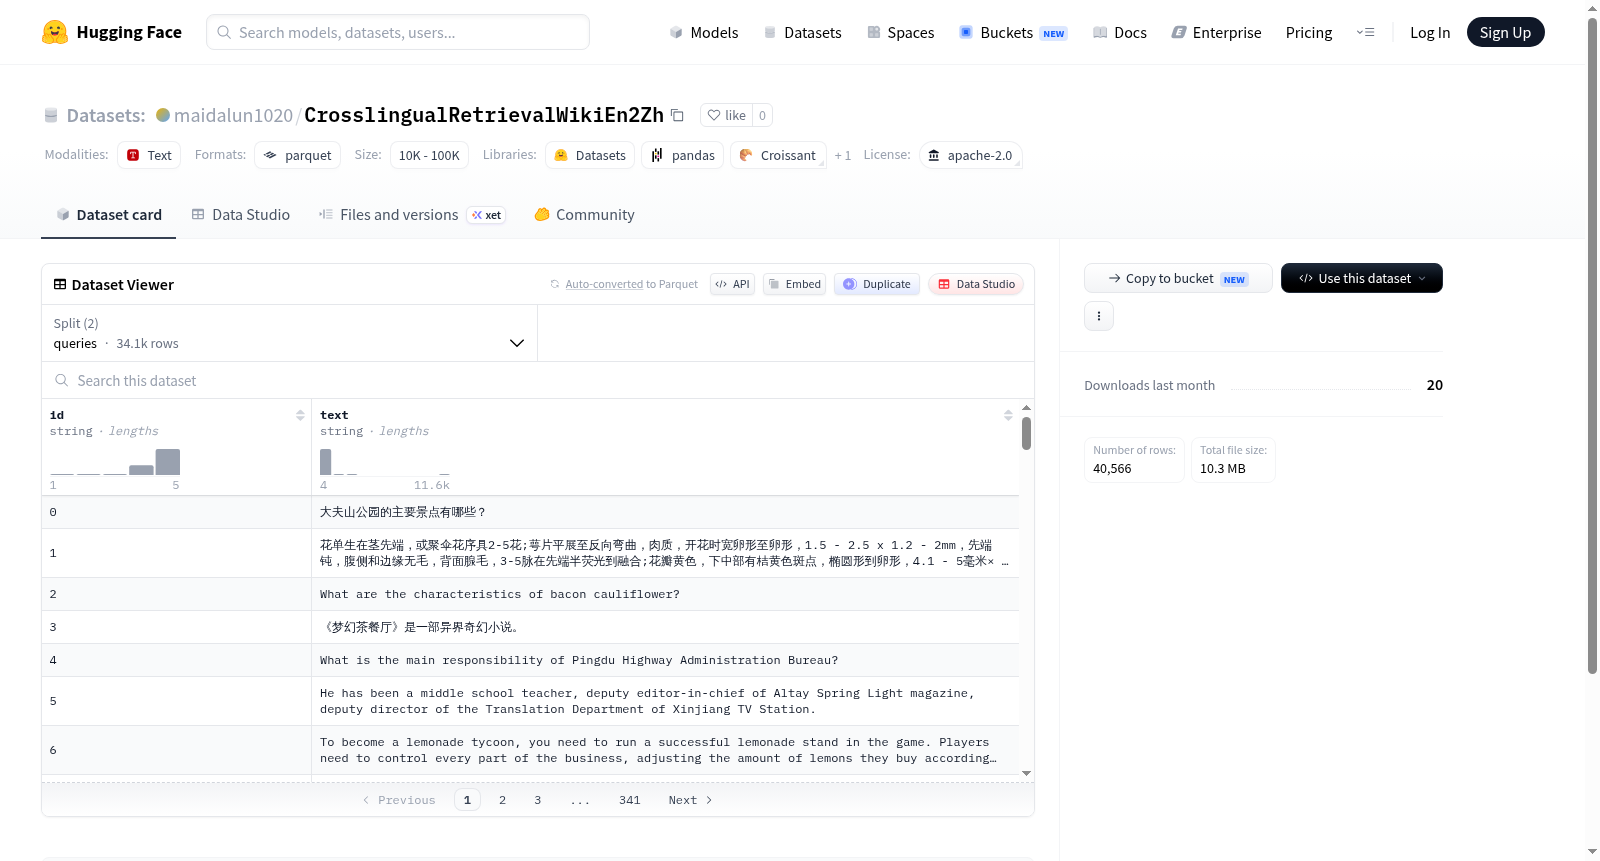
跨语言信息检索领域,双语对齐语料库的构建是支撑跨语言语义匹配与检索任务的基础。该数据集基于维基百科中英文语料,通过精心设计的对齐策略构建而成。具体而言,其以英文维基百科条目作为查询(queries)集合,共包含34,060个查询样本,同时以对应中文维基百科条目构建语料库(corpus),涵盖6,506个文档。数据采用分片存储格式,确保大规模数据的高效加载与处理,每个样本均以唯一标识符(id)和文本内容(text)的形式呈现,为后续检索任务提供标准化的输入结构。
使用方法
使用该数据集时,可依据HuggingFace Datasets库的标准加载流程,通过指定配置名'default'及相应数据分片路径直接读取。查询集与语料库分别对应'queries'和'corpus'两个拆分,研究者可据此构建检索管线:以查询文本作为输入,在语料库中检索最相关的中文文档。数据集支持直接用于训练双编码器或交叉编码器模型,亦可作为评估集对预训练跨语言模型进行零样本性能测试。建议结合评估指标如MRR(平均倒数排名)或Recall@k进行检索效果量化分析。
背景与挑战
背景概述
跨语言信息检索作为自然语言处理领域的重要分支,旨在打破语言壁垒,实现不同语种间语义层面的高效知识获取。在此背景下,由研究人员maidalun1020构建的CrosslingualRetrievalWikiEn2Zh数据集应运而生,其创建时间可追溯至近年跨语言表征学习蓬勃发展的时期。该数据集以英文维基百科文档为源语料,通过精细化的对齐与筛选,构建了包含约3.4万条查询与6506篇文档的跨语言检索基准,核心研究问题聚焦于评估模型在英文查询与中文文档间的语义匹配能力。作为面向英中语言对的专用资源,该数据集填补了高资源语言对(如英德、英法)之外的低资源跨语言检索评测空白,为双语检索模型的训练与评估提供了标准化测试平台,对推动跨语言信息检索技术在中文场景下的应用与发展具有显著影响力。
当前挑战
该数据集所解决的领域问题在于跨语言语义鸿沟的弥合,即如何使模型在英文查询与中文文档间建立准确的语义对应关系,这一挑战源于两种语言在语法结构、表达习惯与文化背景上的显著差异。在构建过程中,研究人员面临多重困难:首先,维基百科语料的跨语言对齐并非一一对应,需要从海量异构数据中筛选出语义等价或高度相关的查询-文档对,这涉及复杂的语义相似度计算与人工校验,以确保基准的可靠性。其次,数据规模的控制是一大难题,在保持查询多样性(超3.4万条)与文档覆盖范围(6506篇)的同时,需避免冗余与噪声,这对采样策略与质量过滤机制提出了高要求。此外,跨语言检索评测的公平性依赖于查询与文档分布的均衡性,防止模型因数据偏差而过度拟合特定主题或领域,这一平衡过程在有限资源下尤为棘手。
常用场景
经典使用场景
在跨语言信息检索与多语言自然语言处理领域,CrosslingualRetrievalWikiEn2Zh数据集作为一座桥梁,将英语与中文的维基百科知识库紧密联结。其经典使用场景聚焦于跨语言密集检索任务,研究者利用该数据集训练和评估模型在英文查询与中文语料库之间的语义匹配能力。通过构建包含3.4万余条英文查询和6千余条中文文档的平行检索对,该数据集为跨语言表示学习提供了标准化的评测基准,尤其适用于探索语言无关的语义嵌入空间,推动零样本跨语言检索技术的发展。
解决学术问题
该数据集直面跨语言语义鸿沟这一核心学术挑战,解决了传统单语检索系统无法有效处理多语言查询与文档匹配的痛点。通过提供大规模、高质量的中英文对齐语料,它使得研究者能够深入探究跨语言密集检索中查询与文档的语义对齐机制,验证多语言预训练模型(如mBERT、XLM-R)在跨语言场景下的泛化能力。其发布显著推动了跨语言信息检索领域评估体系的规范化,为对比不同跨语言编码策略的有效性提供了可复现的基准,进而促进了多语言自然语言处理技术的理论突破。
实际应用
在实际应用层面,CrosslingualRetrievalWikiEn2Zh数据集为构建面向全球用户的多语言搜索引擎和跨语言知识问答系统提供了关键支撑。例如,国际企业可利用该数据集训练智能客服系统,使其能理解英文提问并精准检索中文知识库中的答案,从而打破语言壁垒,提升服务效率。此外,该数据集还可赋能跨语言新闻摘要、多语种文档聚类以及学术文献的跨语言推荐等场景,帮助用户从海量异构信息中快速定位所需内容,显著降低多语言环境下的信息获取成本。
数据集最近研究
最新研究方向
跨语言信息检索是自然语言处理领域的前沿热点,尤其在多语言知识获取与低资源语言理解中扮演关键角色。maidalun1020/CrosslingualRetrievalWikiEn2Zh数据集聚焦于英文到中文的跨语言检索任务,基于维基百科构建了包含3.4万条查询与6506篇文档的平行语料库,为评估和提升跨语言语义匹配模型提供了标准化基准。当前研究趋势集中于利用对比学习与多语言预训练模型(如mBERT、XLM-R)优化跨语言嵌入对齐,该数据集成为验证零样本迁移与跨语言泛化能力的重要测试平台。随着全球化信息需求的增长,该数据集在机器翻译、多语言问答系统及知识图谱构建等应用中具有显著价值,推动了跨语言检索技术的实用化进程。
以上内容由遇见数据集搜集并总结生成


