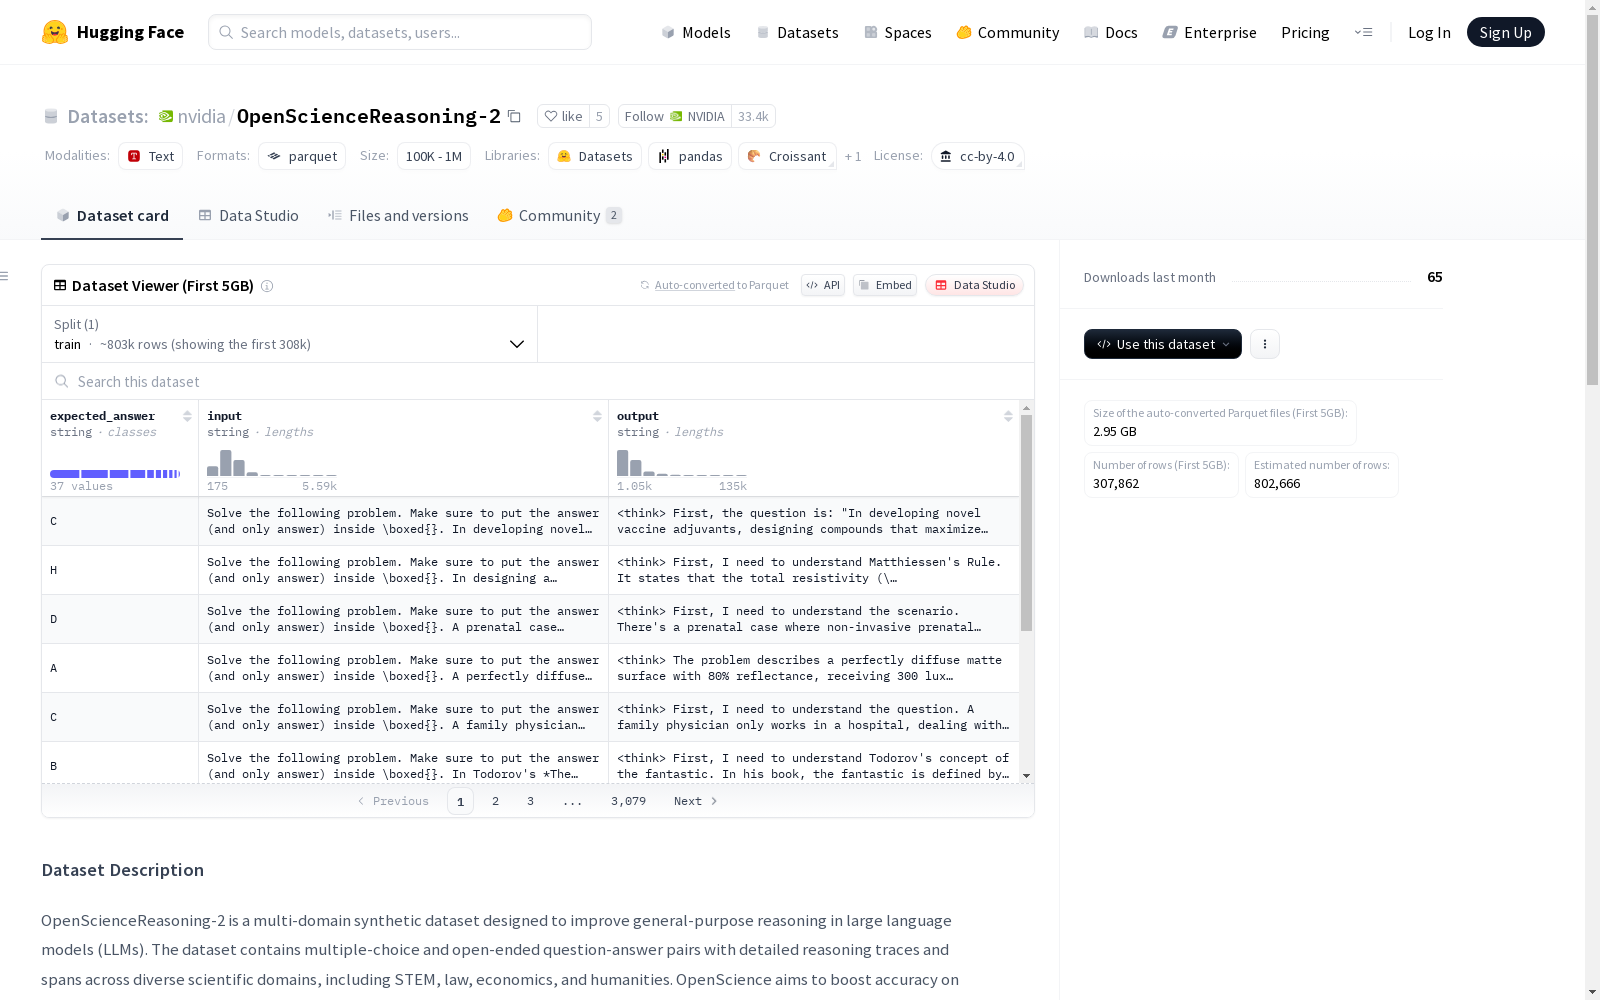
OpenScienceReasoning-2
收藏资源简介:
OpenScienceReasoning-2是一个旨在提高大型语言模型通用推理能力的多领域合成数据集。它包含了跨越STEM、法律、经济学和人文科学等多个科学领域的问题答案对,既有选择题也有开放性问题,并提供了详细的推理痕迹。这个数据集可用于商业用途,并通过监督微调或强化学习来提升在高级基准测试上的准确性。
OpenScienceReasoning-2 is a multi-domain synthetic dataset developed to enhance the general reasoning capabilities of Large Language Models (LLMs). It contains question-answer pairs across multiple scientific disciplines including STEM, law, economics, and humanities, covering both multiple-choice and open-ended questions, alongside detailed reasoning traces. This dataset is available for commercial use, and can be used to improve accuracy on advanced benchmark tests via supervised fine-tuning or reinforcement learning.
OpenScienceReasoning-2 数据集概述
数据集描述
OpenScienceReasoning-2 是一个多领域合成数据集,旨在提升大型语言模型(LLMs)的通用推理能力。该数据集包含多项选择和开放式问答对,涵盖科学、技术、工程、数学(STEM)、法律、经济学和人文等多个领域。数据集通过监督微调或强化学习来提高模型在高级基准测试(如GPQA-Diamond、MMLU-Pro和HLE)上的准确性。
数据集所有者
NVIDIA Corporation
数据集创建日期
2025年6月20日
许可证/使用条款
本数据集采用知识共享署名4.0国际许可协议(CC BY 4.0)许可。
预期用途
OpenScienceReasoning-2 旨在供社区使用,以继续改进开放模型。数据可自由用于训练和评估。
数据版本
- v2
数据集特征
数据收集方法
- 合成
标注方法
- 合成
数据集格式
文本
数据集量化
- 记录数量:160万问答对
- 总数据存储:35GB
伦理考虑
NVIDIA认为可信赖的人工智能是共同责任,并已制定政策和实践以支持广泛的人工智能应用开发。开发者在下载或使用本数据集时,应确保其符合相关行业和使用案例的要求,并解决潜在的产品误用问题。
如需报告安全问题或NVIDIA AI相关疑虑,请访问NVIDIA安全漏洞提交页面。