
遇见数据集

zhongyi-zhou/toolgrad-500

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

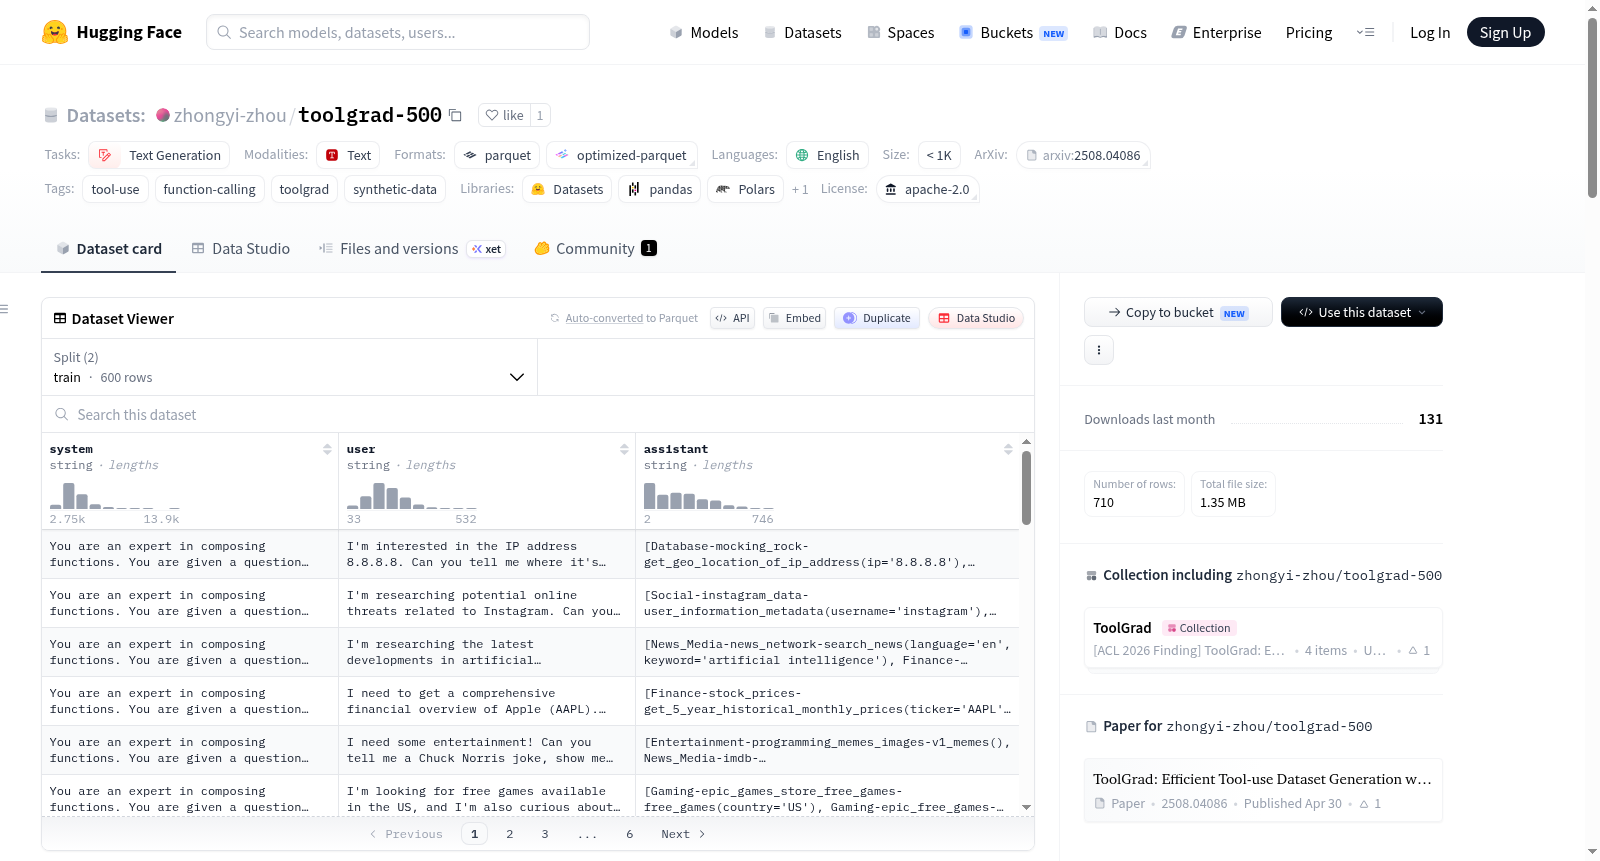
ToolGrad-500是一个合成的工具使用数据集,专注于单轮并行函数调用场景。该数据集通过ToolGrad框架(ACL 2026 Findings)生成,利用文本梯度来优化工具选择和调用。数据集包含600个训练示例(其中500个正例和100个负例/不相关示例)和110个测试示例,用于评估在另一个LLM生成的数据上的工具准确性。每个对话都是单轮结构,由三个消息组成:系统提示(包含完整的API库文档和严格的格式指南)、用户查询和助手响应(以Python列表形式表示并行函数调用,例如[func1(arg=val), func2(arg=val)])。数据集的目的是训练模型在单轮对话中同时执行多个工具调用,以响应用户的复杂请求。数据集采用标准对话格式,适用于文本生成任务,并包含工具使用和函数调用相关标签。

ToolGrad-500 is a synthetic tool-use dataset targeting single-turn parallel function calling scenarios. The dataset is generated using the ToolGrad framework (ACL 2026 Findings), leveraging textual gradients to optimize tool selection and calling. It consists of 600 training examples (500 positive and 100 negative/irrelevance examples) and 110 test examples for evaluating tool accuracy on data generated from another LLM. Each conversation is a single turn with three messages: a system prompt containing complete API library documentation and strict formatting guidelines, a user query, and an assistant response that is a Python-braced list of composed tool invocations (e.g., [func1(arg=val), func2(arg=val)]). The dataset is designed to train models to execute multiple parallel tool calls in a single turn to address complex user requests. It follows a standard conversational format suitable for text-generation tasks and is tagged with tool-use, function-calling, and synthetic-data.
提供机构:
zhongyi-zhou
搜集汇总
数据集介绍
zhongyi-zhou/toolgrad-500 数据集图片
构建方式
ToolGrad-500数据集基于ToolGrad框架(ACL 2026 Findings)构建,利用文本梯度优化技术实现工具选择与调用的自动生成。构建流程首先并行生成500条种子轨迹作为基础,随后采用gemini-2.5-flash-lite模型以低廉的计算成本进行推理,最终产出600条高质量训练样本与110条测试样本。其中训练集包含500条正向样例与100条负向/不相关样例,负例的引入迫使模型在缺乏合适工具时优雅地拒绝或采用回退逻辑,有效抑制了工具调用的幻觉问题。
特点
该数据集聚焦于单轮并行函数调用场景,每个对话严格由system、user、assistant三条消息组成,构成完整的单轮交互。系统提示中包含完整的API库文档与严格的格式指令,用户查询则模拟真实需求,助手响应以Python括号列表形式呈现多个并发函数调用。这种结构设计摒弃了传统多轮对话的冗余,专为训练智能体同时执行多项独立工具任务而优化,特别适合评估模型在复杂指令下的并行工具编排能力。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,仅需一行Python代码即可获取:`dataset = load_dataset('zhongyi-zhou/toolgrad-500')`。数据集划分为train和test两个子集,支持直接索引查看样本,例如`dataset['train'][0]['messages']`可获取包含system、user、assistant角色消息的完整交互。用户可根据需求将数据用于模型微调、工具调用能力评估或作为基准测试集,数据格式与标准对话训练器高度兼容,便于集成到现有训练流程中。
背景与挑战
背景概述
ToolGrad-500数据集由周中毅、上原康平、张浩宇等研究团队于2026年构建,发表于ACL 2026 Findings,旨在解决大语言模型在工具使用场景中的单轮并行函数调用问题。该数据集基于ToolGrad框架生成,通过引入文本梯度优化工具选择与调用过程,以提升模型在复杂任务中同时调用多个API的准确性与鲁棒性。研究背景源于当前大语言模型在函数调用时普遍存在的幻觉与单步调用的局限性,ToolGrad-500填补了这一空白,为社区提供了首个专为并行工具调用设计的高质量合成数据集,对增强语言模型的实际部署能力具有重要推动作用。
当前挑战
该数据集所解决的领域挑战是大语言模型在真实工具使用场景中难以高效、准确地并行调用多个函数,传统方法常因贪婪推理或缺乏负样本导致工具调用幻觉。构建过程中,挑战在于设计能模拟真实API交互的单轮对话格式,并确保生成的负样本(无可用工具场景)能有效引导模型学习优雅降级策略。此外,数据合成需平衡成本与质量,采用轻量级模型生成后还需人工或自动化验证调用的合规性与语义合理性,这对构建规模与可扩展性提出了严格要求。
常用场景
经典使用场景
ToolGrad-500 作为合成工具使用数据集,其核心价值在于为单轮并行函数调用任务提供了标准化的训练与评估基准。该数据集精心构建了600条高质量的训练会话和110条测试样本,每条样本均包含系统提示、用户查询与对应的并行工具调用列表。这种精心设计的结构使得研究人员能够直接用以微调大语言模型,使其掌握根据自然语言指令同时调用多个API函数的能力,从而成为函数调用领域不可或缺的核心训练资源。
实际应用
在实际应用层面,ToolGrad-500所代表的单轮并行函数调用能力极具实用价值。例如,智能助手可以同时查询多个数据库(如搜索流行音乐、获取YouTube趋势和随机K-pop信息),一键整合信息给用户;客服机器人能够并行调用库存查询、订单更新和物流追踪等多个API,大幅提升服务效率。该数据集微调出的模型能极大优化工作流自动化、信息聚合平台和个人助理等系统的交互流畅度与响应速度。
衍生相关工作
ToolGrad-500数据集源自ToolGrad框架,该框架创新性地利用文本梯度优化工具选择与调用过程。其生成的数据集已催生了一系列后续研究,包括基于该数据集的模型工具使用能力评测基准、面向复杂API编排的对话训练范式,以及探索如何在多轮对话中继承并行调用能力的工作。这些衍生研究共同推动了工具增强型语言模型的系统化发展,使得函数调用从实验探索逐渐迈向稳健的工业级应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

