
遇见数据集

hf-hub-daily-downloads-full

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

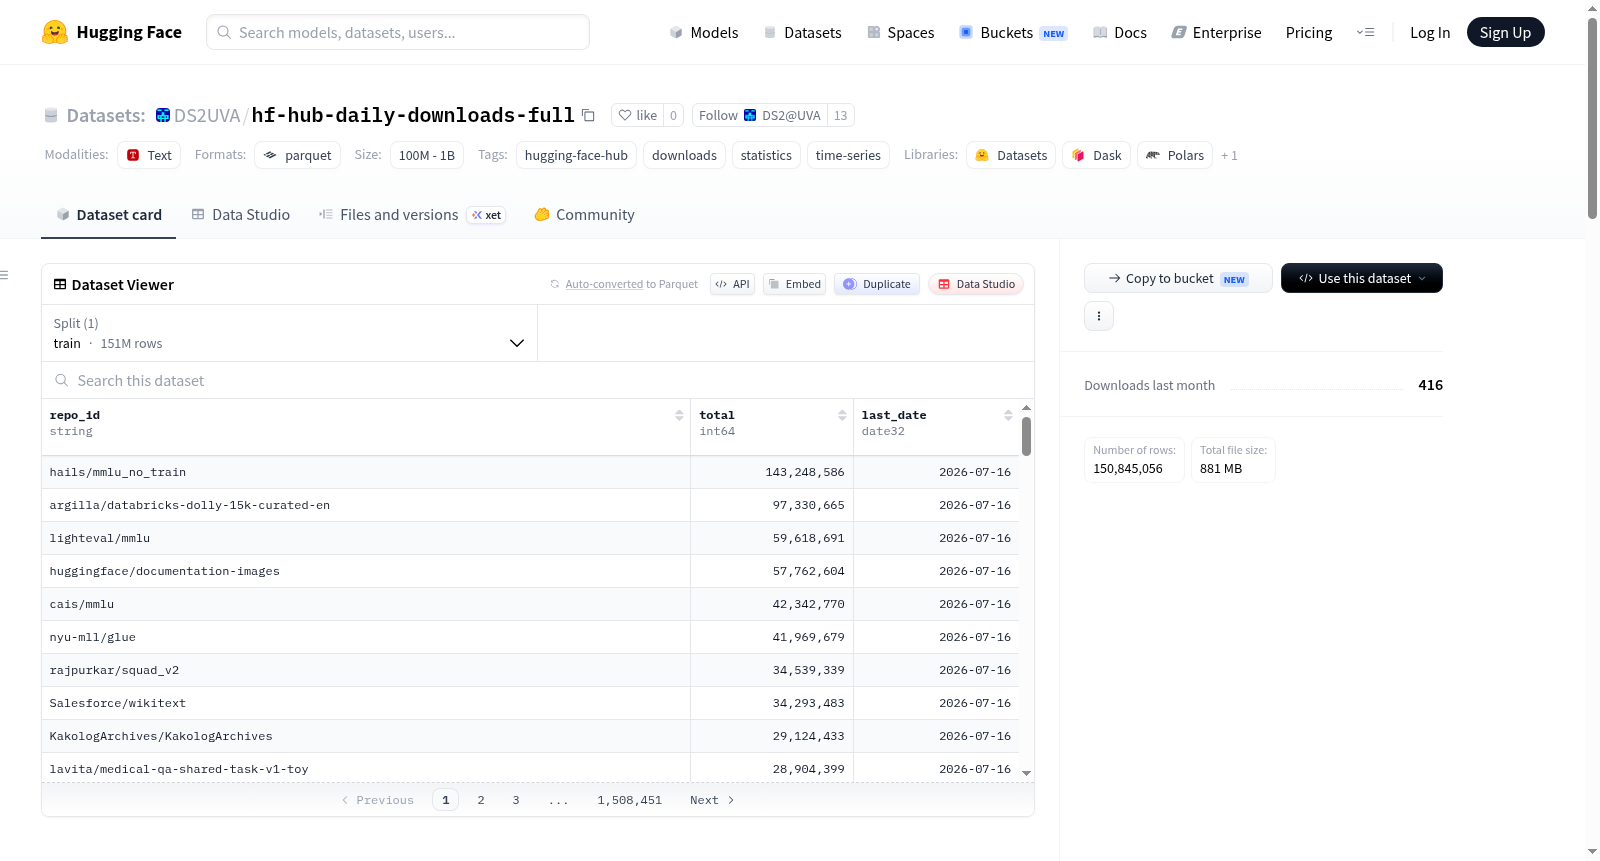
Hugging Face Hub每日下载数据集记录了整个Hugging Face Hub上模型和数据集仓库的每日下载次数。该数据集通过比较每日元数据快照中累计的下载总量计数器,重建了每日下载序列,弥补了Hub API仅提供累计总量和滚动30天总量的限制。数据集包含两个主要文件:models.parquet覆盖模型仓库,包含约7620万行数据,涉及303万个仓库,数据起始于2025年2月28日;datasets.parquet覆盖数据集仓库,包含约6960万行数据,涉及124万个仓库,数据起始于2025年3月3日。两个文件的数据均持续更新至2026年7月15日(约400个观察日)。数据模式包含8个字段:repo_id(仓库名称,可能因重命名而变化)、hub_id(跨重命名稳定的唯一标识符)、date(UTC日期)、downloads_delta(自上次观察以来的下载增量)、span_days(距上次观察的天数)、is_first_seen(是否首次出现)、downloads_total(截至该日的累计下载总量)、downloads_30d(Hub的滚动30天计数器)和created_at(仓库创建日期)。数据行表示仓库的累计计数器发生了移动:在截至date的span_days天内发生了downloads_delta次下载。没有某日的数据行意味着该日下载量为零。该数据集适用于下载趋势分析、仓库流行度排名、时间序列建模等任务,并附带按总下载量降序排序的名称索引文件,便于快速检索和自动补全。

The Hugging Face Hub daily downloads dataset records the daily download counts for model and dataset repositories across the entire Hugging Face Hub. It reconstructs daily download sequences by comparing the cumulative total downloads counter in daily metadata snapshots, addressing the limitation of the Hub API, which only provides cumulative totals and rolling 30-day totals. The dataset includes two main files: models.parquet covers model repositories, containing approximately 76.2 million rows across 3.03 million repositories, with data starting from February 28, 2025; datasets.parquet covers dataset repositories, containing approximately 69.6 million rows across 1.24 million repositories, with data starting from March 3, 2025. Both files are continuously updated until July 15, 2026 (approximately 400 observation days). The data schema comprises 8 fields: repo_id (repository name, which may change due to renaming), hub_id (a unique identifier stable across renames), date (UTC date), downloads_delta (download increment since the last observation), span_days (days since the last observation), is_first_seen (whether it is the first appearance), downloads_total (cumulative total downloads up to that date), downloads_30d (Hubs rolling 30-day counter), and created_at (repository creation date). Each data row indicates a movement in the cumulative counter for a repository: downloads_delta downloads occurred within span_days up to date. The absence of a row for a specific date means zero downloads on that day. This dataset is suitable for download trend analysis, repository popularity ranking, time series modeling, and other tasks, and includes a name index file sorted by total downloads in descending order for quick retrieval and autocompletion.

创建时间:
2026-07-16
搜集汇总
数据集介绍
hf-hub-daily-downloads-full 数据集图片
构建方式
该数据集通过差分Hugging Face Hub每日元数据快照中的累积下载量计数器构建。具体而言,基于`cfahlgren1/hub-stats`数据集提供的日级快照,对比相邻两日间`downloadsAllTime`字段的差值,从而恢复出逐日下载数据。数据覆盖模型与数据集两类仓库,分别存储为`models.parquet`和`datasets.parquet`文件,采用zstd压缩并按`(repo_id, date)`排序,便于高效查询。时间序列自2025年2月28日(模型)或3月3日(数据集)起,持续约400个观测日,并随新快照发布而更新。
特点
该数据集的核心特点在于提供了Hugging Face Hub上每个仓库的完整日常下载记录,弥补了官方API仅暴露累计和30天滚动总量的局限。每条记录包含不可变`hub_id`、下载增量、时间跨度、累计总数、30日计数及创建日期等字段。零下载日被省略以减少冗余,而仓库首次出现时标记为`is_first_seen`并忽略增量。负增量作为计数修正得以保留,但周度或更长周期的汇总具有可靠性。支持通过不可变`hub_id`追踪仓库重命名后的连续性。
使用方法
使用时可借助支持Parquet格式的查询引擎(如DuckDB、Polars、Spark)高效分析。推荐通过`hub_id`而非`repo_id`进行分组,以确保仓库重命名后统计的一致性。对于单仓库查询,例如`SELECT date, downloads_delta FROM 'models.parquet' WHERE repo_id = 'openai/gpt-oss-20b' ORDER BY date`,排序机制可大幅减少数据扫描量。附带的名称索引文件(`models-index.parquet`和`datasets-index.parquet`)已按总下载量降序排序,便于快速检索最热门仓库。用户亦可参考Hugging Face Spaces上的可视化界面辅助浏览。
背景与挑战
背景概述
在人工智能与机器学习领域,模型与数据集的共享与使用已成为推动技术进步的核心动力。Hugging Face Hub作为全球最大的预训练模型与数据集托管平台,其下载量统计对于理解社区生态、资源热度及技术趋势具有重要意义。然而,该平台官方API仅提供累计总量与近30天滚动下载数据,难以支持细粒度的时间序列分析。为此,研究人员基于每日元数据快照,通过计算连续快照间累积下载量的差值,构建了涵盖2025年2月28日至2026年7月15日、包含约7600万行模型仓库记录与6960万行数据集仓库记录的hf-hub-daily-downloads-full数据集。该数据集由Hugging Face社区成员与相关机构共同维护,首次实现了对Hugging Face Hub全量仓库日级下载数据的重建,为时间序列分析、流行度预测及资源推荐等研究提供了重要的基础数据支撑。
当前挑战
该数据集构建面临多重挑战。领域层面,原始Hugging Face Hub API仅暴露全时累计与30天滚动下载总量,无法直接获取逐日变化,研究者需通过快照差分技术间接推算,同时需应对快照可能存在的缺失、重复更新及仓库重命名等复杂情况。构建过程中,数据源仅支持2025年2月27日之后具备累计计数器的快照,早期数据无法还原;快照间可能存在时间间隔不均(如跨越数天),导致下游统计偏差;此外,部分快照因元数据过时或回退触发负向下载量修正,需特殊处理以维持数据一致性。最终形成的系列通过引入标识字段追踪仓库跨重命名稳定性,并采用稀疏存储策略(仅记录非零下载变化),在确保数据完整性的同时优化了存储与查询效率。
常用场景
经典使用场景
在开源机器学习生态系统的量化研究中,每日下载量数据是衡量模型与数据集影响力与传播动态的核心指标。hf-hub-daily-downloads-full数据集通过重构HuggingFace Hub上所有仓库的逐日下载量时序,为分析开源资源的热度演变、生命周期模式乃至社区采纳节奏提供了前所未有的细粒度视角。研究者可以基于该数据描绘资源流行度随时间的变化曲线,识别下载量突增的拐点事件,或对比不同领域、不同架构模型的长期吸引趋势,进而揭示开源社区中知识共享与协作的实际模式。
实际应用
在实际产业界与社区运营中,该数据集能够支持多种精准决策。模型开发者可依此追踪竞品或自身模型的日变化下载趋势,优化版本发布节奏与宣传窗口。平台运营方能够识别热门资源类型的更替规律,从而调整推荐算法与基础设施资源配置。此外,基于该数据构建的时序预测模型可用于提前预判节点负载,辅助计算资源动态调度。数据空间中的观览应用亦已落地,通过名称索引与热度排行,为开发者提供快速的资源发现接口,提升整个HuggingFace平台的用户体验与协作效率。
衍生相关工作
围绕该每日下载流量数据集,已衍生出一系列支撑性工具与下游分析工作。配套构建的仓库名称索引文件(models-index.parquet与datasets-index.parquet)按总下载量降序排列且采用小行组存储,使得最受欢迎资源的即时检索仅需读取极少数据,被集成至HuggingFace Space中的每日下载量阅览器,提供交互式查询界面。同时,同一仓库在不同日期可能更名的问题通过不可变的hub_id字段得到稳定追踪,引导后续研究专注于资源长期信誉与品牌迁移的分析。此外,数据构建方法中利用相邻快照差分与校验和去重的过程,本身也为学术社区维护高质量公开时序数据提供了可复现的技术范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

