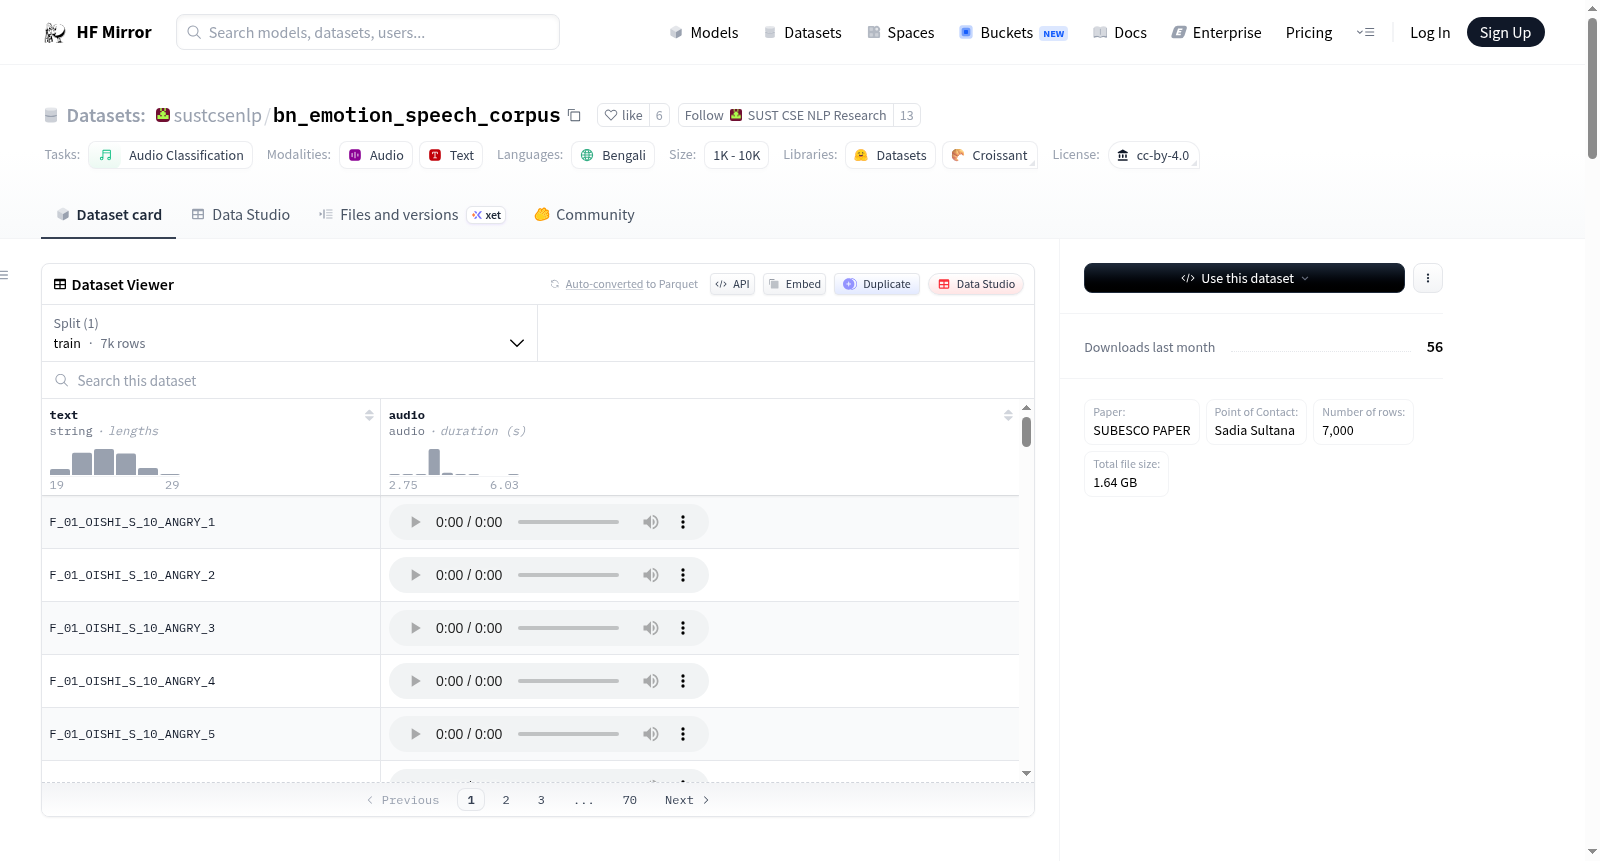
sustcsenlp/bn_emotion_speech_corpus
收藏资源简介:
SUBESCO是一个仅包含音频的孟加拉语情感语音语料库,包含7000个句子级别的语音。20名专业演员(10男10女)参与了10个句子的录制,涵盖了7种目标情感:愤怒、厌恶、恐惧、快乐、中性、悲伤和惊讶。数据集的总时长为7小时40分钟40秒,总大小为2.03 GB。数据集由50名评估者(25男25女)进行评价,人类感知测试的原始准确率为71%。数据集的创建、评估和分析的详细信息已在Plos One期刊上发表。
SUBESCO is an audio-only Bengali emotional speech corpus containing 7,000 sentence-level speech utterances. Twenty professional actors (10 male and 10 female) participated in the recording of 10 sentences, covering 7 target emotions: anger, disgust, fear, happiness, neutral, sadness, and surprise. The total duration of the corpus is 7 hours, 40 minutes and 40 seconds, with an overall file size of 2.03 GB. The corpus was evaluated by 50 annotators (25 male and 25 female), with an original accuracy rate of 71% in the human perception test. Detailed information on the creation, evaluation and analysis of the corpus has been published in the journal PLOS ONE.
SUST BANGLA EMOTIONAL SPEECH CORPUS 数据集概述
数据集描述
- 数据集名称: SUST BANGLA EMOTIONAL SPEECH CORPUS (SUBESCO)
- 数据集大小: 2.03 GB
- 数据集时长: 7小时40分钟40秒
- 语言: 孟加拉语 (Bangla)
- 任务类别: 音频分类
- 情感类别: 愤怒、厌恶、恐惧、幸福、中性、悲伤、惊喜
- 录音参与者: 20名专业演员(10名男性和10名女性)
- 录音内容: 每位演员录制10句,共7种情感
- 评估: 由50名评估者(25名男性和25名女性)进行的人类感知测试,达到71%的原始准确率
- 论文: SUBESCO PAPER
- 联系人: Sadia Sultana
数据集创建
- 创建目的: 作为Sadia Sultana博士论文项目的一部分
- 开发单位: 沙贾拉尔科技大学计算机科学与工程系
- 资金支持: 沙贾拉尔科技大学
数据集下载
python from datasets import load_dataset
train = load_dataset("sustcsenlp/bn_emotion_speech_corpus", split="train")
命名规范
- 文件命名结构: 性别-说话者编号-说话者姓名-录音单元-单元编号-情感名称-重复编号-文件格式
- 示例: F_02_MONIKA_S_1_NEUTRAL_5.wav
引用信息
@dataset{sadia_sultana_2021_4526477, author = {Sadia Sultana}, title = {SUST Bangla Emotional Speech Corpus (SUBESCO)}, month = feb, year = 2021, publisher = {Zenodo}, version = {version - 1.1}, doi = {10.5281/zenodo.4526477}, url = {https://doi.org/10.5281/zenodo.4526477} }