
遇见数据集

Long-Horizon Office Activity Dataset

收藏
arXiv2026-09-01 更新2026-09-03 收录
官方服务:

资源简介:

该数据集由卡内基梅隆大学等机构创建,旨在为长时程人类活动模拟的行为逼真度评估提供基准。数据集包含43小时多摄像头视频,记录了一间共享办公室中55名人员的自然活动,其中5名核心人员被连续观测数天,每人平均29小时。数据通过11个同步摄像头连续录制一周,经人工标注转化为包含6种活动标签(如使用电脑、交谈、用餐等)的轨迹序列。该数据集用于衡量LLM模拟器在活动级、时段级和日级时间粒度以及个体与群体分析层次上的行为逼真度,揭示了不同条件方法在还原真实行为模式上的差异与局限。

This dataset was developed by Carnegie Mellon University and other institutions to provide a benchmark for behavioral fidelity evaluation in long-duration human activity simulation. It contains 43 hours of multi-camera video footage documenting natural activities of 55 individuals in a shared office, among which 5 core participants were monitored continuously for several days, with an average of 29 hours per person. Recorded over one week using 11 synchronized cameras, the data was manually annotated into trajectory sequences with 6 activity labels, such as using computers, having conversations, dining, and more. This dataset is utilized to assess the behavioral fidelity of LLM simulators across three temporal granularities (activity-level, session-level, and day-level) and two analytical levels (individual and group), uncovering the differences and limitations of different conditional approaches in reproducing real-world behavioral patterns.
创建时间:
2026-09-01
搜集汇总
数据集介绍
Long-Horizon Office Activity Dataset 数据集图片
构建方式
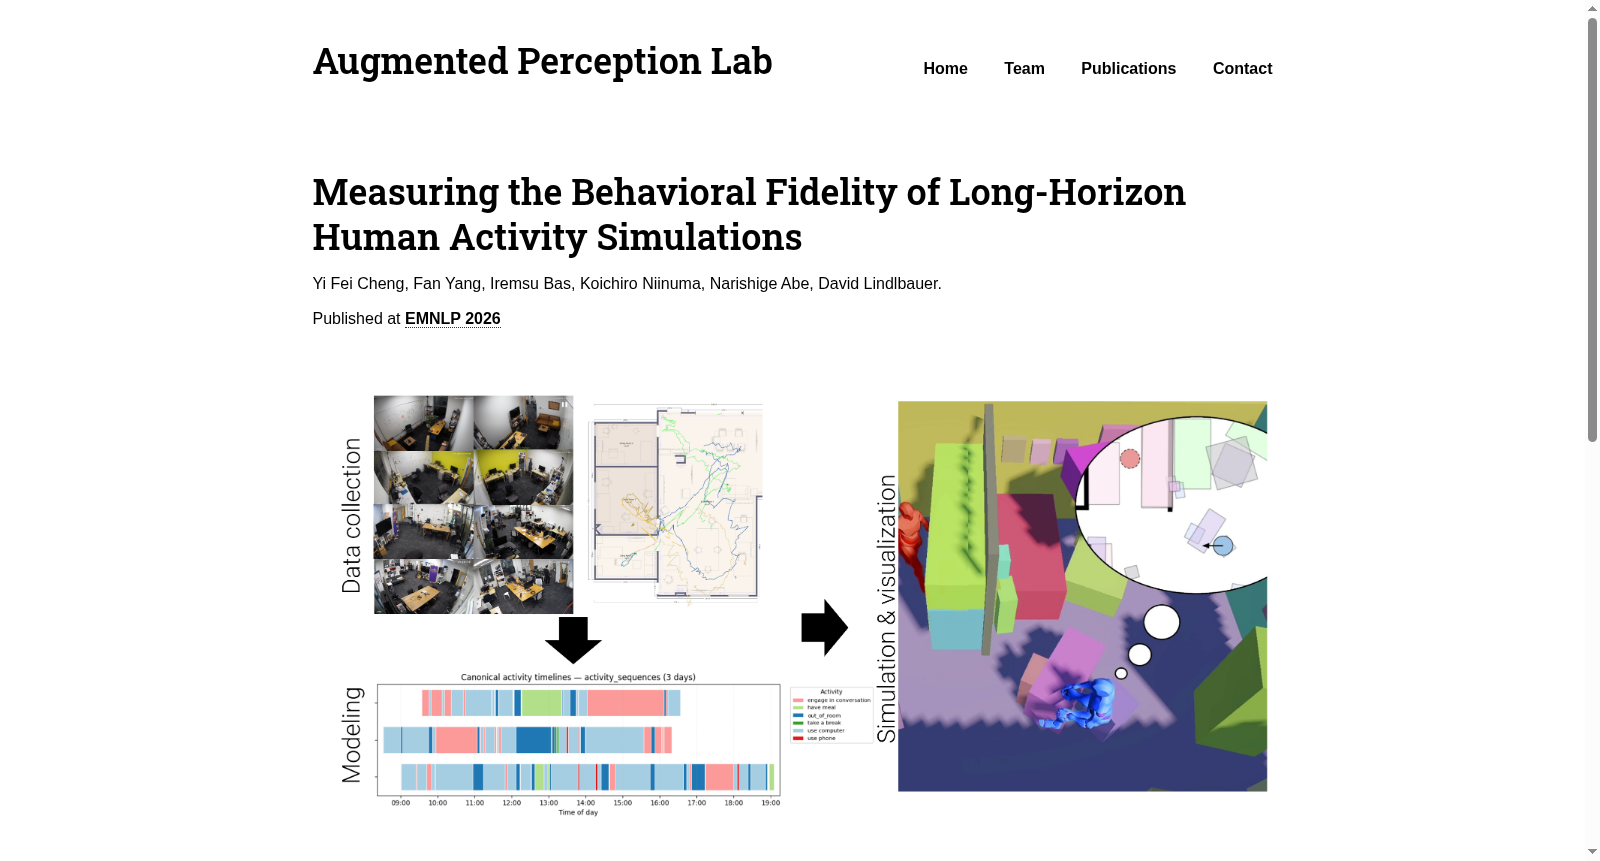
Long-Horizon Office Activity Dataset 的构建依托于一个精心设计的真实办公环境采集流程。研究团队在一间包含开放工作区、共享办公室、灵活会议室及私人办公室的多房间共享办公场所中,部署了11台同步摄像机,连续记录了一个完整工作周的43小时自然状态下的办公活动。为形成结构化的行为标签体系,研究者借鉴既有方法,通过对采样片段进行聚类与合并,归纳出包含使用电脑、参与交谈、用餐、休息、使用手机及离开房间在内的六类活动标签。所有视频数据均经过人工精细标注,并辅以追踪与定位技术,将多视角视频转化为包含匿名个体标识、活动标签、房间位置及二维坐标的逐帧活动序列,最终构建出涵盖55名独特个体、其中5名核心个体拥有多日连续观测轨迹的高质量行为数据集。
使用方法
该数据集的主要用途在于评估基于大型语言模型的长时间跨度人类活动模拟器的行为保真度。研究者可将其作为真实行为参照系,通过对比模拟生成的活动轨迹与数据集中的真实轨迹,系统性地度量模拟行为在时间粒度(活动级别、时段级别、日级别)与分析层级(个体层面、群体层面)上的偏差。具体而言,使用者可基于数据集中个体的行为痕迹构建多种条件化方式,例如作者化人物描述、推断式人物画像、少样本示范或统计先验,并利用数据集中的真实轨迹作为地面真值,计算模拟结果在活动时间分配、频率分布、序列转换及变异性等指标上的差异。该数据集还支持留一法交叉验证,以测试模拟方法对未见会话的泛化能力。其应用范围并不局限于行为模拟评测,亦可拓展至AI辅助设计、工作场所分析及社会计算等领域的基础研究。
背景与挑战
背景概述
随着大语言模型在人类行为模拟领域的广泛应用,其生成的长期活动序列是否忠实再现真实行为模式成为关键问题。现有研究多聚焦于调查问卷或对话场景的行为保真度,而对跨越多小时或多天的开放式真实世界活动模拟尚未系统探索。为此,卡内基梅隆大学人机交互研究所的Yi Fei Cheng等人联合富士通研究团队,于2026年提出了一套评估长期人类活动模拟行为保真度的框架,并采集了长达43小时的多摄像头真实办公场景数据集(Long-Horizon Office Activity Dataset)。该数据集记录了55名办公人员在自然工作状态下的活动轨迹,其中5名核心人员被连续观察多日,为评估模拟代理能否复现真实长期活动模式提供了宝贵基准。这一研究填补了长期活动模拟评估领域的空白,推动了更可靠的人类代理模拟系统的发展。
当前挑战
该数据集所应对的核心挑战在于,长期人类活动模拟的行为保真度并非单一维度的度量,而是存在多层次、多尺度的复杂性。具体而言,评估框架需同时考量时间粒度(局部活动转换、时段分布、全天统计)与分析层级(个体与群体),而现有模拟方法往往顾此失彼:统计先验虽能逼近真实活动分布,却导致活动切换过于频繁、个体日内变异性不足;基于人物角色的条件设置则效果有限且高度依赖所选评估指标。此外,构建此类数据集本身亦面临严峻挑战——需在真实办公环境中进行无脚本、多日连续的多摄像头记录,并手动标注出具有时间完整性的个体活动序列,这不仅涉及繁琐的隐私保护与伦理审批,还要求大量人工参与以保障标注质量,其数据采集成本与稀缺性远超市面上已有的短时段或结构化行为数据集。
常用场景
经典使用场景
该数据集的核心应用在于评估大规模语言模型在模拟长期人类活动时的行为保真度。研究者可借此对不同条件化机制(如基于人物画像、少样本示例、统计先验等)生成的模拟代理行为进行系统性比对,量化其与真实人类活动轨迹在时间分配、活动转换、行为模式等方面的差异。此场景为理解模拟代理能否真实再现人类日常行为提供了一个可复现的基准框架。
解决学术问题
该数据集解决了当前仿真研究中对长期、真实世界行为模拟缺乏客观评估标准的问题。它首次提供了包含43小时多视角录像的开放办公室活动数据,涵盖55名个体的连续活动轨迹,使研究者能够从时间粒度与分析层级两个维度考察模拟的行为保真度。此数据集填补了既有工作在长期行为模拟验证上的空白,为构建高可信度的虚拟人类代理奠定了数据基础。
实际应用
在实际应用层面,该数据集的场景可延伸至智能办公环境的优化、人机协同系统的设计以及社会政策的模拟推演。例如,通过高保真模拟员工在办公室内的活动模式,企业可进行空间规划、资源调度或工作流优化的前瞻性分析。此外,该数据集还可为人工智能辅助系统提供真实行为参照,帮助其更好地理解和预测人类在工作场景中的需求。
数据集最近研究
最新研究方向
随着大语言模型在模拟人类行为方面的应用日益广泛,评估其行为保真度成为关键议题。当前研究前沿聚焦于超越静态问答与对话模拟,向长时间跨度、真实世界活动模拟的保真度评估拓展。Long-Horizon Office Activity Dataset的开创性贡献在于,它利用多摄像头在野捕捉了43小时真实办公活动,构建了包含55名个体、多日连续记录的基准数据集。该数据集支撑了一个系统化评估框架,从时间粒度与个体/群体分析层级两个维度解构行为保真度,并对比了人物档案、少样本示例及统计先验等多种条件化机制。这一研究方向不仅回应了大语言模型作为人类代理的可靠性挑战,更揭示了统计先验在分布对齐上有效却会导致活动碎片化、个体内变异性降低等非一致性保真模式,为构建更可信的社会模拟系统提供了方法论范式和实证基础。
相关研究论文
  • 1
    Measuring the Behavioral Fidelity of Long-Horizon Human Activity Simulations卡内基梅隆大学·人机交互研究所; 富士通株式会社; 富士通美国研究院 · 2026年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

