
vlite23-148M-dataset
收藏官方服务:
资源简介:
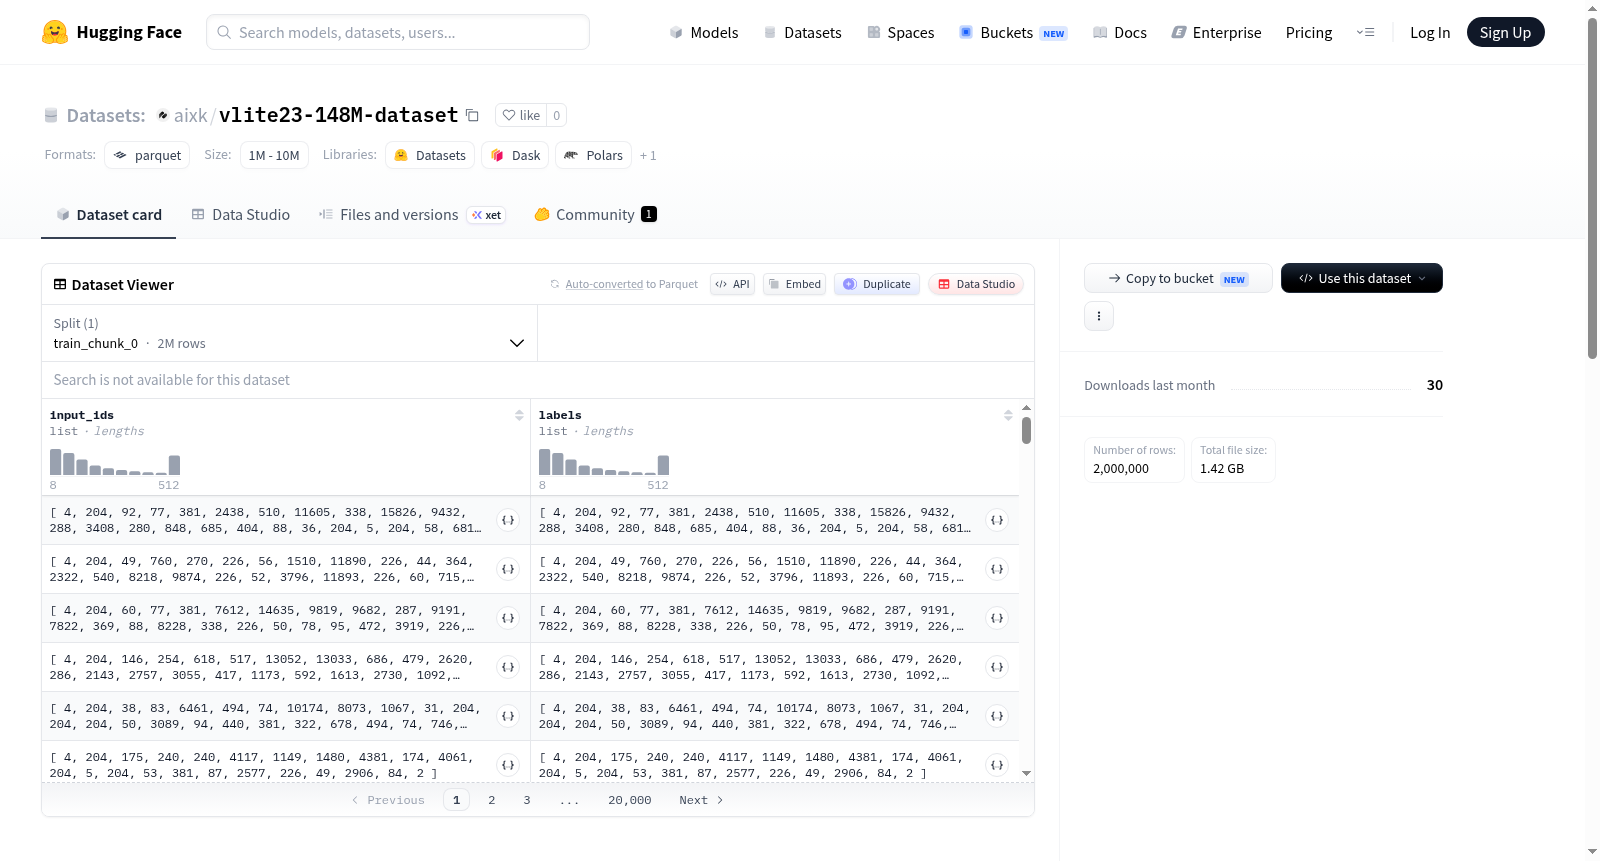
该数据集包含一个名为train_chunk_0的训练数据块,共有2,000,000个样本。每个样本由两个特征组成:input_ids和labels,两者均为int32类型的列表。数据集总大小约为3.24 GB,下载大小约为1.42 GB。
This dataset includes a training data chunk named train_chunk_0 with 2,000,000 samples. Each sample consists of two features: input_ids and labels, both of which are lists of int32 type. The total dataset size is approximately 3.24 GB, and the download size is about 1.42 GB.
创建时间:
2026-06-05
原始信息汇总
数据集概述
数据集名称:vlite23-148M-dataset
数据集地址:https://huggingface.co/datasets/aixk/vlite23-148M-dataset
数据集特征:
- input_ids:类型为
list,元素为int32 - labels:类型为
list,元素为int32
数据集划分:
- train_chunk_0:包含 2,000,000 个样本,数据大小约为 3.24 GB(3,243,624,728 字节)
数据集大小:
- 下载大小:约 1.42 GB(1,419,481,057 字节)
- 数据集总大小:约 3.24 GB(3,243,624,728 字节)
数据集配置:
- 配置名称:
default - 数据文件路径:
data/train_chunk_0-*
搜集汇总
数据集介绍
构建方式
vlite23-148M-dataset 数据集由独立开发者 ISAI 基于大规模文本语料构建而成,专为语言模型的预训练任务设计。数据集以 token 化后的整数序列形式存储,每条样本包含 input_ids 和 labels 两个字段,分别代表输入文本的 token ID 和对应的监督标签。数据被组织为单个分片 train_chunk_0,包含约 200 万个样本,总大小约为 3.24 GB,下载压缩后约为 1.42 GB,便于高效传输与存储。
使用方法
使用 vlite23-148M-dataset 时,可通过 Hugging Face Datasets 库直接加载。指定配置名 default 和分片 train_chunk_0 后,库会自动匹配 data/ 目录下的通配符文件路径。加载后的数据集支持标准的 PyTorch 或 TensorFlow 数据管道,input_ids 可直接作为模型输入,labels 作为计算损失的目标序列。用户也可自定义采样策略或对数据进行 token 级过滤,以适配不同的预训练目标或下游任务微调需求。
背景与挑战
背景概述
在自然语言处理与大规模语言模型迅猛发展的浪潮中,高质量、大规模的训练语料成为推动模型性能跃升的关键基石。vlite23-148M-dataset 由独立开发者 ISAI(이사이)于近期创建,旨在为轻量级语言模型预训练或微调提供结构化的令牌级数据资源。该数据集包含约1.48亿个训练样本,存储为 input_ids 与 labels 对应的序列形式,直接服务于序列到序列或语言建模任务。虽出自个人项目,但其公开释放降低了小型团队与个体研究者获取海量预训练数据的门槛,在推动开源社区中轻量化模型生态方面具有潜在的示范意义,尤其为资源受限环境下的模型开发提供了宝贵的实战素材。
当前挑战
该数据集所面临的挑战首先源于其定位:轻量级预训练场景需兼顾数据规模与训练效率,但1.48亿样本仅以单块分片(train_chunk_0)提供,缺乏多分片或验证集、测试集划分,可能限制模型的泛化评估与迭代优化。数据构建方面,由单一开发者独立完成,数据的来源多样性、清洗标准以及标注一致性均缺乏透明文档与质量审计,潜在噪声与偏倚可能影响下游模型表现。此外,数据集未公开词表或预处理细节,不同框架之间的兼容性重构亦成为用户实际使用时的技术障碍,亟需社区协作以提升其体系完备性与实用价值。
常用场景
经典使用场景
在自然语言处理与大规模语言模型蓬勃发展的浪潮中,高质量、大规模且结构清晰的预训练语料库始终是推动模型性能跃升的基石。vlite23-148M-dataset凭借其包含多达200万个训练样本、总计约32.4亿字节的数据体量,成为语言模型预训练与微调阶段的理想数据资源。经典的使用场景在于为自回归语言模型提供连续的文本序列(input_ids与labels对齐),使得模型能够通过因果语言建模(Causal Language Modeling)任务学习深层的语义表征与语法结构,从而强化其文本生成与理解能力。该数据集的规模与分块设计(train_chunk_0)亦适配分布式训练框架,便于研究者在计算资源受限的环境下高效迭代模型。
解决学术问题
该数据集有效回应了学术研究中长期存在的对大规模、标准化语言预训练数据的需求,尤其是在多语言与低资源场景探索方面。它解决了研究者难以获取海量、未经标注但具备内在语言规律的原始文本序列的困境,为探索无监督表示学习、语言模型泛化边界以及长序列依赖建模提供了坚实的实验基础。其单一分块结构降低了数据预处理的复杂度,使学术团队能够将更多精力聚焦于架构创新与模型分析。意义在于加速了从理论验证到实证研究的转化过程,促进了语言模型训练范式的标准化与可复现性,对理解深度网络中语言知识的涌现机制产生了深远影响。
实际应用
在实际行业应用中,vlite23-148M-dataset为对话系统、智能写作辅助与个性化内容生成等场景提供了直接的训练数据支撑。基于该数据集微调的模型可应用于客户服务聊天机器人,使其在众多领域生成自然流畅的回复;亦可用于辅助写作工具,帮助用户撰写邮件、报告或创意文本,提升生产效率。对于内容推荐与信息摘要系统而言,该数据集训练的模型能够更好理解上下文语义,生成高质量的摘要文本。其所蕴藏的语言模式使得AI产品在中文及特定领域应用中的表现更加精准与人性化,降低了企业从零构建高质量语言模型的入门门槛。
数据集最近研究
最新研究方向
在大型语言模型蓬勃发展的浪潮中,高质量预训练语料的稀缺性日益凸显,尤其对于非英语语系而言,构建大规模、结构化的token序列数据集成为推动模型本土化演进的关键基石。vlite23-148M-dataset作为一项专为语言模型预训练设计的资源,其数据集以input_ids与labels的键值对形式组织,承载了约1.48亿个token的序列化信息,并以2百万样本的规模分块存储。这一前沿研究方向聚焦于为小型或特定领域的语言模型提供高效的训练素材,回应了当前业界对轻量化、可定制化语言模型日益增长的需求。通过提供标准化、预处理的序列数据,该数据集不仅降低了从零开始构建训练管线的技术门槛,更在推动人工智能民主化进程中扮演了赋能者的角色,为独立开发者与学术实验室探索更丰富、更经济的模型微调与压缩策略铺平了道路。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


