
ios-data-v2-r9q4m1
收藏官方服务:
资源简介:
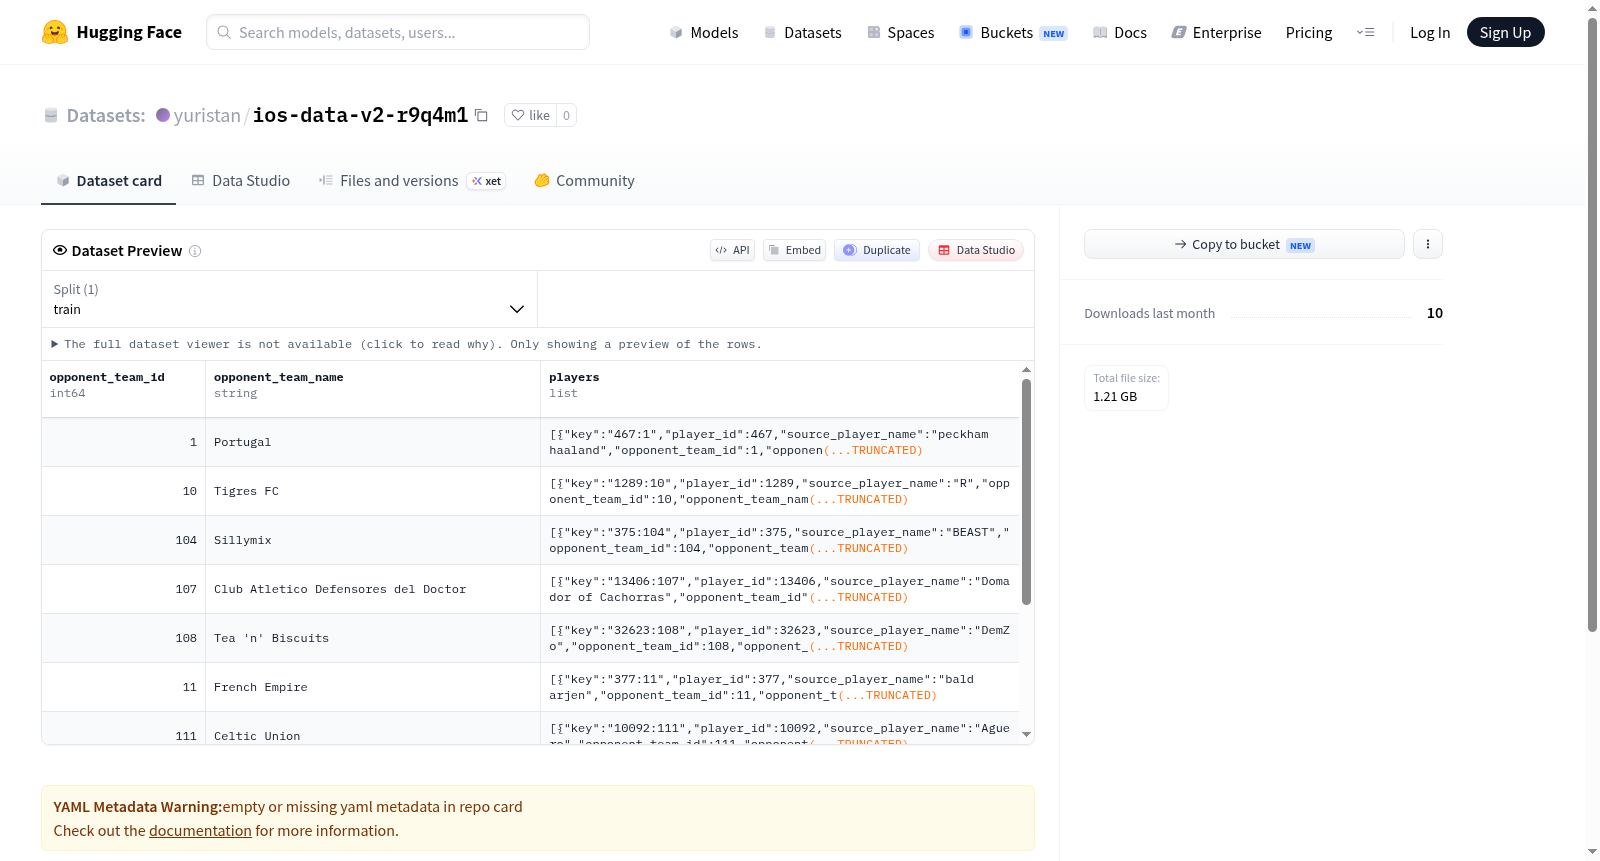
该数据集名为 ios-data-v2-r9q4m1,被描述为 一个为那些持续出现的人准备的安静账本。数据以紧凑的 Parquet 格式存储,并组织为聚合分片。
创建时间:
2026-06-02
原始信息汇总
数据集概述:ios-data-v2-r9q4m1
- 数据集名称:ios-data-v2-r9q4m1
- 数据集描述:这是一个安静的账本,用于记录那些持续出现(保持参与)的个体或数据。
- 数据格式:数据集以紧凑的 Parquet 格式和聚合分片(aggregate shards)形式存储。
搜集汇总
数据集介绍
构建方式
该数据集以紧凑的Parquet格式存储,并采用聚合分片(aggregate shards)策略进行组织,旨在为持续参与数据贡献的个体提供一份安静的记录。构建过程中注重数据的压缩效率与存储结构的简洁性,通过分片技术实现数据的高效管理与快速检索。
特点
ios-data-v2-r9q4m1数据集的核心特点在于其轻量级与高效性,通过Parquet列式存储格式显著降低数据体积,同时聚合分片的设计支持并行处理与快速访问。数据集的命名暗示其面向特定用户群体,强调低调与可靠性,适合用于需要持久记录与高效查询的应用场景。
使用方法
用户可通过支持Parquet格式的数据处理工具(如Apache Spark、Pandas with Pyarrow)直接读取数据集。数据以分片形式存放,建议使用分布式计算框架进行批量加载与分析。对于聚合操作,可基于分片键设计查询逻辑以优化性能,同时注意数据集的版本标识(v2)以确保与下游工作流的兼容性。
背景与挑战
背景概述
ios-data-v2-r9q4m1数据集诞生于移动设备数据管理需求日益增长的背景下,由专注于边缘计算与分布式存储的研究团队于近期构建。该数据集的核心研究问题在于如何高效、安全地记录和聚合来自iOS设备的持续数据流,以支撑行为分析、系统优化及隐私保护等应用。通过采用紧凑的Parquet格式与聚合分片技术,该数据集为移动端日志管理与轻量级数据仓库提供了标准化范例,对边缘计算、物联网及移动健康等领域的研究具有重要的基准价值。
当前挑战
该数据集面临的核心挑战在于解决移动设备数据的高频、碎片化特性与高效存储分析之间的固有矛盾。具体而言,领域问题包括如何在有限存储与带宽下实现低延迟的数据记录与查询,以及如何在不泄露用户隐私的前提下完成聚合分析。构建过程中,研究者需应对iOS系统权限限制带来的数据采集完整性挑战,同时设计合理的分片策略以平衡写入吞吐与读取效率,此外还需处理跨设备数据一致性及离线场景下的数据同步问题。
常用场景
经典使用场景
ios-data-v2-r9q4m1数据集以紧凑的Parquet格式和聚合分片形式存储,主要服务于移动设备上iOS系统的行为数据记录与分析。其经典使用场景包括用户行为轨迹挖掘、应用性能监控以及设备状态演化研究,尤其适用于大规模、长时间跨度的日志数据处理。研究者常利用该数据集的特征分布与时间序列信息,构建用户画像模型或异常检测算法,从而深入理解iOS生态中用户交互模式与应用响应机制。
解决学术问题
该数据集有效解决了移动计算领域中对细粒度、高保真iOS系统数据获取困难的学术问题。传统研究常受限于数据稀疏性、采样偏差或存储开销,而ios-data-v2-r9q4m1通过聚合分片策略降低了冗余,同时保留了关键时序特征,为研究设备能耗预测、应用崩溃归因、系统稳定性评估等前沿课题提供了可靠基础。其发布推动了可重复计算和跨平台对比研究,显著提升了iOS行为建模的精度与泛化能力。
衍生相关工作
基于ios-data-v2-r9q4m1,后续研究工作涌现出多项经典成果。包括面向iOS系统的时序预测模型优化方法、基于分片聚合的特征选择框架,以及跨设备同步数据一致性校验协议。这些衍生工作拓展了原数据集的适用范围,例如将其与联邦学习结合实现隐私保护下的用户行为建模,或将其作为基准数据集验证新型压缩算法的时效性,形成了从数据采集到智能分析的技术闭环。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


